2025“钉耙编程”中国大学生算法设计暑期联赛(3)(2025杭电多校 3)——1009线段染色 · znzryb
## **1009线段染色**
[2025“钉耙编程”中国大学生算法设计暑期联赛(3)](/2025/07/25/20250725-a35ed8c4)
[https://acm.hdu.edu.cn/contest/problem?cid=1174&pid=1009](https://acm.hdu.edu.cn/contest/problem?cid=1174&pid=1009)
[https://vjudge.net/problem/HDU-8011](https://vjudge.net/problem/HDU-8011)
又是沟槽的概率题目。
感觉不是我能碰瓷的题目,之后有兴趣了再来看吧。
[https://grok.com/chat/dc6a06d2-50d6-4bb8-a88b-87a1c553307d](https://grok.com/chat/dc6a06d2-50d6-4bb8-a88b-87a1c553307d)
::: AI代码
```cpp
#include <bits/stdc++.h>
using namespace std;
typedef long long ll;
const int MOD = 1000000007; // 定义模数 10^9 + 7
const int MAXN = 200010; // 定义最大 n 值
// 计算 a^b % mod 的快速幂函数
ll powmod(ll a, ll b, ll mod) {
ll res = 1;
a %= mod;
for (; b; b >>= 1) {
if (b & 1) res = res * a % mod;
a = a * a % mod;
}
return res;
}
// Fenwick Tree (Binary Indexed Tree) 类,用于前缀和查询与更新
class Fenwick {
public:
vector<ll> tree; // 树数组
int n; // 大小
Fenwick(int _n) : n(_n), tree(_n + 2, 0) {} // 构造函数
// 更新索引 idx 处的值,增加 val
void update(int idx, ll val) {
idx++;
while (idx <= n + 1) {
tree[idx] = (tree[idx] + val) % MOD;
idx += idx & -idx;
}
}
// 查询前 idx 个元素的和
ll query(int idx) {
idx++;
ll sum = 0;
while (idx > 0) {
sum = (sum + tree[idx]) % MOD;
idx -= idx & -idx;
}
return sum;
}
// 查询 [l, r] 范围的和
ll query(int l, int r) {
if (l > r) return 0;
return (query(r) - query(l - 1) + MOD) % MOD;
}
};
// 线段树类,用于查询范围最大值
class SegMax {
public:
vector<int> tree; // 树数组
int n; // 大小
SegMax(int _n) : n(_n), tree(4 * _n + 10, 0) {} // 构造函数
// 构建线段树
void build(int node, int start, int end, const vector<int>& a) {
if (start == end) {
tree[node] = a[start];
return;
}
int mid = (start + end) / 2;
build(2 * node, start, mid, a);
build(2 * node + 1, mid + 1, end, a);
tree[node] = max(tree[2 * node], tree[2 * node + 1]);
}
// 查询 [l, r] 范围的最大值
int query(int node, int start, int end, int l, int r) {
if (r < start || end < l) return -1;
if (l <= start && end <= r) return tree[node];
int mid = (start + end) / 2;
int p1 = query(2 * node, start, mid, l, r);
int p2 = query(2 * node + 1, mid + 1, end, l, r);
if (p1 == -1) return p2;
if (p2 == -1) return p1;
return max(p1, p2);
}
};
int main() {
ios::sync_with_stdio(false); // 加速输入输出
cin.tie(0); // 解除 cin 和 cout 的绑定
int t;
cin >> t; // 阅读测试用例数
for (int cas = 0; cas < t; ++cas) { // 循环处理每个测试用例
int n, m;
cin >> n >> m; // 阅读 n 和 m
vector<int> a(n + 1); // 存储每个点的 a_i
for (int i = 1; i <= n; ++i) cin >> a[i]; // 阅读 a 序列
SegMax sm(n); // 创建线段树实例
sm.build(1, 1, n, a); // 构建线段树
vector<int> M(n + 1, -1); // M[r] 存储以 r 为右端点的线段的最大左端点
int maxl = 0; // 所有线段的最大左端点
bool iszero = false; // 标记是否有线段无法被染色(所有点 a_i=0)
for (int i = 0; i < m; ++i) { // 阅读 m 条线段
int l, r;
cin >> l >> r;
M[r] = max(M[r], l); // 更新 M[r]
maxl = max(maxl, l); // 更新 maxl
if (sm.query(1, 1, n, l, r) == 0) iszero = true; // 检查线段是否全为 0
}
if (iszero) { // 如果有线段无法染色,输出 0
cout << 0 << '\n';
continue;
}
vector<int> last_forced(n + 1, 0); // last_forced[i] 是 1 到 i 的最后一个 a_k=10 的位置
for (int i = 1; i <= n; ++i) {
if (a[i] == 10) last_forced[i] = i;
else last_forced[i] = last_forced[i - 1];
}
vector<ll> Q(n + 1, 1); // Q[i] 是从 last_forced[i]+1 到 i 的 (10 - a_k) 乘积
Q[0] = 1; // 初始化 Q[0]
for (int i = 1; i <= n; ++i) {
if (a[i] == 10) Q[i] = 1; // 如果 a[i]=10,重置为 1
else Q[i] = Q[i - 1] * (10LL - a[i]) % MOD; // 否则累乘 (10 - a[i])
}
vector<ll> DP(n + 1, 0); // DP[i] 是以 i 为最后一个染色点的有效配置权重
DP[0] = 1; // 初始化 DP[0]=1
Fenwick ft(n); // 创建 Fenwick Tree 实例
ll val = DP[0] * powmod(Q[0], MOD - 2, MOD) % MOD; // 计算 DP[0]/Q[0]
ft.update(0, val); // 更新到 Fenwick Tree
ll run = -1; // run 是当前的最大左端点约束
for (int i = 1; i <= n; ++i) { // 循环计算每个 i 的 DP
run = max(run, (ll)M[i - 1]); // 更新 run
int mj_seg = max(0LL, run); // 线段约束的最小 j
int mj = max(mj_seg, last_forced[i - 1]); // 总体最小 j(考虑强制点)
ll qsum = ft.query(mj, i - 1); // 查询 sum (DP[j]/Q[j])
ll temp = qsum * Q[i - 1] % MOD; // 乘以 Q[i-1] 得到 sum DP[j] * prod(j+1 to i-1)
DP[i] = (ll)a[i] * temp % MOD; // 计算 DP[i]
val = DP[i] * powmod(Q[i], MOD - 2, MOD) % MOD; // 计算 DP[i]/Q[i]
ft.update(i, val); // 更新到 Fenwick Tree
}
vector<ll> S(n + 2, 1); // S[i] 是从 i 到 n 的 (10 - a_k) 乘积
for (int i = n; i >= 1; --i) {
S[i] = S[i + 1] * (10LL - a[i]) % MOD; // 后缀乘积
}
ll numer = 0; // 分子:所有有效配置的权重
for (int i = 0; i <= n; ++i) {
if (i >= maxl) { // 如果 i >= maxl,可以作为最后一个染色点
numer = (numer + DP[i] * S[i + 1] % MOD) % MOD; // 累加 DP[i] * S[i+1]
}
}
ll inv10 = powmod(10LL, MOD - 2, MOD); // 10 的逆元
ll inv10n = powmod(inv10, n, MOD); // 10^n 的逆元
ll ans = numer * inv10n % MOD; // 最终答案 = numer / 10^n % MOD
cout << ans << '\n'; // 输出答案
}
return 0;
}
```
:::
## 题目大意
**题意简述**
在一个长度为 $n$ 的数轴上(包含整点 $1 \sim n$),给出了 $m$ 条线段,第 $i$ 条线段覆盖区间 $[l_i, r_i]$。
针对数轴上的每个整点 $i$,进行一次独立的染色操作,染色的成功率为 $p_i = \frac{a_i}{10}$。
定义一条线段被染色,当且仅当该线段覆盖的整点中至少有一个被染色。
求**所有**给定的 $m$ 条线段都被染色的概率。
**输入格式**
第一行包含一个整数 $t$,表示测试数据组数。
对于每组数据:
1. 第一行两个整数 $n, m$,分别表示数轴长度和线段数量。
1. 第二行 $n$ 个整数 $a_1, a_2, \dots, a_n$,表示每个点的染色概率参数($p_i = a_i/10$)。
1. 接下来 $m$ 行,每行两个整数 $l_i, r_i$,表示一条线段的左右端点。
**输出格式**
输出一个整数,表示概率对 $10^9+7$ 取模后的结果。
**数据范围**
- $1 \le t \le 5 \times 10^4$
- $1 \le n \le 2 \times 10^5, 0 \le m \le 2 \times 10^5$
- $\sum n, \sum m \le 2.5 \times 10^6$
- $0 \le a_i \le 10$
**样例**
```
6
4 2
5 5 5 5
2 3
3 4
4 2
5 5 5 5
2 2
3 4
1 0
3
4 1
0 2 3 4
2 4
4 2
5 0 5 5
1 3
2 4
4 3
1 1 1 0
2 4
3 4
4 4
```
**样例输出**
```
625000005
375000003
1
48000001
625000005
0
```
**样例解释**
**第一组数据:**
- $n=4$,所有点染色概率均为 $0.5$。
- 线段为 $[2, 3]$ 和 $[3, 4]$。
- 要使两条线段都被染色,需满足:(点2被染 或 点3被染) 且 (点3被染 或 点4被染)。
- 情况分类:
1. 点3被染(概率 $0.5$):此时两条线段都已满足条件。
1. 点3未被染(概率 $0.5$):此时必须点2被染(概率 $0.5$)且点4被染(概率 $0.5$),概率为 $0.5 \times 0.5 \times 0.5 = 0.125$。
- 总概率 $= 0.5 + 0.125 = 0.625 = \frac{5}{8}$。
- $\frac{5}{8} \pmod{10^9+7} = 625000005$。
**第二组数据:**
- 线段为 $[2, 2]$ 和 $[3, 4]$。
- 线段1仅包含点2,必须点2被染(概率 $0.5$)。
- 线段2包含点3, 4,需至少一个被染,概率为 $1 - (1-0.5)\times(1-0.5) = 0.75$。
- 两者独立,总概率 $= 0.5 \times 0.75 = 0.375 = \frac{3}{8}$。
## 思路讲解
我们重新回来看这道题目啊,重新回来看一下这道题目。
::: AI 提示 1
这是一个很好的问题,我来认真分析一下。
## 直接回答:对这道题来说,很难再靠更强的数据结构降低思维难度了
原因是:**这道题的思维瓶颈在 DP 的建模,而不在 DP 的优化**。数据结构能帮你优化已有的转移(比如把 $O(n^2)$ 变成 $O(n \log n)$),但不能替代"发现 DP 怎么定义"这一步。
## 为什么?来看这道题的思维结构
这道题的核心洞察只有一个:
> 枚举"上一个被染色的位置 $j$",那么 $(j, i)$ 之间不能完整包含任何线段。
一旦有了这个洞察,就能定义:
$$
dp_i = p_i \cdot \sum_{j = F(i)}^{i-1} dp_j \cdot \prod_{k=j+1}^{i-1} q_k
$$
其中 $F(i) = \max\{l_s : r_s < i\}$,是所有右端点在 $i$ 左边的线段中,最大的左端点。
**关键**:$F(i)$ 天然单调不减(随着 $i$ 增大,参与取 $\max$ 的线段只多不少),所以转移的求和下界单调右移——这是一个**滑动窗口**。
数据结构(线段树/BIT)的作用是:如果你没注意到"前缀积可以提出来、然后滑动窗口"这件事,你可以用线段树做"区间乘 $q_i$ + 单点插入 + 区间求和"来暴力维护转移,省去这一步推导。
但"枚举上一个染色位置"这一步,**没有任何数据结构能替你想**。这就像斜率优化 DP 里——你可以用李超线段树替代手动维护凸包(降低了"维护凸包"的思维),但"发现 DP 具有斜率优化结构"这一步,李超树帮不了你。
## 其实这道题比你想的简单:不需要线段树
这道题甚至不需要线段树。令 $f(j) = dp_j \big/ \prod_{k=1}^{j} q_k$,代入得:
$$
dp_i = p_i \cdot \prod_{k=1}^{i-1} q_k \cdot \sum_{j=F(i)}^{i-1} f(j)
$$
$F(i)$ 单调不减,所以 $\sum f(j)$ 就是一个**滑动窗口求和**,双指针维护即可。
整个算法:
1. 对每个线段 $[l, r]$,标记 `bestL[r] = max(bestL[r], l)`。
1. 扫一遍算出 $F[i] = \max(F[i-1],\ \text{bestL}[i-1])$。
1. 滑动窗口跑 DP。
1. 答案 = $\sum_{i \ge \text{maxL}} dp_i \cdot \prod_{k=i+1}^{n} q_k$。
时间复杂度 $O(n + m)$,不需要任何复杂数据结构。
唯一需要特判的是 $q_k = 0$(即 $a_k = 10$,点 $k$ 必然被染色)的情况——此时前缀积为零,不能除。解决方式是在这些点处"重置"前缀积的基准。
## 什么时候"更强数据结构"真的能降低思维?
你说的这种思想确实有适用的场景,比如:
| 场景 | "聪明做法"(思维重) | "数据结构做法"(思维轻) |
| --- | --- | --- |
| 斜率优化 DP | 手维护凸包 + 单调性分析 | 李超线段树直接维护 |
| 树上路径问题 | 点分治 / 各种分讨 | LCT / 树链剖分 |
| 区间历史操作 | 复杂的势能分析 | 吉司机线段树(Segment Tree Beats) |
| 带修 DP | 重新推导转移 | 线段树维护转移矩阵(动态 DP) |
但这些场景的共同点是:**瓶颈在"优化/维护"而非"建模"**。如果一道题的瓶颈在于"如何定义状态和转移",那数据结构是无能为力的。
本题恰好属于后者。
## 如果这道题加了修改操作……
如果题目变成"每次修改一个 $a_i$,查询当前的概率",那就可以用**动态 DP**(线段树维护转移矩阵)来做——这确实是"更厉害的数据结构技巧"。但原题没有修改,所以用不上。
---
**总结**:你的直觉(用强数据结构换思维难度)是对的策略,但这道题的瓶颈不在数据结构能解决的层面。好消息是,一旦你掌握了"枚举上一个染色位置 + $F(i)$ 单调 → 滑动窗口"这个 pattern,以后类似的一维覆盖概率题都可以秒。这是**经验/模板的力量**,比数据结构更靠谱。
:::
::: AI 提示 2
好,我给你几层递进的提示,你自己想到哪一层算哪一层。
**提示一(最基本的观察)**
如果你把所有**被染色的点**从左到右排成一列 $c_1 < c_2 < \cdots < c_t$,那么"所有线段都被满足"这个条件,本质上是在约束**相邻染色点之间的空隙**。想想看:两个相邻染色点 $c_k$ 和 $c_{k+1}$ 之间的"空白区域"$(c_k,\, c_{k+1})$ 不能怎么样?
**提示二(DP 状态)**
如果你意识到了"空隙不能完整包含任何线段",那么自然可以设计 DP:从左到右枚举"下一个被染色的点 $i$",上一个被染色的点是 $j$。转移的合法性只取决于 $j$ 的值——$j$ 必须 $\ge$ 某个下界。这个下界是什么?它跟哪些线段有关?
**提示三(下界的单调性)**
定义 $F(i)$ 为"所有右端点严格小于 $i$ 的线段中,左端点的最大值"。想一想:为什么 $F(i)$ 关于 $i$ 是单调不减的?这个单调性意味着什么?
**提示四(优化方向)**
如果你已经写出了转移式:
$$
dp_i = p_i \cdot \sum_{j=F(i)}^{i-1} dp_j \cdot \prod_{k=j+1}^{i-1} q_k
$$
现在的问题是怎么快速算这个求和。你有两条路:
- **路线 A(数据结构)**:观察一下,当 $i$ 递增到 $i+1$ 时,已有的每个 $dp_j \cdot \prod q_k$ 项会发生什么变化?只是被乘上了一个 $q_i$。所以你需要一个支持**区间乘、单点修改、区间求和**的数据结构。
- **路线 B(代数化简)**:试试令 $f(j) = dp_j \big/ \prod_{k=1}^{j} q_k$,代入转移式看看会发生什么。结合 $F(i)$ 的单调性,你会发现一个非常简洁的结构。
**提示五(特殊情况)**
如果某个点 $k$ 满足 $a_k = 10$(即 $q_k = 0$,必然被染色),你的"除以前缀积"会出问题。想想这种点在物理意义上意味着什么,以及它如何把问题切成独立的段。
:::
这 AI 提示二搁这乱写的,这数轴上的每一个点都是染色点,哪来的不染色点啊?那属于搞笑来了,卧槽。
::: AI 提示 3
你先别急,我觉得这里可能有个术语上的误解,我重新把关键点说清楚。
题目说的是:"整点 $i$ **被染色的成功率**为 $p_i$"。也就是说,每个点进行染色操作后,有两种结果:
- **染色成功**(概率 $p_i$)
- **染色失败**(概率 $q_i = 1 - p_i$)
比如样例六,$a = [1, 1, 1, 0]$,第四个点 $a_4 = 0$,意味着 $p_4 = 0$,第四个点**必定染色失败**。而线段 $[4, 4]$ 要求第四个点染色成功,所以答案为 $0$。
所以 $n$ 个点中,**并非每个点都会染色成功**。最终染色成功的点是一个随机子集。我之前说的"染色点"指的就是"染色成功的点",表述上确实不够清晰,这里道歉。
重新用明确的语言给提示:
**提示一**
考虑最终的随机结果:$n$ 个点中,有些染色成功,有些染色失败。把所有**染色成功的点**从左到右记为 $c_1 < c_2 < \cdots < c_t$。那么"所有线段都被满足"等价于:每条线段 $[l_s, r_s]$ 内至少包含一个染色成功的点。
反过来想:如果两个**相邻的**染色成功点 $c_k$ 和 $c_{k+1}$ 之间有一段空白 $(c_k, c_{k+1})$,这段空白里的点**全部染色失败**。如果某条线段完整地落在这个空白里,那它就没有任何染色成功的点——这条线段就不满足条件。
**提示二**
基于提示一,可以设计 DP:设 $dp_i$ 表示"位置 $i$ 染色成功,且所有右端点 $\le i$ 的线段都被满足"的概率贡献。转移时枚举上一个染色成功的位置 $j$,中间 $j+1, \dots, i-1$ 全部染色失败。
**提示三**
转移的合法条件:$(j, i)$ 这段空白里不能完整包含任何线段。定义:
$$
F(i) = \max\{l_s : r_s < i\}
$$
即"右端点在 $i$ 左边的线段中,左端点最大的那个"。那么 $j$ 必须满足 $j \ge F(i)$。
$F(i)$ 是单调不减的——想想为什么。
**提示四**
写出转移式后,观察求和的结构。$F(i)$ 单调不减意味着求和的左界在右移,这是一个滑动窗口。结合前缀积的技巧,可以做到 $O(n + m)$。或者用线段树维护"区间乘 + 区间求和"做到 $O(n \log n)$,不需要想前缀积除法的细节。
:::
OK,我大概看懂了这个 AI 提示3了。这 AI 提示2属于是哈哈哈省略的有些过多了。啊,如果你要看 AI 提示的话,可以直接看这个 AI 提示3。嗯。
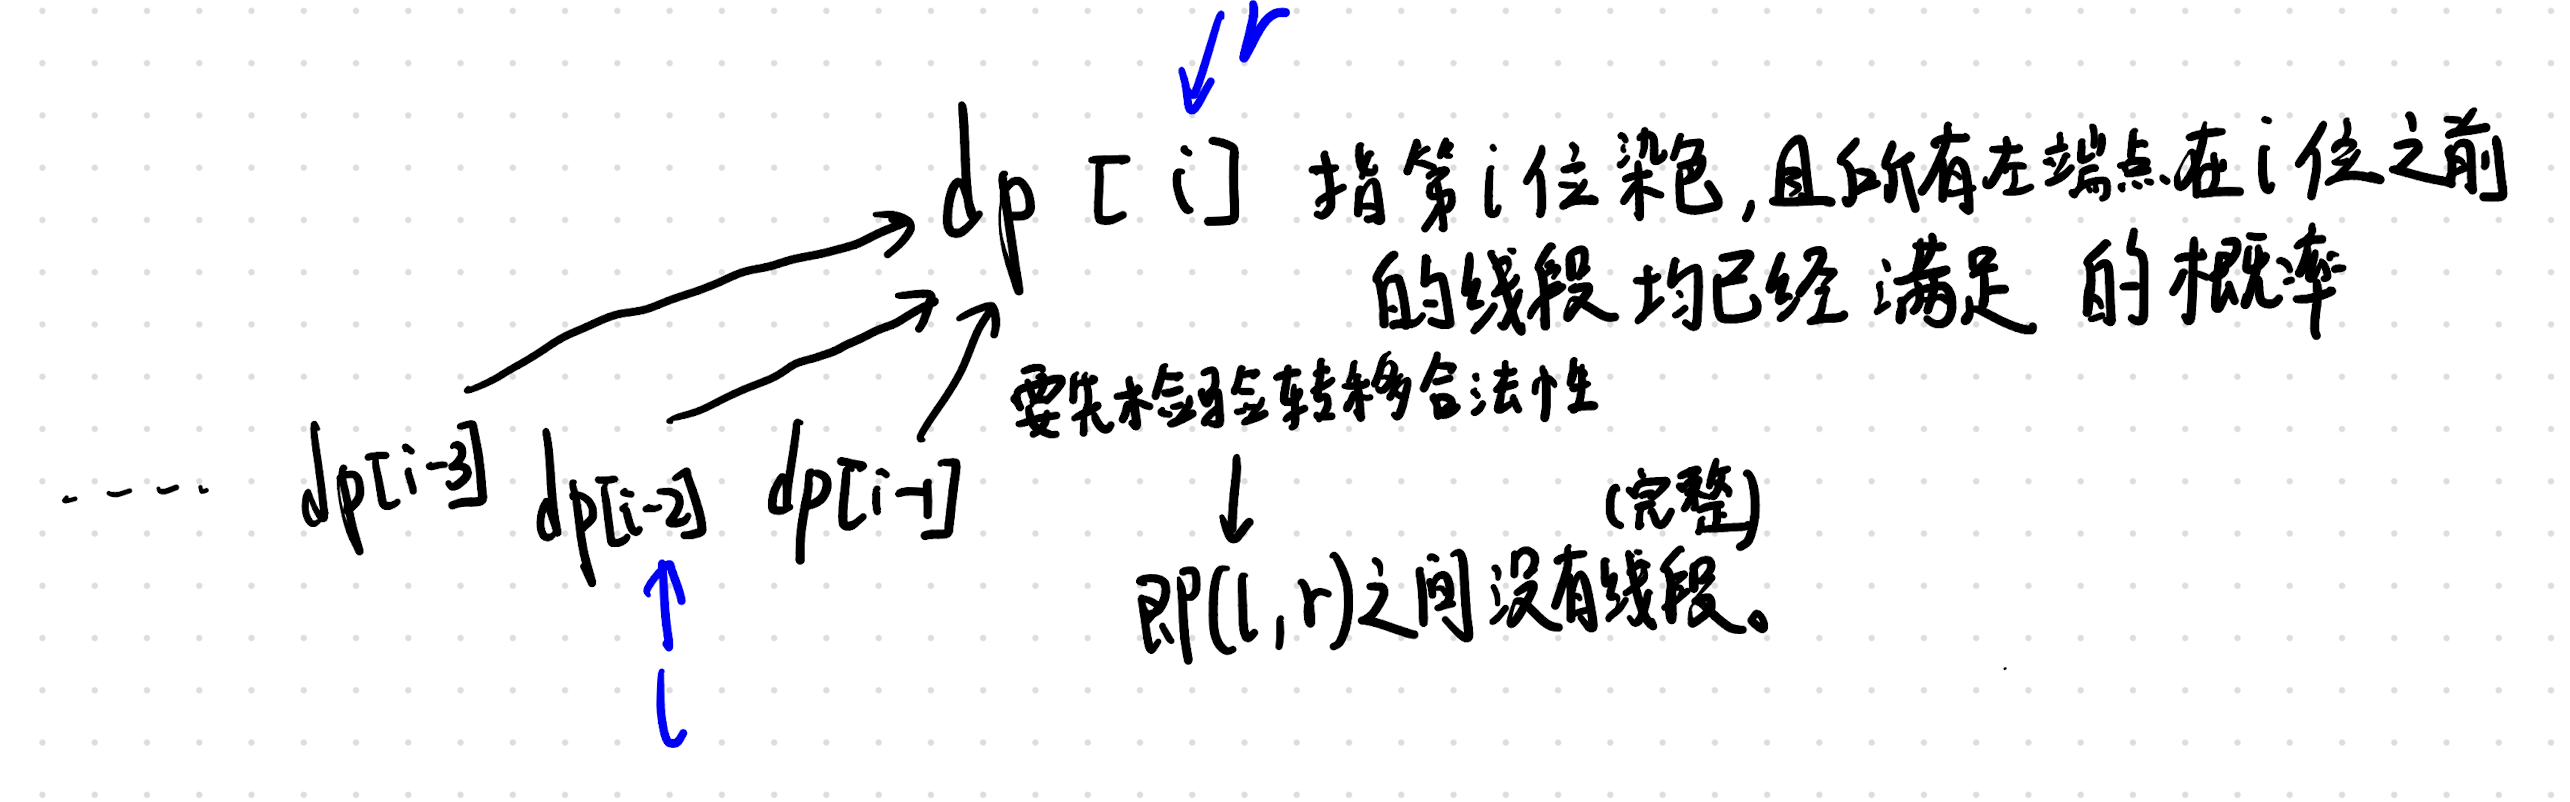
应该是如上图这个意思啊,我们先尝试一下能不能实现一下。因为这个转移合法性是具有单调性的。就是说,如果说这个 LR 不符合要求的话,那么更小的 L 是更加不可能符合要求的。那么这个还是非常容易就可以找到的。
啊,然后你按照这个思路写了一个 DP 程序以后,现在问题就是答案到底是什么?我们会发现答案不是 DP[N] 啊,答案不是 DP[N] 那怎么答案从何而来?答案是什么?现在的问题是这个。
::: AI 纠错提示(我也加了一些注解)
你的代码有三个问题,核心都是同一件事的不同表现。
我们最大的问题是少考虑了虚拟起点0。**说白了,它可以从 0 转移过来**。还有一个地方就是**它转移过来的中间那一段,它不能够被染色**。
**问题一:转移少乘了一坨东西**
你写的转移是:
```
dp[i] = p_i × Σ dp[j] (j 从 F(i) 到 i-1)
```
但正确的转移是:
$$
dp_i = p_i \times \sum_{j=F(i)}^{i-1} (dp_j \times \prod_{k=j+1}^{i-1} q_k)
$$
那个 $\prod q_k$ 是什么意思?$dp_j$ 说的是"$j$ 是上一个染色成功的点",那 $j+1, j+2, \dots, i-1$ 这些点就**必须全部染色失败**,概率是 $\prod_{k=j+1}^{i-1} q_k$。你把这个因子整个漏了。(我给 AI 的这个式子加了个括号,避免你理解错了。)
拿样例一来说,$n=4$,全部 $p = q = 1/2$,线段 $[2,3]$ 和 $[3,4]$:
- 你的代码算 $dp_1 = 1/2$,$dp_2 = 1/2 \times dp_1 = 1/4$
- 正确的是 $dp_2 = p_2 \times (dp_0 \times q_1 + dp_1 \times 1) = 1/2 \times (1/2 + 1/2) = 1/2$
差别就在于 $dp_0 \times q_1$ 这项:从虚拟起点 $0$ 到位置 $2$,中间位置 $1$ 必须染色失败,要乘 $q_1$。
**问题二:没有虚拟起点** $dp_0 = 1$
位置 $i$ 可以是**第一个**染色成功的点,前面全部失败。这对应从一个虚拟的位置 $0$ 转移过来,$dp_0 = 1$。你的二分从 `l=1` 开始,完全没考虑 $j=0$ 这种情况。
**问题三:答案不是** $dp_N$
最右边的染色成功点不一定是 $N$。比如 $N = 4$,可能点 $3$ 染色成功、点 $4$ 染色失败,只要所有线段都被覆盖了就行。正确答案是:
$$
\text{ans} = \sum_{i \ge \text{maxL}} dp_i \times \prod_{k=i+1}^{N} q_k
$$
就是枚举"最右边的染色成功点是谁",后面的点全部失败。
---
这三个问题本质是一回事:你的 DP 把"中间点必须染色失败"这个概率因子完全忽略了。一旦补上这个因子,BIT 里就不能直接存 $dp_j$ 了(因为 $\prod q_k$ 依赖于查询时的 $i$),所以要么改存 $f(j) = dp_j / \text{前缀积}$,要么换成带懒标记的线段树做区间乘。这就是为什么改动面积不可避免地大。
:::
我们最大的问题是少考虑了虚拟起点0。**说白了,它可以从 0 转移过来**。还有一个地方就是**它转移过来的中间那一段,它不能够被染色**。因此需要乘上一个不被染色因数。说白了就是计算一下中间那一段它的这个乘积嘛。
$$
dp_i = p_i \times \sum_{j=F(i)}^{i-1} (dp_j \times \prod_{k=j+1}^{i-1} q_k)
$$
后面的这一坨乘积其实不好求啊,不是很好求,因为对于每一个 DP【 j 】来说,它的这个乘积的项数是不一样的。哎,不过我们可以采用类似于维护区间和区间修改的树状数组一样。这个可能说的有点抽象。
我们使用 iPad 画图来说明一下我们的这个意思。
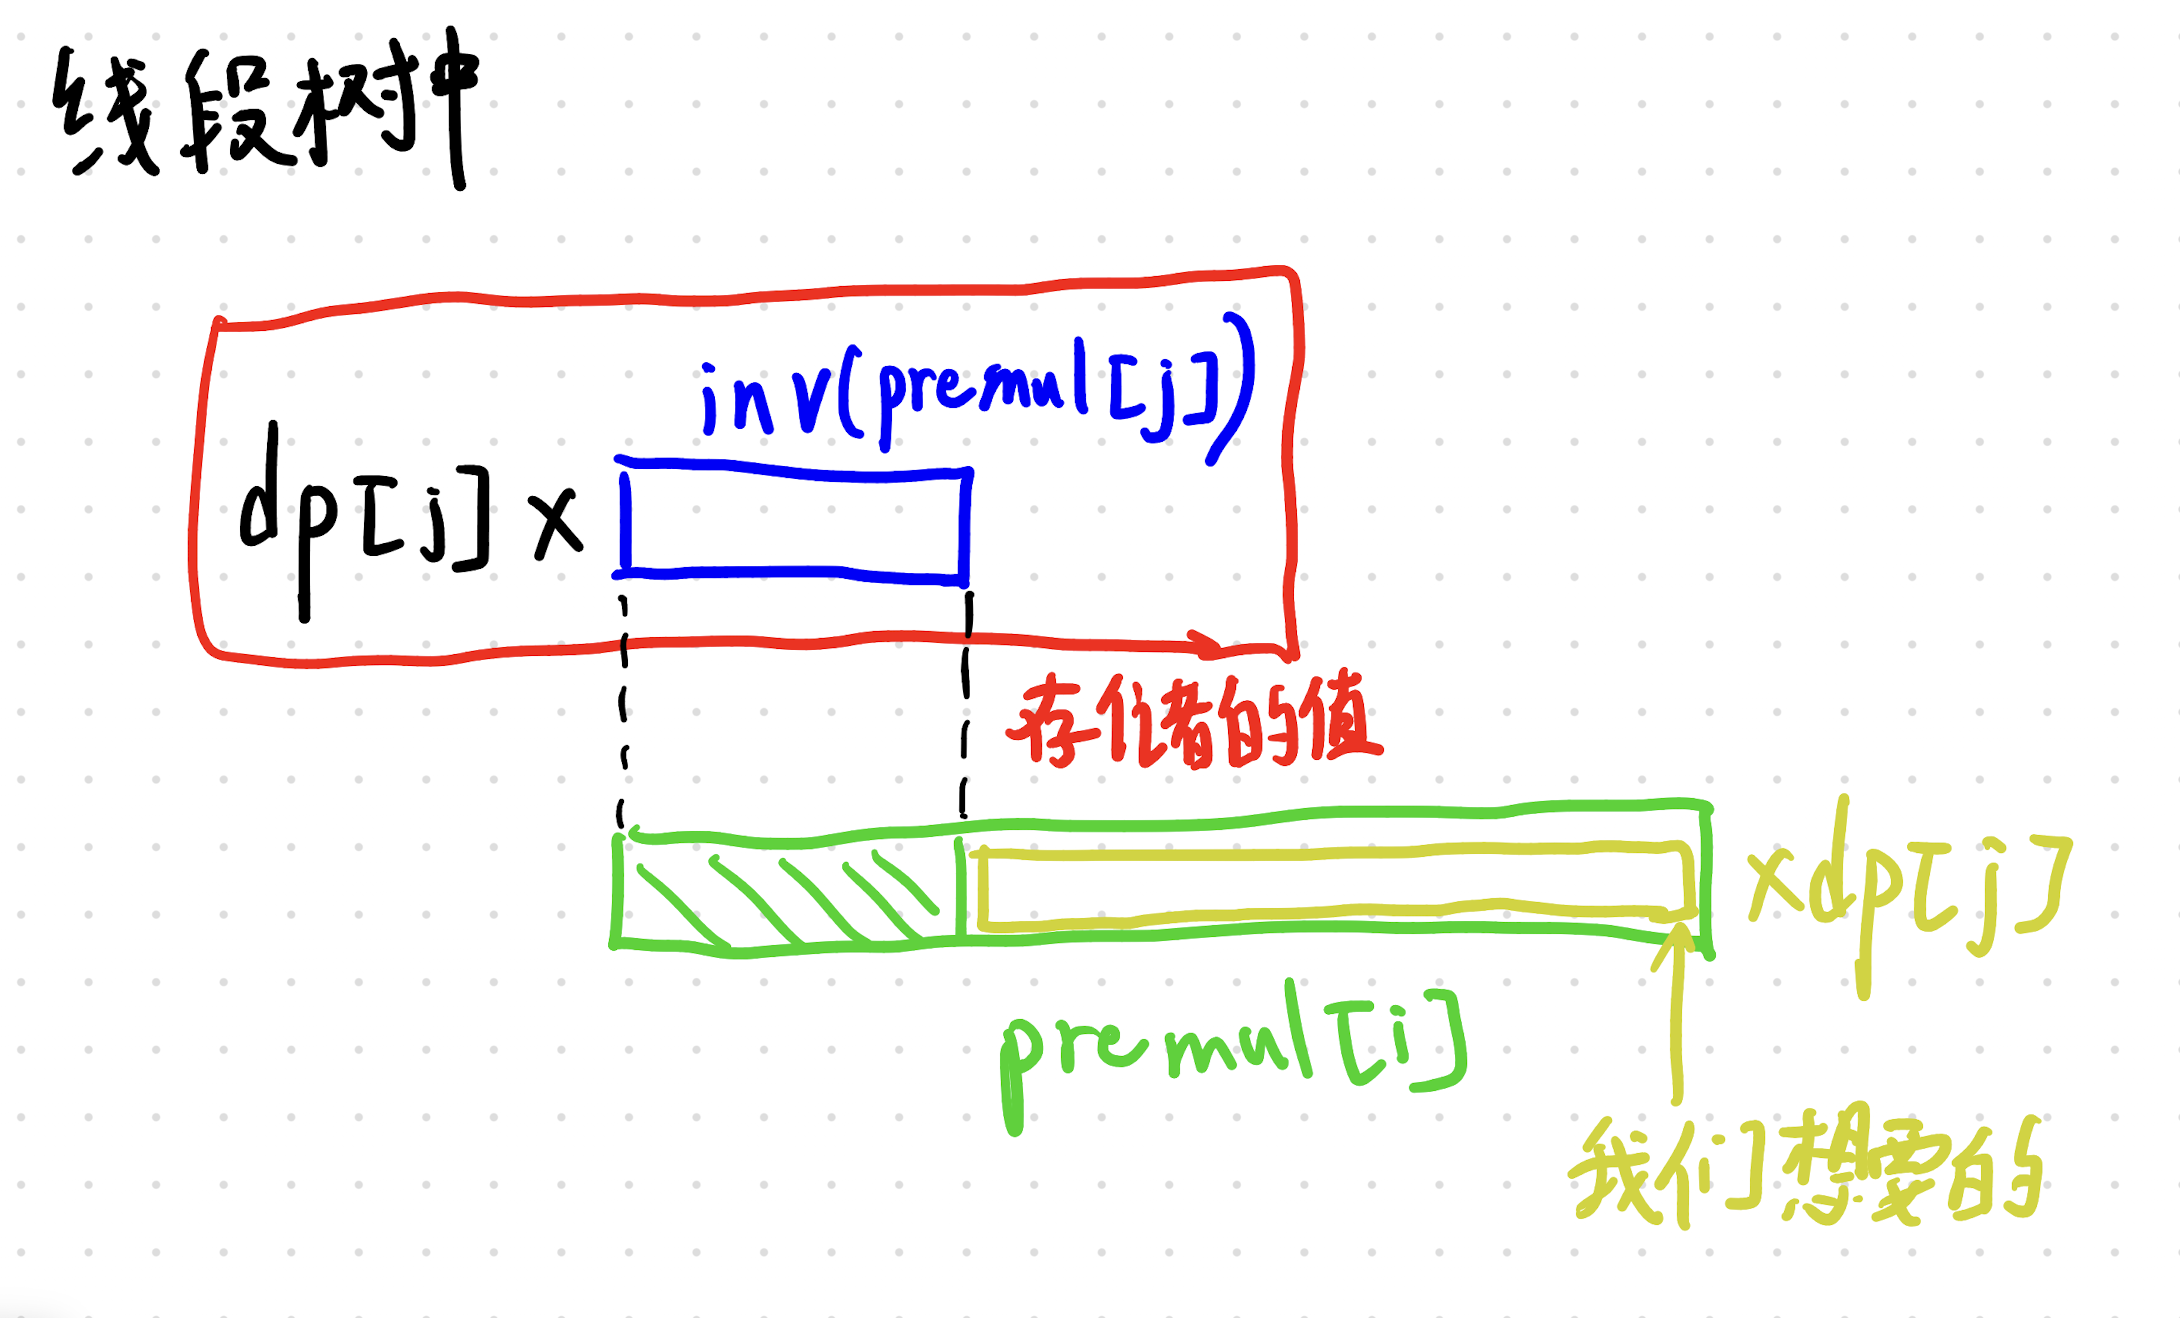
说白了就是在线段树中的 j 存储不同的逆元值,存储的 DP j 乘以不同的逆元值,进而得到乘以相同的值,达到乘以不同值的这个效果。觉得我这个图还是画的比较清楚的。
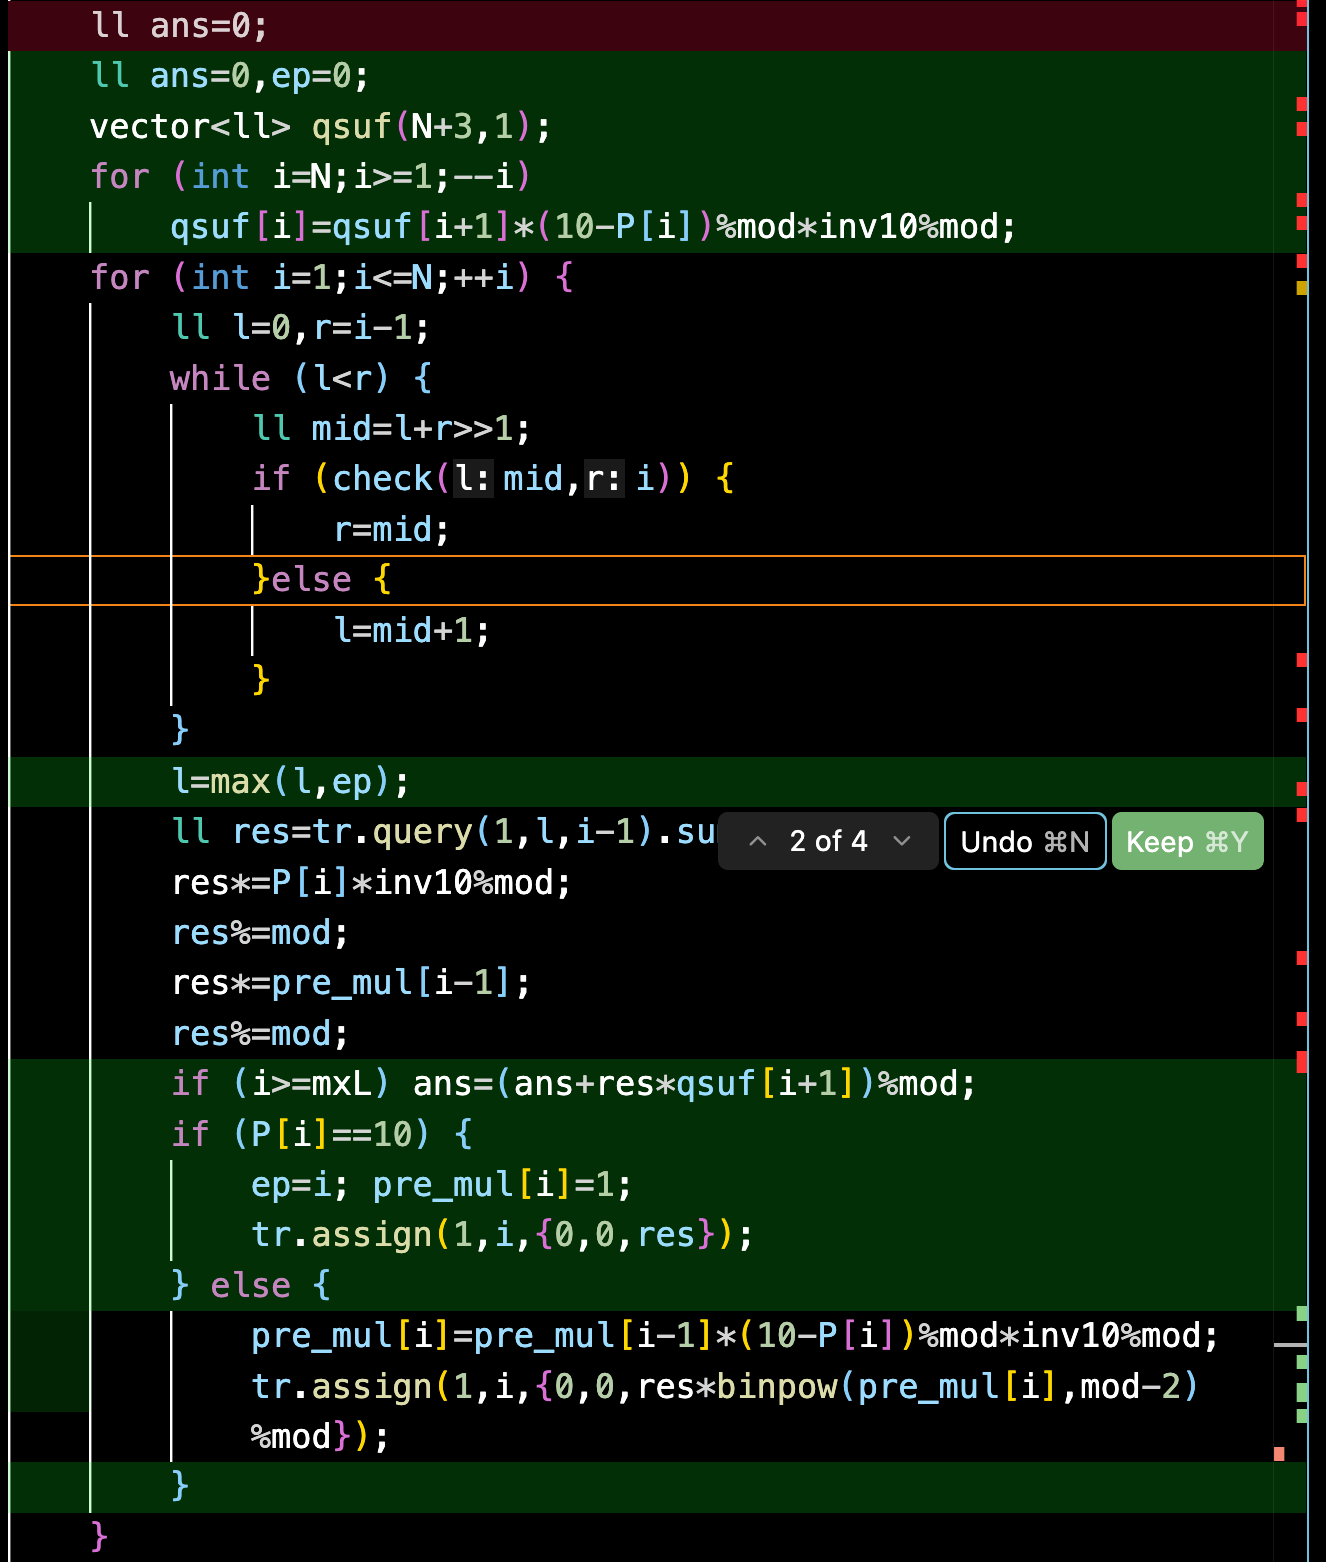
::: 错误 2(虽然说都是乘法,但是实际上我们这里是涉及到除法的(即模逆元),涉及到除法就要考虑到这个0的问题)
:::
```cpp
vector<ll> pre_mul(N+2,1);
for (int i=1;i<=N;++i) {
ll l=0,r=i-1;
while (l<r) {
ll mid=l+r>>1;
if (check(mid,i)) {
r=mid;
}else {
l=mid+1;
}
}
// 比 EP 还小的话,那么这个 L 所能够得到的值,它一定是一个0。和 EP 相等是没事的。
// 因为说白了,我们是求一个后缀和嘛。如果这个点必定被染色,那么在其之前的点是不可能和后面的 DP 不重合的。
l=max(l,ep);
ll res=tr.query(1,l,i-1).sum;
res*=P[i]*inv10%mod;
res%=mod;
res*=pre_mul[i-1];
res%=mod;
if (i>=mxL) {
// 这里是,就是说明这个点以后的所有点必须都是是未染色的。这样子可以保证不同情况之间,它们的概率是没有交集的。
ans+=res*qsuf[i+1];
ans%=mod;
}
pre_mul[i]=pre_mul[i-1]*(10-P[i])%mod*inv10%mod;
if (pre_mul[i]==0) {
pre_mul[i]=1;
ep=i;
}
tr.assign(1,i,{0,0,res*binpow(pre_mul[i],mod-2)%mod});
}
```
## AC 代码
AC
[https://acm.hdu.edu.cn/contest/view-code?cid=1174&rid=28065](https://acm.hdu.edu.cn/contest/view-code?cid=1174&rid=28065)
[https://vjudge.net/solution/67894251](https://vjudge.net/solution/67894251)
::: 源代码
```cpp
/**
* Problem: 线段染色
* Contest:
* Judge: HDOJ
* URL: https://acm.hdu.edu.cn/contest/problem?cid=1174&pid=1009
* Created: 2026-02-20 17:21:22
* Author: Gospel_rock
* My blog: https://znzryb.com/
*
* Powered by AutoCp https://github.com/Pushpavel/AutoCp
*/
#include <bits/stdc++.h>
#define all(vec) vec.begin(),vec.end()
#define lson(o) (o<<1)
#define rson(o) (o<<1|1)
#define SZ(a) ((long long) a.size())
#define debug(var) cerr << #var <<" = ["<<var<<"]"<<"\n";
#define debug1d(a) \
cerr << #a << " = ["; \
for (int i = 0; i < (int)(a).size(); i++) \
cerr << (i ? ", " : "") << a[i]; \
cerr << "]\n";
#define debug2d(a) \
cerr << #a << " = [\n"; \
for (int i = 0; i < (int)(a).size(); i++) \
{ \
cerr << " ["; \
for (int j = 0; j < (int)(a[i]).size(); j++) \
cerr << (j ? ", " : "") << a[i][j]; \
cerr << "]\n"; \
} \
cerr << "]\n";
#define cend cerr<<"\n-----------\n"
#define fsp(x) fixed<<setprecision(x)
using namespace std;
using ll = long long;
using ull = unsigned long long;
using DB = double;
// using i128 = __int128;
using CD = complex<double>;
static constexpr ll MAXN = (ll)2e5+10, INF = (1ll<<61)-1;
static constexpr ll mod = (ll)1e9+7;
static constexpr double eps = 1e-8;
const double pi = acos(-1.0);
ll lT,testcase;
/*
*
*/
/*
* 2026-02-18: 测试这个线段树二分(找到第 K 个 1)
* https://codeforces.com/edu/course/2/lesson/4/2/practice/contest/273278/submission/363516918
*/
struct Info {
// 注意啊,这里除了 L 和 R 以外的所有你所添加的东西,你都要好好想一想其初值是什么。
// 不过我们其实改进了这个 query 函数,所以说如果说你给的这个数组当中所有的值都是所有的值都是有的话,其实不用考虑初值。
// 如果一定要赋初值的话,注意就是 sum 类的都不要赋 infinite 然后只有 max 和 min 的你要好好想想。
ll l = 0, r = 0, sum = 0;
friend ostream &operator <<(ostream &os, const Info &a) {
os << "[" << a.l << ";" << a.r << "]:" << "sum:" << a.sum;
return os;
}
string to_string() const {
stringstream ss;
ss << *this;
return ss.str();
}
static Info merge(const Info &a, const Info &b) {
Info res;
res.l = a.l;
res.r = b.r;
res.sum = a.sum+b.sum;
res.sum%=mod;
return res;
}
};
template<class T=Info>
struct SEG {
ll N;
vector<T> infos;
static bool isIntersect(ll l1,ll r1,ll l2,ll r2) {
if (!(l1>r2 || r1<l2)) return true;
return false;
}
SEG(ll N, const vector<T> &a) {
infos.resize(4 * N + 5);
this->N = N;
build(a, 1, 0, N);
}
void pull(ll u) {
infos[u] = T::merge(infos[u << 1], infos[u << 1 | 1]);
}
void build(const vector<T> &a, ll u, ll l, ll r) {
if (l == r) {
infos[u] = a[l];
infos[u].l = l;
infos[u].r = r;
return;
}
ll mid = l + r >> 1;
build(a, u << 1, l, mid);
build(a, u << 1 | 1, mid + 1, r);
pull(u);
}
T query(ll u, ll l, ll r) {
if (infos[u].l >= l && infos[u].r <= r) {
return infos[u];
}
T res{};
bool isget=false;
if (!(infos[u << 1].r < l || infos[u << 1].l > r)) {
res = query(u << 1, l, r);
isget=true;
}
if (!(infos[u << 1 | 1].r < l || infos[u << 1 | 1].l > r)) {
if (isget) {
res = T::merge(res, query(u << 1 | 1, l, r));
}else {
res=query(u << 1 | 1, l, r);
}
}
return res;
}
void assign(ll u, ll pos, const T &val) {
if (infos[u].l == infos[u].r && infos[u].l == pos) {
infos[u] = val;
infos[u].l = pos;
infos[u].r = pos;
return;
}
if (pos >= infos[u << 1].l && pos <= infos[u << 1].r) {
assign(u << 1, pos, val);
}
if (pos >= infos[u << 1 | 1].l && pos <= infos[u << 1 | 1].r) {
assign(u << 1 | 1, pos, val);
}
pull(u);
}
// 返回第k个有值的下标,当然,要求线段树叶节点值是0或1
// ll findkth(ll u,ll cur_k) {
// if (infos[u].l==infos[u].r) {
// return infos[u].l;
// }
// if (cur_k<=infos[u<<1].sum) {
// return findkth(u<<1,cur_k);
// }
// return findkth(u<<1|1,cur_k-infos[u<<1].sum);
// }
//
// void opposite(ll u, ll pos) {
// if (infos[u].l == infos[u].r && infos[u].l == pos) {
// infos[u].sum ^= 1;
// return;
// }
// if (pos >= infos[u << 1].l && pos <= infos[u << 1].r) {
// opposite(u << 1, pos);
// }
// if (pos >= infos[u << 1 | 1].l && pos <= infos[u << 1 | 1].r) {
// opposite(u << 1 | 1, pos);
// }
// pull(u);
// }
template<class F>
ll findFirst(ll u,ll l,ll r,F && fun) {
if (infos[u].l==infos[u].r) {
if (fun(infos[u])) return infos[u].l;
return -1;
}
ll res=-1;
if (isIntersect(infos[u<<1].l, infos[u<<1].r, l, r) && fun(infos[u<<1])) {
res=findFirst(u<<1,l,r,fun);
}
if (res!=-1) return res;
if (isIntersect(infos[u<<1|1].l, infos[u<<1|1].r, l, r) && fun(infos[u<<1|1])) {
res=findFirst(u<<1|1,l,r,fun);
}
return res;
}
/*
*AC https://codeforces.com/gym/106169/submission/363483057
*线段树可视化 AC 记录
*/
#ifdef LOCAL
vector<ll> visual_widths;
vector<string> visual_grid;
ll mx_layer = 0;
void visualize() {
visual_widths.resize(4 * N + 2);
cal_visual_w(1, 1);
visual_grid.resize(mx_layer + 2, string(visual_widths[1]+5, ' '));
visualize(1, 0, 1);
for (int i = 1; i <= mx_layer; ++i) {
while (!visual_grid[i].empty() && visual_grid[i].back() == ' ') {
visual_grid[i].pop_back();
}
cerr << visual_grid[i] << "\n";
}
}
void cal_visual_w(ll u, ll layer) {
mx_layer = max(mx_layer, layer);
if (infos[u].l == infos[u].r) {
visual_widths[u] = infos[u].to_string().size();
return;
}
cal_visual_w(u << 1, layer + 1);
visual_widths[u] = visual_widths[u << 1] + 3;
cal_visual_w(u << 1 | 1, layer + 1);
visual_widths[u] += visual_widths[u << 1 | 1];
}
// 可视化线段树
void visualize(ll u, ll sc, ll layer) {
if (infos[u].l == infos[u].r) {
string label = infos[u].to_string();
for (ll i = 0; i < label.size(); ++i) {
visual_grid[layer][sc + i] = label[i];
}
return;
}
visualize(u << 1, sc, layer + 1);
string label = infos[u].to_string();
ll pos = label.find(';');
ll labStart = sc + visual_widths[u << 1] + 1 - pos;
for (int i = 1; i <= mx_layer; ++i) {
if (layer + i > mx_layer) break;
visual_grid[layer + i][sc + visual_widths[u << 1] + 1] = '|';
}
for (ll i = 0; i < label.size(); ++i) {
visual_grid[layer][labStart + i] = label[i];
}
visualize(u << 1 | 1, sc + visual_widths[u << 1] + 3, layer + 1);
}
#endif
};
// 在 k<=0 的时候返回 1
ll binpow(ll a,ll k,const ll &p=mod){
ll res=1;
a%=p;
while(k>0){
if((k&1)==1) res=a*res%p;
a=a*a%p;
k>>=1;
}
return res;
}
// 来自wida github仓库 https://github.com/hh2048/XCPC/tree/main 加了一些新功能
//46 ms https://acm.hdu.edu.cn/contest/view-code?cid=1179&rid=14912 读入字符getc(a) 的AC记录
// AC https://vjudge.net/solution/63197697 一道测试读写的codechef题目
namespace QuickRead { // 快读
char buf[1 << 21], *p1 = buf, *p2 = buf;
inline int getc() {
return p1 == p2 && (p2 = (p1 = buf) + fread(buf, 1, 1 << 21, stdin), p1 == p2) ? EOF : *p1++;
}
template <typename T> void Cin(T &a) {
T ans = 0;
bool f = 0;
char c = getc();
for (; c < '0' || c > '9'; c = getc()) {
if (c == '-') f = 1;
}
for (; c >= '0' && c <= '9'; c = getc()) {
ans = ans * 10 + c - '0';
}
a = f ? -ans : ans;
}
void getc(char &a){
char c=getc();
while (isspace(c)) {
c=getc();
}
a=c;
}
template <typename T, typename... Args> void Cin(T &a, Args &...args) {
Cin(a), Cin(args...);
}
// ===== 输出 =====
static constexpr size_t OUT_CAP = 1 << 21; // 大概是2MB
char obuf[OUT_CAP];
size_t op = 0;
inline void flush() {
if (op) {
fwrite(obuf, 1, op, stdout);
op = 0;
}
}
inline void putc(char c) {
if (op == OUT_CAP) flush();
obuf[op++] = c;
}
template <typename T> void write(T x) { // 注意,这里输出不带换行
if (x < 0) putc('-'), x = -x;
if (x > 9) write(x / 10);
putc(x % 10 + '0');
}
struct Flusher { // 析构时自动刷新
~Flusher() { flush(); }
} flusher;
} // namespace QuickRead
using namespace QuickRead;
void Solve() {
ll N,M;
// cin >> N >> M;
Cin(N,M);
vector<ll> P(N+2);
for (int i=1;i<=N;++i) {
Cin(P[i]);
// cin>>P[i];
}
vector<pair<ll,ll>> lr(M);
ll mxL=0;
vector<ll> mn_r(N+2,INF);
for (int i=0;i<M;++i) {
Cin(lr[i].first,lr[i].second);
// cin>>lr[i].first>>lr[i].second;
mn_r[lr[i].first]=min(mn_r[lr[i].first],lr[i].second);
mxL=max(lr[i].first,mxL);
}
if (M==0) {
cout<<1<<"\n";
return;
}
// 这个 MN-R 数组呢,是为了之后去看这个区间内有没有这个独立线段。
for (ll i=N-1;i>=1;--i) {
mn_r[i]=min(mn_r[i+1],mn_r[i]);
}
// sort(all(lr));
ll inv10=binpow(10,mod-2);
SEG tr(N,vector<Info>(N+2));
// tr.assign(1,1,{0,0,P[1]*inv10%mod});
tr.assign(1,0,{0,0,1});
auto check=[&](ll l,ll r) -> bool {
l++;
if (mn_r[l]<r) {
return false;
}
return true;
};
ll ans=0,ep=0;
vector<ll> qsuf(N+3,1);
for (ll i=N;i>=1;--i)
qsuf[i]=qsuf[i+1]*(10-P[i])%mod*inv10%mod;
vector<ll> pre_mul(N+2,1);
for (int i=1;i<=N;++i) {
ll l=0,r=i-1;
while (l<r) {
ll mid=l+r>>1;
if (check(mid,i)) {
r=mid;
}else {
l=mid+1;
}
}
//
l=max(l,ep);
ll res=tr.query(1,l,i-1).sum;
res*=P[i]*inv10%mod;
res%=mod;
res*=pre_mul[i-1];
res%=mod;
if (i>=mxL) {
// 这里是,就是说明这个点以后的所有点必须都是是未染色的。这样子可以保证不同情况之间,它们的概率是没有交集的。
ans+=res*qsuf[i+1];
ans%=mod;
}
pre_mul[i]=pre_mul[i-1]*(10-P[i])%mod*inv10%mod;
if (pre_mul[i]==0) {
pre_mul[i]=1;
ep=i;
}
tr.assign(1,i,{0,0,res*binpow(pre_mul[i],mod-2)%mod});
}
// #ifdef LOCAL
// tr.visualize();
// cend;
// #endif
ans%=mod;
if (ans<0) ans+=mod;
cout<<ans<<"\n";
}
signed main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);
#ifdef LOCAL
cout.setf(ios::unitbuf); // 无缓冲流,方便我们调试
#endif
// cin >> lT;
Cin(lT);
for (testcase=1;testcase<=lT;++testcase)
Solve();
return 0;
}
/*
AC
https://acm.hdu.edu.cn/contest/view-code?cid=1174&rid=28065
https://vjudge.net/solution/67894251
1
4 2
5 5 5 5
2 3
3 4
4 2
*/
```
:::