Codeforces Round 1083 (Div. 2)——CF-2205-E. Simons and Dividing the Rhythm(分析分段 rev 操作的方法即 \text{rev}(XY) = \text{rev}(Y)\text{rev}(X)) · znzryb
## 题目大意
**题目描述**
给定一个长度为 $n$ 的目标数组 $T$。
现有一个与 $T$ 等长的初始数组 $S$,对 $S$ 进行**恰好一次**如下操作:
选择一个整数 $k$,并将数组 $S$ 划分为 $k$ 个连续且不重叠的子段。假设这 $k$ 个子段的下标区间依次为 $[l_1, r_1], [l_2, r_2], \dots, [l_k, r_k]$,满足 $l_1=1$,$r_k=n$,且对于所有的 $1 \le i \le k-1$,都有 $r_i + 1 = l_{i+1}$。
然后,对这 $k$ 个子段分别独立地进行翻转操作。
即,选择的区间形如:

请求出有多少种不同的初始数组 $S$,可以通过上述操作变为目标数组 $T$。由于答案可能很大,请输出其对 $998244353$ 取模后的结果。
**输入格式**
第一行包含一个整数 $t$($1 \le t \le 8000$),表示测试用例的数量。
每组测试用例的第一行包含一个整数 $n$($1 \le n \le 8000$),表示数组的长度。
第二行包含 $n$ 个整数 $T_1, T_2, \dots, T_n$($1 \le T_i \le 8000$),表示目标数组 $T$ 的元素。
保证所有测试用例中 $n$ 的总和不超过 $8000$。
**输出格式**
对于每组测试用例,输出一个整数,表示满足条件的数组 $S$ 的数量对 $998244353$ 取模后的结果。
**样例输入**
```
5
4
1 1 2 1
4
1 2 3 1
6
1 3 2 3 3 2
10
2 3 1 4 3 1 4 3 1 2
1
8000
```
**样例输出**
```
4
7
22
383
1
```
**样例解释**
在第一组测试用例中,$T = [1, 1, 2, 1]$,以下 $4$ 种数组 $S$ 可以被转换为 $T$:
- 对于 $S = [2, 1, 1, 1]$,可以选择区间 $[1, 3]$ 和 $[4, 4]$ 进行翻转。翻转后数组变为 $[1, 1, 2, 1]$,等于 $T$。
- 对于 $S = [1, 2, 1, 1]$,可以选择区间 $[1, 4]$ 进行翻转。
- 对于 $S = [1, 1, 2, 1]$,可以选择区间 $[1, 2]$、$[3, 3]$ 和 $[4, 4]$ 进行翻转。
- 对于 $S = [1, 1, 1, 2]$,可以选择区间 $[1, 2]$ 和 $[3, 4]$ 进行翻转。
在第二组测试用例中,$T = [1, 2, 3, 1]$,以下 $7$ 种数组 $S$ 可以被转换为 $T$:
- 对于 $S = [1, 1, 3, 2]$,可以选择区间 $[1, 1]$ 和 $[2, 4]$ 进行翻转。
- 对于 $S = [1, 2, 1, 3]$,可以选择区间 $[1, 1]$、$[2, 2]$ 和 $[3, 4]$ 进行翻转。
- 对于 $S = [1, 2, 3, 1]$,可以选择区间 $[1, 1]$、$[2, 2]$、$[3, 3]$ 和 $[4, 4]$ 进行翻转。
- 对于 $S = [1, 3, 2, 1]$,可以选择区间 $[1, 4]$ 进行翻转。
- 对于 $S = [2, 1, 1, 3]$,可以选择区间 $[1, 2]$ 和 $[3, 4]$ 进行翻转。
- 对于 $S = [2, 1, 3, 1]$,可以选择区间 $[1, 2]$、$[3, 3]$ 和 $[4, 4]$ 进行翻转。
- 对于 $S = [3, 2, 1, 1]$,可以选择区间 $[1, 3]$ 和 $[4, 4]$ 进行翻转。
## 思路讲解
**分析 rev 操作的一个重要公式是**:
$\text{rev}(XY) = \text{rev}(Y)\text{rev}(X)$
可以继续拓展:

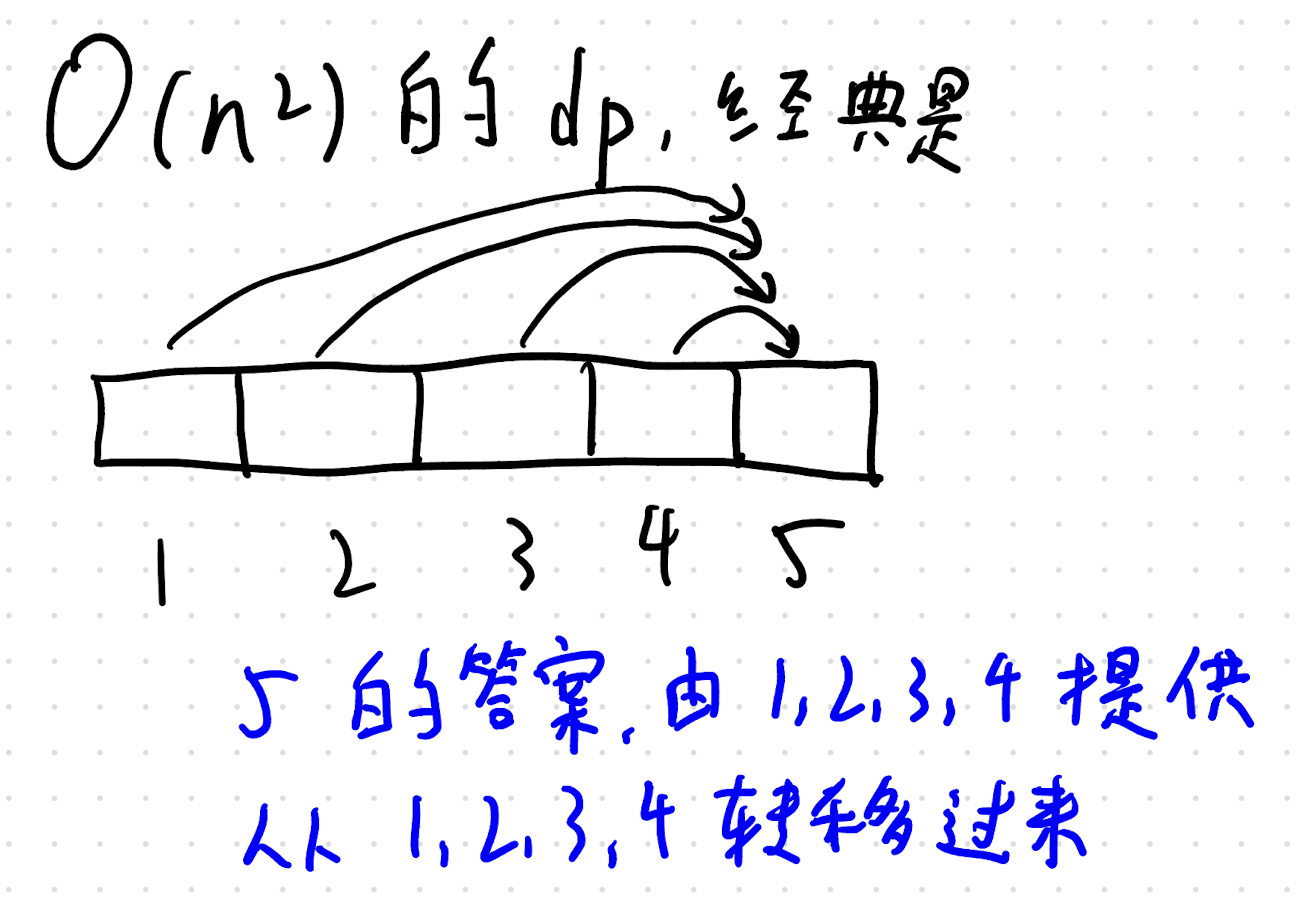
所以,我们要求转移时前缀相同,只采用这一后缀,即可得到独特的**计数**。
具体来讲,我们对这一后缀的要求是(在前缀相同的情况下)这一后缀无论如何划分,都达不到整体的效果。
```
rev(S) != rev(任意对S的划分方法)
```
比如说 `[1, 2, 3, 4]` 任何其他划分方式都达不到 `rev([1, 2, 3, 4])` 的效果。
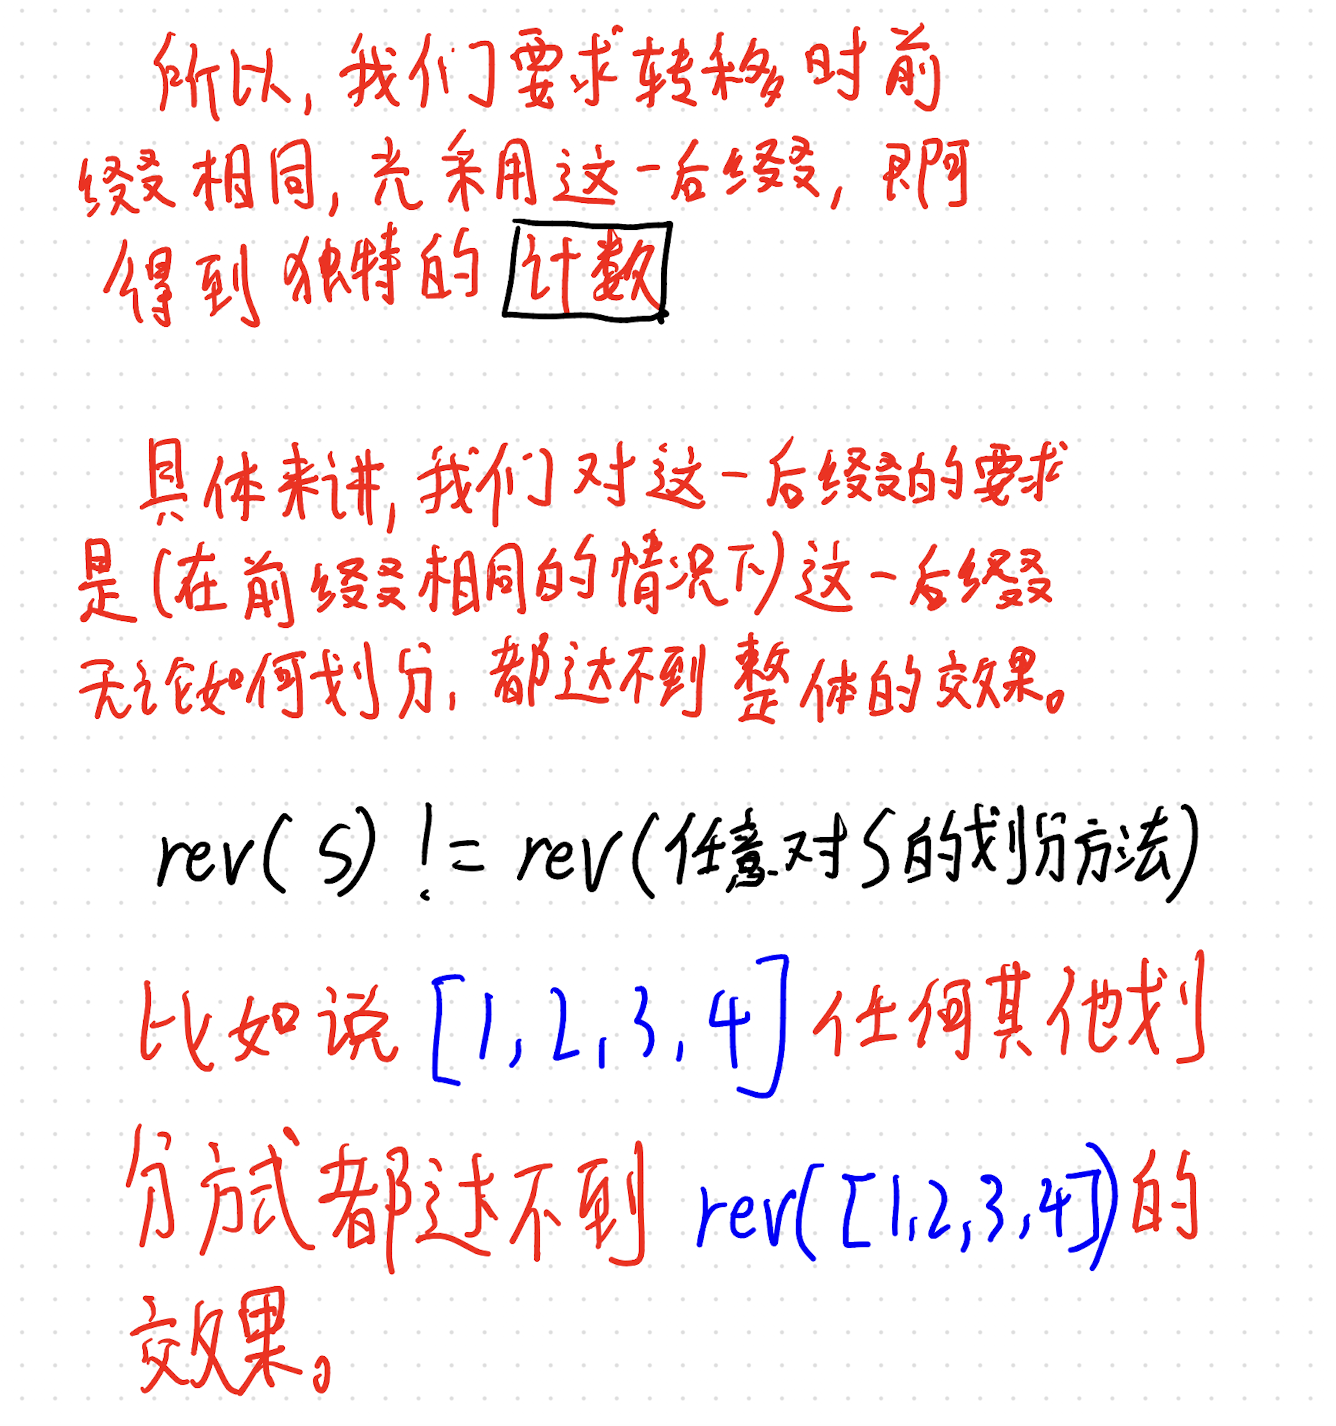
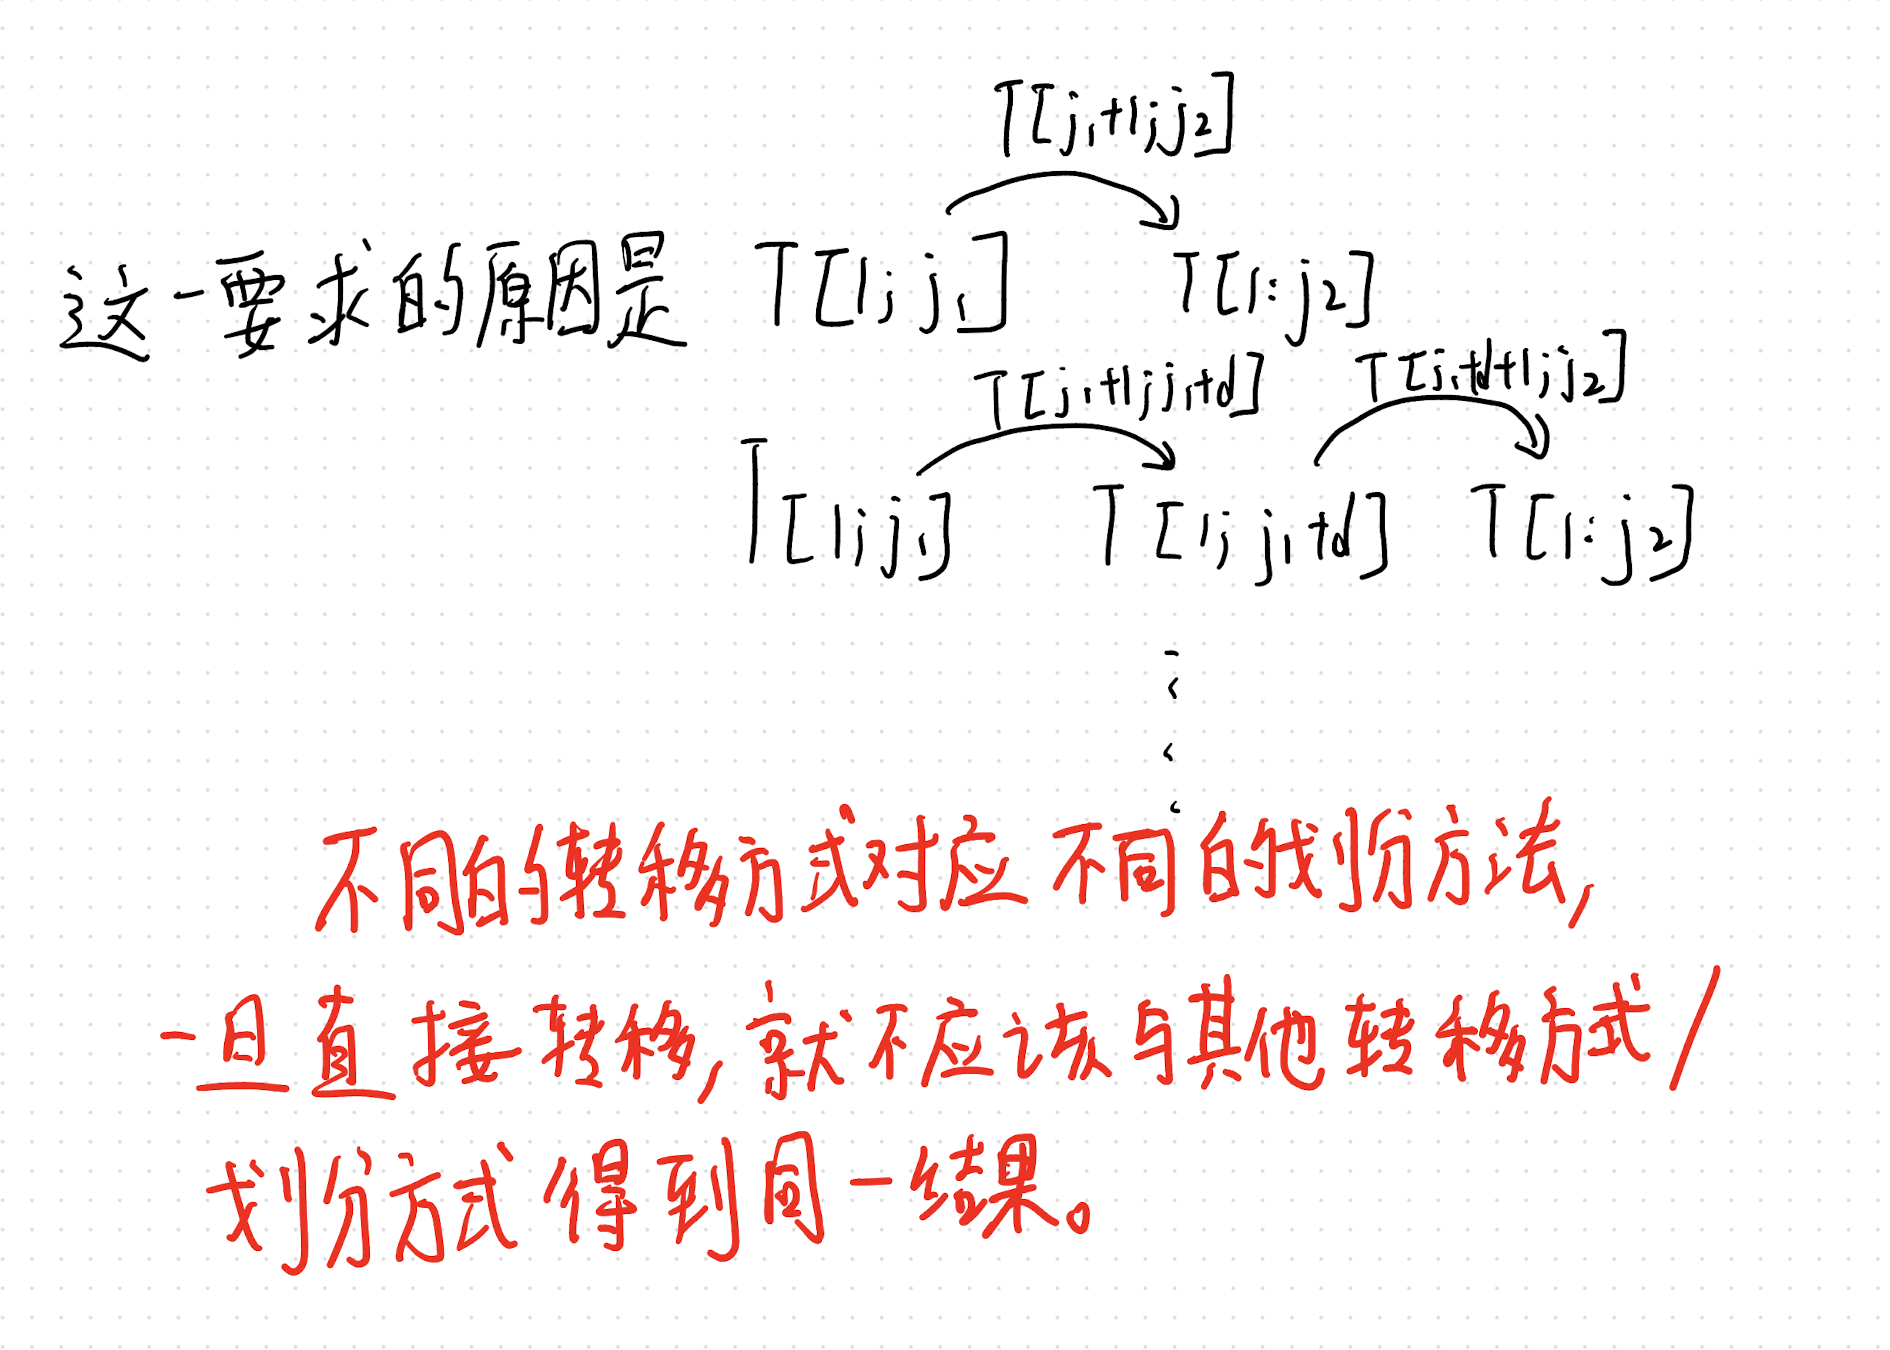


不过**上面**,opus4.6 给出的解释实际上**不是很令人满意**,因为带有非常明显的知道答案,凑出证明的痕迹。我们采用一种更加好的方法?(可能没有那么严谨,但是实际上是严谨的)
[P4391 [BalticOI 2009] Radio Transmission 无线传输](/2025/06/25/20250625-d782a881)
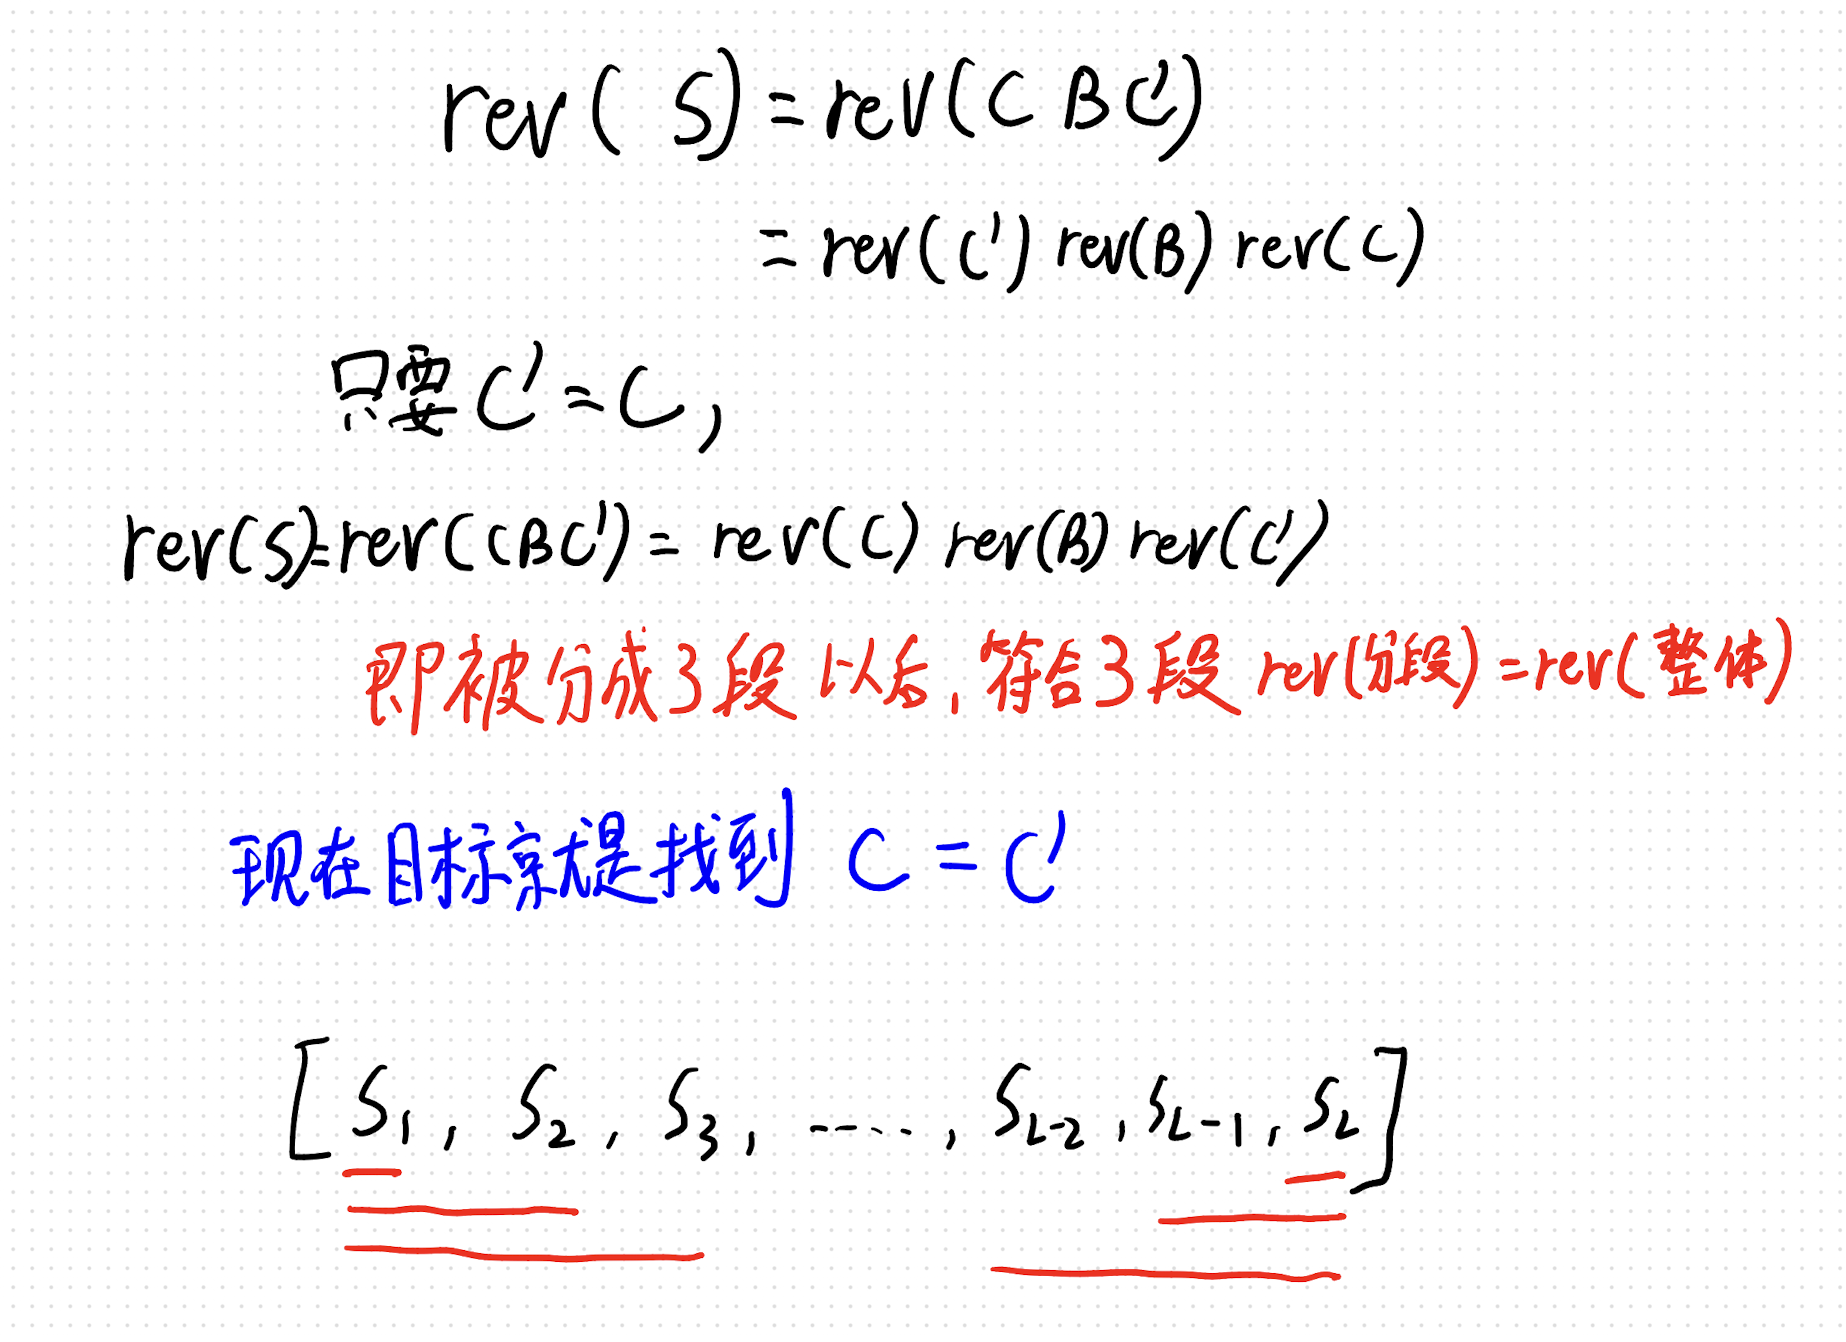
我们不难发现,可以这种**所谓的查找目标** $C=C'$,其实就是查找周期,其实和查找周期的哈希实现一模一样(详见上面一道题目)。

相信看了我的这个解释,应该都能看出来这个东西。
其实,形如 $rev(S)=rev(ABA)$,其实是唯一一种形式,可以保证分段反转等于整体反转。
不过快速检查一个字符串是否有真前后缀相同,显然是使用 kmp(前缀数组,前缀数组就是这么定义的,能不好吗?) 还是比较好的,使用字符串哈希时间复杂度不是很优秀。
[P3375 【模板】KMP(前缀函数)](/2025/06/25/20250625-86183f59)
好,现在问题就来到了,我们怎么样求 $s[l;r]$ 是否有这个真前后缀匹配情况?
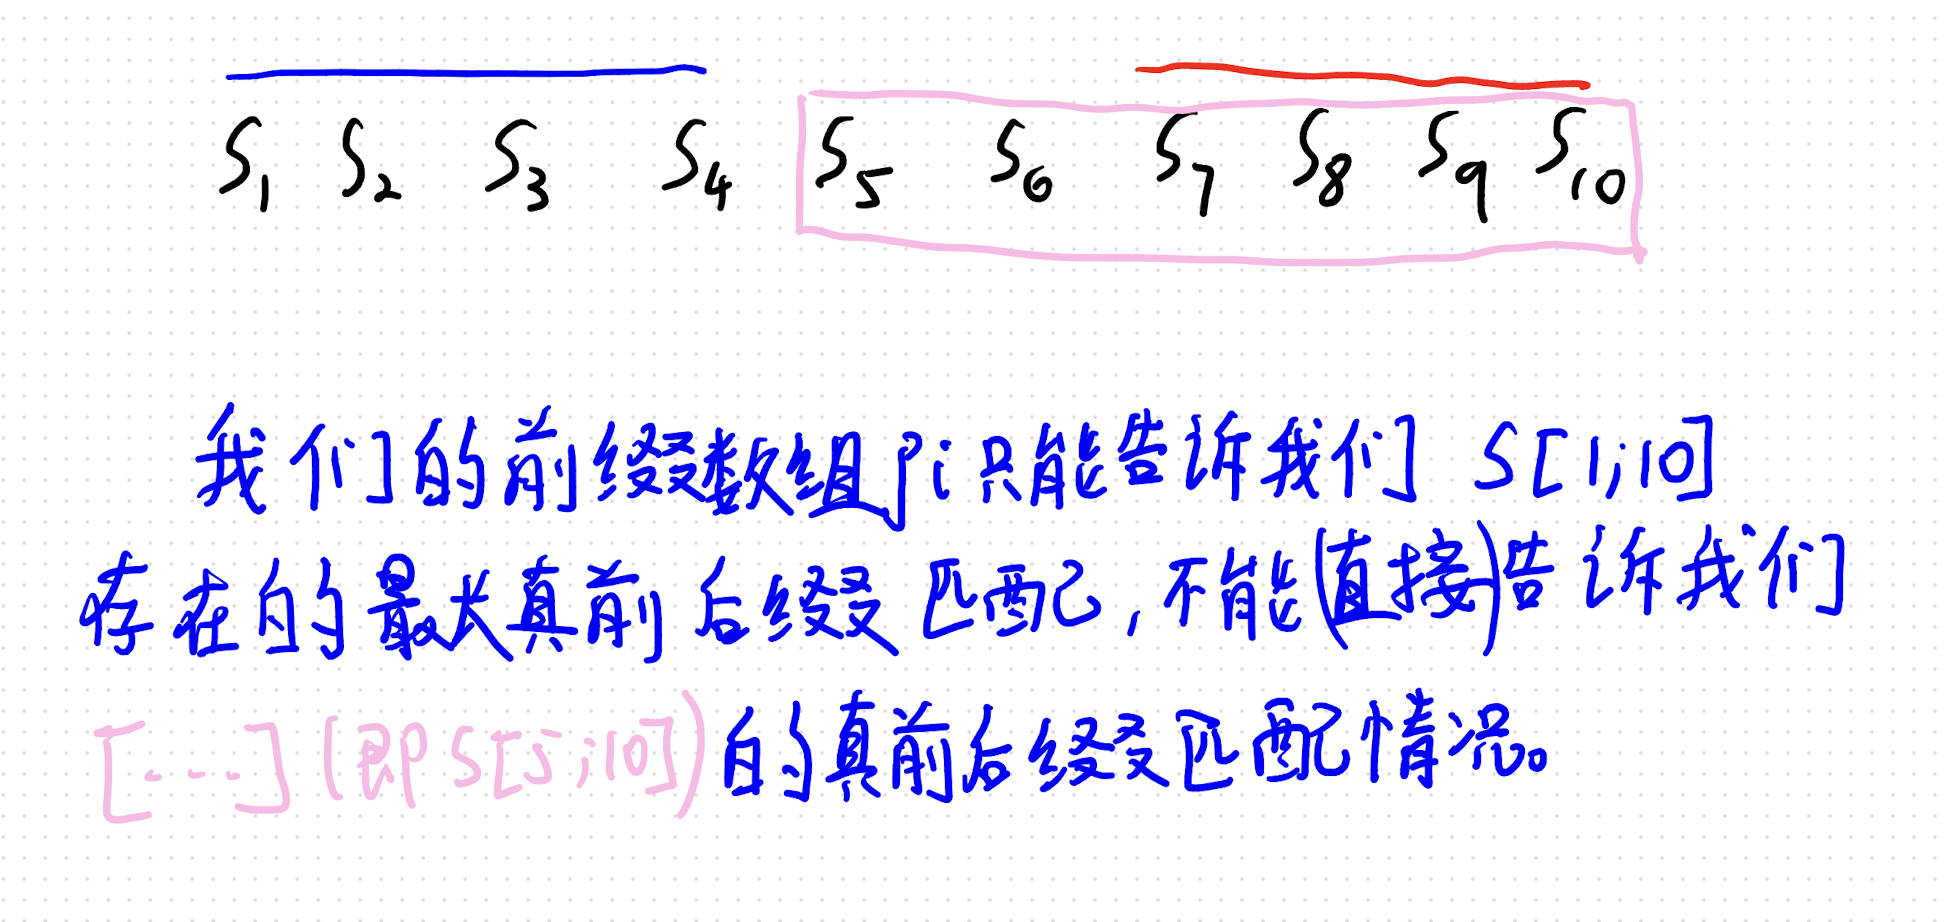
哈哈,其实解决这个问题的方法也很简单,那么**就是跑 n 遍 kmp** 就可以了,这道题目不是 $O(n^2)$ 的嘛。绷不住了。
```cpp
vector<ll> kmp(ll N,const vector<ll> &A){ // 返回总前缀数组pi
vector<ll> pi(N+2);
for(int i=2;i<=N;++i){
ll len=pi[i-1];
// if(S[i]==S[len+1]){
// pi[i]=len+1;
// }
while(true){
if(A[i]==A[len+1]){
pi[i]=len+1;
break;
}
if(len==0) break;
len=pi[len];
}
}
return pi;
}
```
最后的这个 dp 代码:
```cpp
for (int l=1;l<=N;++l) {
vector<ll> pi=kmp(N-l+1,vector<ll>(A.begin()+l-1,A.end()));
ll offset=l-1;
for (int r=l;r<=N;++r) {
if (pi[r-offset]>0) {
continue;
}
dp[r]+=dp[l-1];
dp[r]%=mod;
}
}
```
## AC代码
AC
[https://codeforces.com/contest/2205/submission/365177121](https://codeforces.com/contest/2205/submission/365177121)
这个代码跑的好快啊,竟然
::: 源代码
```cpp
/**
* Problem: E. Simons and Dividing the Rhythm
* Contest: Codeforces Round 1083 (Div. 2)
* Judge: Codeforces
* URL: https://codeforces.com/contest/2205/problem/E
* Created: 2026-03-02 12:26:01
* Author: Gospel_rock
* My blog: https://znzryb.com/
*
* Powered by AutoCp https://github.com/Pushpavel/AutoCp
*/
#include <bits/stdc++.h>
#define all(vec) vec.begin(),vec.end()
#define lson(o) (o<<1)
#define rson(o) (o<<1|1)
#define SZ(a) ((long long) a.size())
#define debug(var) cerr << #var <<" = ["<<var<<"]"<<"\n";
#define debug1d(a) \
cerr << #a << " = ["; \
for (int i = 0; i < (int)(a).size(); i++) \
cerr << (i ? ", " : "") << a[i]; \
cerr << "]\n";
#define debug2d(a) \
cerr << #a << " = [\n"; \
for (int i = 0; i < (int)(a).size(); i++) \
{ \
cerr << " ["; \
for (int j = 0; j < (int)(a[i]).size(); j++) \
cerr << (j ? ", " : "") << a[i][j]; \
cerr << "]\n"; \
} \
cerr << "]\n";
#define cend cerr<<"\n-----------\n"
#define fsp(x) fixed<<setprecision(x)
using namespace std;
using ll = long long;
using ull = unsigned long long;
using DB = double;
using i128 = __int128;
using CD = complex<double>;
static constexpr ll MAXN = (ll)1e6+10, INF = (1ll<<61)-1;
static constexpr ll mod = 998244353; // (ll)1e9+7;
static constexpr double eps = 1e-8;
const double pi = acos(-1.0);
ll lT,testcase;
/*
*
*/
vector<ll> kmp(ll N,const vector<ll> &A){ // 返回总前缀数组pi
vector<ll> pi(N+2);
for(int i=2;i<=N;++i){
ll len=pi[i-1];
// if(S[i]==S[len+1]){
// pi[i]=len+1;
// }
while(true){
if(A[i]==A[len+1]){
pi[i]=len+1;
break;
}
if(len==0) break;
len=pi[len];
}
}
return pi;
}
void Solve() {
ll N;
cin >> N;
vector<ll> A(N+2);
// #ifdef LOCAL
// do {
// Hash hs(4,{0,1,10,1,10});
// assert(hs.getlr(1,2)==hs.getlr(3,4));
// }while (false);
// #endif
for (int i=1;i<=N;++i) {
cin>>A[i];
}
vector<ll> dp(N+2);
dp[0]=1;
// auto check_suf_pre=[&](ll l,ll r) -> bool {
// if () {
//
// }
// };
for (int l=1;l<=N;++l) {
vector<ll> pi=kmp(N-l+1,vector<ll>(A.begin()+l-1,A.end()));
ll offset=l-1;
for (int r=l;r<=N;++r) {
if (pi[r-offset]>0) {
continue;
}
dp[r]+=dp[l-1];
dp[r]%=mod;
}
}
cout<<dp[N]<<"\n";
}
signed main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);
#ifdef LOCAL
cout.setf(ios::unitbuf); // 无缓冲流,方便我们调试
#endif
cin >> lT;
for (testcase=1;testcase<=lT;++testcase)
Solve();
return 0;
}
/*
AC
https://codeforces.com/contest/2205/submission/365177121
*/
```
:::
## 心路历程(WA,TLE,MLE……)
要好好想清楚这个 dp 是从哪里转移过来的,**是从 l-1 转移过来的**。
```cpp
for (int l=1;l<=N;++l) {
vector<ll> pi=kmp(N-l+1,vector<ll>(A.begin()+l-1,A.end()));
ll offset=l-1;
for (int r=l;r<=N;++r) {
if (pi[r-offset]>0) {
continue;
}
dp[r]+=dp[l-1];
dp[r]%=mod;
}
}
```
下面是废掉的 AI 提示
---
::: OPUS 4\.6
**题意转化**
题目要求:给定目标数组 $T$,有多少个不同的初始数组 $S$,使得存在某种将 $S$ 切成若干连续段后分别翻转能得到 $T$。
由于"分段翻转"是自逆操作(对同一分段再做一次翻转就还原),$S$ 能变成 $T$ 当且仅当 $T$ 用同样的分段翻转能变成 $S$。因此问题等价于:
> 把 $T$ 切成若干连续段并分别翻转,能得到多少种**不同**的数组?
**核心观察:何时两种切法产生同一结果**
设切法 1 的最后一段是 $[j_1+1, i]$,切法 2 的最后一段是 $[j_2+1, i]$($j_1 < j_2$)。经过推导可知,它们在位置 $j_2+1$ 到 $i$ 上的值相同当且仅当:
$$
T[q] = T[q + d], \quad j_1+1 \le q \le i - d, \quad d = j_2 - j_1
$$
即子串 $T[j_1+1..i]$ 具有周期 $d$。
**关键引理:非本原段可以缩短**
若 $T[j+1..i]$ 具有周期 $d < i - j$(即该子串不是"本原的"),则所有以 $[j+1, i]$ 为最后一段能产生的结果,都能通过以 $[j+d+1, i]$ 为最后一段来实现。
证明思路:将最后一段 $[j+1, i]$ 的前 $d$ 个字符"吸收"到前缀中——由于周期性,这前 $d$ 个翻转后的值恰好等于对 $T[j+1..j+d]$ 的某种合法分段翻转结果(具体地,用切点 $j+r$ 把它分成两段,其中 $r = (i-j) \bmod d$)。
**推论:本原段之间不产生重复**
若两个最后一段 $[j_1+1, i]$ 和 $[j_2+1, i]$ 都是本原的(最小周期等于自身长度),则 $j_1 \ne j_2$ 时它们产生的结果集合完全不交。因为若有交集,较长的那个子串就会有周期 $|j_2 - j_1|$,与本原性矛盾。
**DP 公式**
设 $dp[i]$ 为 $T[1..i]$ 能产生的不同结果数。由以上分析:
$$
dp[i] = \sum_{\substack{j=0 \\ T[j+1..i] \text{ 是本原的}}}^{i-1} dp[j]
$$
其中 $dp[0] = 1$。每一项互不重叠,无需容斥。
**如何判断本原性**
子串 $T[j+1..i]$ 是本原的当且仅当它的最小周期等于其长度。利用 KMP 的失配函数(failure function):长度为 $L$ 的字符串的最小周期为 $L - \text{fail}[L]$,因此本原等价于 $\text{fail}[L] = 0$。
对于固定的终点 $i$,我们考虑反串 $R_i = T[i], T[i-1], \ldots, T[1]$,则子串 $T[j+1..i]$ 对应 $R_i$ 的前缀 $R_i[1..i-j]$。对 $R_i$ 跑一次 KMP 即可得到所有前缀长度 $L$ 处的 $\text{fail}[L]$,从而判断哪些 $j$ 对应本原段。
**复杂度**
对每个 $i$,KMP 和求和各 $O(i)$,总复杂度 $O(n^2)$。$n \le 8000$,完全可行。
:::
::: OPUS4\.6 对我提出疑问的解答
这是个好问题,我来讲清楚。
## 你的疑惑
证明"非本原段可被更短段覆盖"时,我们说:
> 切法 1(最后一段 $[j_1+1, i]$)和切法 2(最后一段 $[j_2+1, i]$)给出**同一个结果** $R$。
你的疑问是:**"这要求两个切法的前缀部分产生相同的值,但 dp 本身在数不同的结果,这不矛盾吗?"**
## 其实不矛盾,因为两个前缀是不同长度的对象
关键:$R'_1$ 和 $R'_2$ 不是同一个东西。
- $R'*1 \in \mathcal{R}*{j_1}$:是 $T[1..j_1]$ 的某个结果(长度 $j_1$)
- $R'*2 \in \mathcal{R}*{j_2}$:是 $T[1..j_2]$ 的某个结果(长度 $j_2 > j_1$)
$R'_2$ 是从 $R'_1$ **扩展**出来的:保留 $R'_1$ 的前 $j_1$ 个位置,再附加 $T[j_1+1..j_2]$ 的某种分段翻转结果。
## 用样例 1 具体看
$T = [1, 1, 2, 1]$,$i = 4$,$j_1 = 0$,$j_2 = 3$,$d = 3$。
**切法 1**:最后一段 $[1, 4]$,前缀为空。
$$
R = \text{rev}(T[1..4]) = [1, 2, 1, 1]
$$
**切法 2**:最后一段 $[4, 4]$,前缀是 $T[1..3]$ 的某个结果。
要得到同一个 $R = [1, 2, 1, 1]$:
- 位置 4 $= T[4] = 1$ ✓(周期条件保证 $T[1] = T[4]$)
- 前缀 $R'_2[1..3]$ 必须 $= [1, 2, 1]$
**问题:**$[1, 2, 1]$ **是** $T[1..3] = [1, 1, 2]$ **的一个合法结果吗?**
是的!用分段 $\{[1,1], [2,3]\}$:$[1] \circ \text{rev}([1,2]) = [1, 2, 1]$。✓
所以 $R'_2 = [1, 2, 1]$ 确实**存在于** $\mathcal{R}_3$ 中。不需要"凭空创造",它本来就是 $T[1..3]$ 的 $dp_3 = 3$ 个结果之一。
## 逻辑链条
整个推理没有循环:
1. 给定一个具体的结果 $R$,它来自非本原的最后一段 $[j_1+1, i]$
1. 我们**构造**一个 $R'_2$:把 $R'_1$ 后面接上 $T[j_1+1..j_2]$ 的一种特定分段翻转
1. 由于分段翻转是合法操作,$R'*2$ 一定是* $T[1..j_2]$ *的一个****可达结果****(它在 $\mathcal{R}*{j_2}$ 中)
1. 由于周期条件,$R'_2 \circ \text{rev}(T[j_2+1..i]) = R$(同一个结果)
1. 所以 $R$ 已经被更短的最后一段 $[j_2+1, i]$ 覆盖了
不需要假设"前缀相同"——$R'_2$ 是从 $R'_1$ **推导构造**出来的,不是假设出来的。而且 $R'_1$(长度 $j_1$)和 $R'_2$(长度 $j_2$)是不同长度的前缀,不存在"不允许相同"的问题。
:::
::: OPUS 4\.6 模拟样例
好的,我用前三个样例来逐步模拟。
---
**回顾算法核心**
- $dp_0 = 1$(空前缀,一种结果)
- 对每个终点 $i$,构造反串 $R_i = T[i], T[i-1], \ldots, T[1]$,对 $R_i$ 求 KMP 失配函数
- $R_i$ 的前缀长度 $L$ 对应子串 $T[i-L+1..i]$(即以 $i$ 结尾、长度为 $L$ 的最后一段)
- $\text{fail}[L] = 0$ 意味着该子串是**本原的**(最小周期 $= L$),对 $dp_i$ 有贡献
- $\text{fail}[L] > 0$ 意味着存在更短周期,该段产生的结果被更短段"覆盖",跳过
---
## 样例 1:$T = [1, 1, 2, 1]$,答案 $= 4$
$i = 1$**:** $R_1 = [1]$
| $L$ | $R_1[1..L]$ | $\text{fail}$ | 本原? | 对应子串 |
| --- | --- | --- | --- | --- |
| 1 | $[1]$ | 0 | 是 | $T[1..1]=[1]$ |
$$
dp_1 = dp_0 = 1
$$
$i = 2$**:** $R_2 = [1, 1]$
| $L$ | $R_2[1..L]$ | $\text{fail}$ | 本原? | 对应子串 |
| --- | --- | --- | --- | --- |
| 1 | $[1]$ | 0 | 是 | $T[2..2]=[1]$ |
| 2 | $[1,1]$ | 1 | 否 | $T[1..2]=[1,1]$,周期 1 |
$L=2$ 时 $[1,1]$ 有周期 1(两个字符相同),非本原,跳过。
$$
dp_2 = dp_1 = 1
$$
含义:$T[1..2]=[1,1]$ 无论怎么切(切或不切),翻转后都是 $[1,1]$,只有 1 种结果。
$i = 3$**:** $R_3 = [2, 1, 1]$
| $L$ | $R_3[1..L]$ | $\text{fail}$ | 本原? | 对应子串 |
| --- | --- | --- | --- | --- |
| 1 | $[2]$ | 0 | 是 | $T[3..3]=[2]$ |
| 2 | $[2,1]$ | 0 | 是 | $T[2..3]=[1,2]$ |
| 3 | $[2,1,1]$ | 0 | 是 | $T[1..3]=[1,1,2]$ |
三段都是本原的!
$$
dp_3 = dp_2 + dp_1 + dp_0 = 1 + 1 + 1 = 3
$$
含义:$T[1..3]=[1,1,2]$ 的三种不同结果是:
- 最后一段 $[3,3]$($L=1$):前缀 $T[1..2]$ 有 $dp_2=1$ 种结果 $\to$ $[1,1,2]$
- 最后一段 $[2,3]$($L=2$):前缀 $T[1..1]$ 有 $dp_1=1$ 种结果 $\to$ $[1,2,1]$
- 最后一段 $[1,3]$($L=3$):前缀为空,$dp_0=1$ 种 $\to$ $[2,1,1]$
$i = 4$**:** $R_4 = [1, 2, 1, 1]$
| $L$ | $R_4[1..L]$ | $\text{fail}$ | 本原? | 对应子串 | 说明 |
| --- | --- | --- | --- | --- | --- |
| 1 | $[1]$ | 0 | **是** | $T[4..4]=[1]$ | |
| 2 | $[1,2]$ | 0 | **是** | $T[3..4]=[2,1]$ | |
| 3 | $[1,2,1]$ | 1 | 否 | $T[2..4]=[1,2,1]$ | 周期 2($T[2]=T[4]=1$) |
| 4 | $[1,2,1,1]$ | 1 | 否 | $T[1..4]=[1,1,2,1]$ | 周期 3($T[1]=T[4]=1$) |
$L=3$:$[1,2,1]$ 的前缀 $[1]$ 等于后缀 $[1]$,$\text{fail}=1$,最小周期 $= 3-1 = 2 < 3$,非本原。这意味着用 $T[2..4]=[1,2,1]$ 做最后一段的所有结果,都能被更短的最后一段覆盖。
$L=4$:$[1,2,1,1]$ 的前缀 $[1]$ 等于后缀 $[1]$,$\text{fail}=1$,最小周期 $= 4-1 = 3 < 4$,非本原。同理跳过。
$$
dp_4 = dp_3 + dp_2 = 3 + 1 = \boxed{4}
$$
**验证**:4 种不同的 $S$ 分别是:
- 最后一段 $[4,4]$($L=1$),前缀 $T[1..3]$ 有 3 种结果 $\to$ $S \in \{[1,1,2,1],\ [1,2,1,1],\ [2,1,1,1]\}$
- 最后一段 $[3,4]$($L=2$),前缀 $T[1..2]$ 有 1 种结果 $\to$ $S = [1,1,1,2]$
共 4 种。
---
## 样例 2:$T = [1, 2, 3, 1]$,答案 $= 7$
$i = 1$**:** $R_1=[1]$,fail$=[0]$。$dp_1 = 1$。
$i = 2$**:** $R_2=[2,1]$,fail$=[0, 0]$。两段都本原。
$$
dp_2 = dp_1 + dp_0 = 1 + 1 = 2
$$
($T[1..2]=[1,2]$:切或不切给出 $[1,2]$ 和 $[2,1]$,2 种结果)
$i = 3$**:** $R_3=[3,2,1]$,fail$=[0, 0, 0]$。三段都本原(所有字符互不相同)。
$$
dp_3 = dp_2 + dp_1 + dp_0 = 2 + 1 + 1 = 4
$$
$i = 4$**:** $R_4=[1, 3, 2, 1]$
| $L$ | $R_4[1..L]$ | $\text{fail}$ | 本原? | 对应子串 |
| --- | --- | --- | --- | --- |
| 1 | $[1]$ | 0 | **是** | $T[4..4]=[1]$ |
| 2 | $[1,3]$ | 0 | **是** | $T[3..4]=[3,1]$ |
| 3 | $[1,3,2]$ | 0 | **是** | $T[2..4]=[2,3,1]$ |
| 4 | $[1,3,2,1]$ | 1 | 否 | $T[1..4]=[1,2,3,1]$,周期 3($T[1]=T[4]=1$) |
只有 $L=4$ 被排除(整段 $T[1..4]$ 有周期 3)。
$$
dp_4 = dp_3 + dp_2 + dp_1 = 4 + 2 + 1 = \boxed{7}
$$
**验证**:7 种 $S$ 的来源:
- 最后一段 $[4,4]$($L=1$):前缀 $T[1..3]$ 有 4 种 $\to$ 4 个 $S$
- 最后一段 $[3,4]$($L=2$):前缀 $T[1..2]$ 有 2 种 $\to$ 2 个 $S$
- 最后一段 $[2,4]$($L=3$):前缀 $T[1..1]$ 有 1 种 $\to$ 1 个 $S$
$4 + 2 + 1 = 7$,且这三组之间无重复(因为每组的最后一段是本原的,不同本原段不产生交叉)。
---
## 样例 3:$T = [1, 3, 2, 3, 3, 2]$,答案 $= 22$
更快速地走一遍:
| $i$ | $R_i$ | fail 数组 | 本原的 $L$ 值 | DP 转移 | $dp_i$ |
| --- | --- | --- | --- | --- | --- |
| 0 | — | — | — | — | 1 |
| 1 | $[1]$ | $[0]$ | 1 | $dp_0$ | **1** |
| 2 | $[3,1]$ | $[0,0]$ | 1, 2 | $dp_1 + dp_0$ | **2** |
| 3 | $[2,3,1]$ | $[0,0,0]$ | 1, 2, 3 | $dp_2+dp_1+dp_0$ | **4** |
| 4 | $[3,2,3,1]$ | $[0,0,\mathbf{1},0]$ | 1, 2, 4 | $dp_3+dp_2+dp_0$ | **7** |
| 5 | $[3,3,2,3,1]$ | $[0,\mathbf{1},0,\mathbf{1},0]$ | 1, 3, 5 | $dp_4+dp_2+dp_0$ | **10** |
| 6 | $[2,3,3,2,3,1]$ | $[0,0,0,\mathbf{1},\mathbf{2},0]$ | 1, 2, 3, 6 | $dp_5+dp_4+dp_3+dp_0$ | **22** |
最后一行详细解释:
$R_6 = [2, 3, 3, 2, 3, 1]$,KMP 失配函数:
- $L=4$:$R_6[1..4]=[2,3,3,2]$,前缀 $[2]$ = 后缀 $[2]$,$\text{fail}=1$,周期 $3$——对应 $T[3..6]=[2,3,3,2]$ 有周期 3($T[3]=T[6]=2$),**非本原,跳过**
- $L=5$:$R_6[1..5]=[2,3,3,2,3]$,前缀 $[2,3]$ = 后缀 $[2,3]$,$\text{fail}=2$,周期 $3$——对应 $T[2..6]=[3,2,3,3,2]$ 有周期 3($T[2]=T[5]=3$,$T[3]=T[6]=2$),**非本原,跳过**
最终:
$$
dp_6 = dp_5 + dp_4 + dp_3 + dp_0 = 10 + 7 + 4 + 1 = \boxed{22}
$$
---
**直觉总结**
每一步的逻辑可以这样理解:
1. 要计算 $dp_i$,我们枚举"最后一段"的长度 $L$,即 $T[i-L+1..i]$。
1. 如果这一段是**本原的**(没有更短的周期),它产生的结果是"全新的",不会和其他长度的最后一段重复。贡献 $dp_{i-L}$。
1. 如果这一段**非本原**(有周期 $d < L$),说明它的效果能被更短的最后一段完全覆盖——直觉上,多余的"重复部分"可以被吸收进前缀中用另一种合法切法表达。所以跳过,避免重复计数。
1. 不同的本原最后一段之间**绝不产生重复**:若两个本原段产生了相同结果,较长的那个就会出现周期,与本原性矛盾。
所以整个 DP 既不遗漏也不重复,恰好精确计数。
:::
::: 能不能使用样例,让我理解所谓的本源,以及为什么周期为 len 才可以贡献?不为 len 就不能贡献?把这个讲清楚。
好的,我用样例 1($T = [1, 1, 2, 1]$)来把这件事彻底讲清楚。
---
## 一、什么是"本原"
子串 $T[j+1..i]$ 是**本原的**,就是说它**不存在比自身长度更短的周期**。
具体几个例子(都来自样例 1):
- $T[3..4] = [2, 1]$:$T[3] \ne T[4]$($2 \ne 1$),没有周期 1。最小周期 $= 2 =$ 长度。**本原。**
- $T[1..2] = [1, 1]$:$T[1] = T[2] = 1$,有周期 1 $< 2$。**非本原。**
- $T[2..4] = [1, 2, 1]$:$T[2] = T[4] = 1$,有周期 2 $< 3$。**非本原。**
- $T[1..4] = [1, 1, 2, 1]$:$T[1] = T[4] = 1$,有周期 3 $< 4$。**非本原。**
---
## 二、非本原段为什么不贡献——用具体例子看"冗余"
### 例子 A:$T[2..4] = [1, 2, 1]$,周期 2,非本原
我们在计算 $dp_4$ 时,考虑最后一段 $[2, 4]$($L=3$,$j=1$)。
用 $[2,4]$ 做最后一段时:
- 位置 2, 3, 4 的值 $=$ $\text{rev}(T[2..4]) = [T[4], T[3], T[2]] = [1, 2, 1]$
- 前缀 $T[1..1]$ 只有 $dp_1 = 1$ 种结果 $= [1]$
- 唯一产生的完整结果:$[1] \circ [1, 2, 1] = [\mathbf{1, 1, 2, 1}]$
现在我来证明,**这个结果已经被更短的最后一段覆盖了**。
用 $[4,4]$ 做最后一段($L=1$,$j=3$):
- 位置 4 的值 $= T[4] = 1$
- 前缀 $T[1..3]$ 有 $dp_3 = 3$ 种结果
$T[1..3] = [1,1,2]$ 的 3 种结果之一:用分段 $\{[1,1],[2,2],[3,3]\}$,得 $[1, 1, 2]$。
拼起来:$[1, 1, 2] \circ [1] = [\mathbf{1, 1, 2, 1}]$ —— **和上面一模一样!**
所以最后一段 $[2,4]$ 的唯一贡献 $[1,1,2,1]$ 已经被最后一段 $[4,4]$ 包含了。如果我们同时计算两者,就会**重复计数**。
**为什么这行得通?** 关键就在**周期**。$T[2..4]$ 有周期 2,意味着 $T[2] = T[4]$。
对比两种最后一段在位置 4 上的表现:
- 最后一段 $[2,4]$:位置 4 得到的是 $T[2] = 1$(翻转后,段首跑到段尾)
- 最后一段 $[4,4]$:位置 4 得到的是 $T[4] = 1$
$T[2] = T[4]$ **正是周期条件保证的!** 这使得位置 4 的值一致。而被"多出来"的位置 2, 3 则可以交给前缀去处理——用 $T[1..3]$ 的某种分段来产生需要的 $[1, 1, 2]$。
### 例子 B:$T[1..4] = [1, 1, 2, 1]$,周期 3,非本原
用 $[1,4]$ 做最后一段(整段翻转):
- 结果 $= \text{rev}(T[1..4]) = [T[4], T[3], T[2], T[1]] = [1, 2, 1, 1]$
这能被更短的最后一段覆盖吗?周期 $d=3$,所以对应更短的最后一段 $[1+3, 4] = [4, 4]$。
用 $[4,4]$ 做最后一段:
- 位置 4 $= T[4] = 1$
- 需要前缀 $= [1, 2, 1]$
$T[1..3]=[1,1,2]$ 能产生 $[1,2,1]$ 吗?用分段 $\{[1,1], [2,3]\}$:$[1] \circ \text{rev}([1,2]) = [1] \circ [2, 1] = [1, 2, 1]$。**可以!**
拼起来:$[1, 2, 1] \circ [1] = [\mathbf{1, 2, 1, 1}]$ —— 又是同一个结果!
**核心机理相同**:$T[1..4]$ 有周期 3,意味着 $T[1] = T[4] = 1$。所以位置 4 上:长段给出 $T[1]=1$,短段给出 $T[4]=1$,一致。多出来的位置 1, 2, 3 交给前缀来处理。
---
## 三、本原段为什么能贡献——它的结果是"全新的"
### 例子 C:$T[3..4] = [2, 1]$,本原
用 $[3,4]$ 做最后一段($L=2$,$j=2$):
- 位置 3, 4 $= \text{rev}(T[3..4]) = [T[4], T[3]] = [1, 2]$
- 前缀 $T[1..2]$ 有 $dp_2 = 1$ 种结果 $= [1, 1]$
- 唯一结果:$[1, 1] \circ [1, 2] = [\mathbf{1, 1, 1, 2}]$
这个结果**能不能**被最后一段 $[4,4]$($L=1$)覆盖?
用 $[4,4]$:位置 4 $= T[4] = \mathbf{1}$。
但我们需要位置 4 $= \mathbf{2}$(来自 $[3,4]$ 翻转后的 $T[3]=2$)。
$1 \ne 2$**,不可能!** 所以 $[1,1,1,2]$ 绝不可能从最后一段 $[4,4]$ 产生。
**根本原因**:要想让 $[3,4]$ 和 $[4,4]$ 在位置 4 上给出相同的值,需要 $T[3] = T[4]$(即周期 1)。但 $T[3]=2 \ne T[4]=1$。$[2,1]$ 是本原的,**没有**周期 1。所以两种最后一段在位置 4 上必然给出**不同**的值,从而产生**不同**的结果。
---
## 四、总结原理
对于最后一段 $T[j+1..i]$(长度 $L$),考虑"更短一截"的最后一段 $T[j+d+1..i]$(长度 $L-d$):
**两者在位置** $j+d+1$ **到** $i$ **的重叠区域上:**
- 长段 $[j+1, i]$ 翻转后,位置 $p$ 得到 $T[i+j+1-p]$
- 短段 $[j+d+1, i]$ 翻转后,位置 $p$ 得到 $T[i+j+d+1-p]$
两者相等要求:
$$
T[i+j+1-p] = T[i+j+d+1-p] \quad \text{即} \quad T[q] = T[q+d]
$$
这恰好就是**周期** $d$ **的定义**!
所以:
- **有周期** $d < L$(非本原)$\Rightarrow$ 重叠区域值完全一致 $\Rightarrow$ 多出来的 $d$ 个位置可以交给前缀处理 $\Rightarrow$ 长段的所有结果都被短段覆盖 $\Rightarrow$ **不贡献**(计入则重复)
- **没有任何周期** $d < L$(本原)$\Rightarrow$ 对任何更短的段,重叠区域上至少有一个位置值不同 $\Rightarrow$ 结果一定不同 $\Rightarrow$ **贡献是全新的**
这就是为什么 DP 转移中只统计本原段:**本原 = 不可替代 = 贡献新结果,非本原 = 可以被更短段覆盖 = 已经被计算过了。**
:::
::: 我怎么样通过一种比较好的数学运算方法,运算分段 rev 和整体 rev 是否相同?
这个问题有一个非常优雅的数学观察。
## 核心:交换两块
设在 $T[l..r]$ 中,切点在 $m$。令:
$$
A = \text{rev}(T[l..m]), \quad B = \text{rev}(T[m+1..r])
$$
那么:
- **分段翻转**的结果 $= A \circ B$(先放 $A$ 再放 $B$)
- **整体翻转**的结果 $= \text{rev}(T[l..r]) = B \circ A$(这是翻转拼接的标准性质:$\text{rev}(XY) = \text{rev}(Y)\text{rev}(X)$)
所以问题变成:
$$
A \circ B = B \circ A \quad ?
$$
即:**两个字符串是否在拼接运算下交换**。
## 字符串交换的经典定理
有一个经典结论:
> 两个非空字符串 $A$ 和 $B$ 满足 $AB = BA$,当且仅当存在一个字符串 $Z$,使得 $A = Z^p$,$B = Z^q$($p, q \ge 1$)。
也就是说,$A$ 和 $B$ 必须都是**同一个基本串的若干次重复**。
## 用具体例子感受
**例子 1**:$T[1..4] = [1, 2, 1, 2]$,切点 $m=2$。
$$
A = \text{rev}([1,2]) = [2,1], \quad B = \text{rev}([1,2]) = [2,1]
$$
$A = B = [2,1]$,显然 $AB = BA$。($Z = [2,1]$,$p = q = 1$)
验证:分段翻转 $= [2,1,2,1]$,整体翻转 $= \text{rev}([1,2,1,2]) = [2,1,2,1]$。相等 ✓
**例子 2**:$T[2..4] = [1, 2, 1]$(样例 1 中),切点 $m=3$。
$$
A = \text{rev}([1,2]) = [2,1], \quad B = \text{rev}([1]) = [1]
$$
$AB = [2,1,1]$,$BA = [1,2,1]$。$AB \ne BA$。
$A=[2,1]$ 和 $B=[1]$ 不是同一个基本串的幂次(因为长度 2 和 1 的公共基本串只能长度 1,那就要求 $A = [c, c]$,但 $A=[2,1]$),所以不交换 ✓
**例子 3**:$T = [1,2,1,2,1,2]$,切点 $m=2$。
$$
A = \text{rev}([1,2]) = [2,1], \quad B = \text{rev}([1,2,1,2]) = [2,1,2,1]
$$
$Z = [2,1]$,$A = Z^1$,$B = Z^2$。所以 $AB = BA$。
验证:$AB = [2,1,2,1,2,1]$,$BA = [2,1,2,1,2,1]$。相等 ✓
## 等价的周期条件
$AB = BA$ 也可以翻译成**周期语言**:
设 $a = |A| = m - l + 1$,$b = |B| = r - m$。则:
$$
AB = BA \iff T[l..r] \text{ 有周期 } \gcd(a, b)
$$
这是因为"两块能交换"等价于整个串由一个长度为 $\gcd(a,b)$ 的基本单元循环构成。
## 实际计算方法
在代码中,判断"分段 rev $=$ 整体 rev"最实用的方式是**字符串哈希**:
对 $T$ 预处理多项式哈希(前缀哈希 + 逆序前缀哈希),就可以 $O(1)$ 比较任意子串、翻转子串。具体地:
- 计算 $\text{hash}(AB)$:用 $A$ 的哈希和 $B$ 的哈希拼接
- 计算 $\text{hash}(BA)$:用 $B$ 的哈希和 $A$ 的哈希拼接
- 两者相等则分段 rev $=$ 整体 rev
或者更直接地:检查 $T[j] = T[j + b]$ 对所有 $l \le j \le m$ 是否成立(周期 $b$ 条件),**同时**检查 $T[j] = T[j + a]$ 对所有 $l \le j \le l+b-1$ 是否成立(周期 $a$ 条件)。两个条件都满足才行。
---
**总结**:分段翻转和整体翻转是否相同,本质上就是问**两个翻转后的块能否交换顺序**,即 $AB \stackrel{?}{=} BA$。这当且仅当 $A$ 和 $B$ 是同一个基本串的幂次,也等价于整个子串有周期 $\gcd(|A|, |B|)$。
:::
[P4391 [BalticOI 2009] Radio Transmission 无线传输](/2025/06/25/20250625-d782a881)
计算这个串的周期所使用的这个哈希做法。
首先呢,计数问题,还是要选择 dp 解决。
::: Gemini 的回答
**问题转化**
由于翻转操作是对称的,将初始数组 $S$ 划分为若干段并分别翻转得到目标数组 $T$,完全等价于将 $T$ 按照完全相同的划分方式进行分别翻转,从而得到 $S$。因此,原问题可以转化为:对于给定的数组 $T$,将其划分为任意个连续子段并分别翻转,能够产生多少种**不同的**数组 $S$。
**分析重复情况与核心结论**
如果我们随意对 $T$ 进行划分并计算结果,会遇到“不同的划分方式产生相同数组 $S$”的情况。
例如,设当前段为 [1, 2, 3, 1],如果将其作为一整段翻转,会得到 [1, 3, 2, 1];但如果我们将其划分为 [1]、[2, 3]、[1] 三段分别翻转,拼起来的结果依然是 [1, 3, 2, 1]。
发生这种等价替换的根本原因在于:当某一段序列存在一个“前缀等于后缀”(在字符串理论中被称为 Border)时,对其整体翻转的结果,必定等价于将其拆分为更小块分别翻转的结果。
可以证明,为了避免重复计数,我们只需要在所有的划分方案中,**只统计那些所有子段都“无 Border”的划分**。无 Border 的定义是:对于长度为 $L$ 的子段,不存在一个长度介于 $1$ 到 $L-1$ 之间的前缀,与相同长度的后缀完全相等。
任意一个能够通过翻转生成的合法数组 $S$,都存在且**唯一存在**一种完全由“无 Border”子段构成的划分方案。因此,所求的合法数组 $S$ 的数量,恰好就等于将数组 $T$ 划分为若干个“无 Border”子段的合法方案数。
**动态规划设计**
基于上述结论,我们可以使用一维动态规划来解决。
定义 dp[i] 表示将数组 $T$ 的前 $i$ 个元素划分为若干个无 Border 子段的方案数。
初始化时 dp[0] = 1,其余为 $0$。
当我们要从状态 dp[i] 向后转移时,我们需要寻找所有合法的右端点 $j$。条件就是:从 $i+1$ 到 $j$ 构成的子段必须是无 Border 的。如果满足,则执行状态转移:
dp[j] = (dp[j] + dp[i]) % 998244353
**借助 KMP 算法加速判断**
如何快速判断区间是否存在 Border?这恰好是 KMP 算法中求解前缀函数 pi 数组的核心作用。
pi[k] 存储的是前缀子串中最长的“真前缀等于真后缀”的长度。如果 pi[k] == 0,就意味着当前这一段子串不存在任何 Border。
因此,我们可以这样做:
1. 外层循环枚举划分的左端点 $i$(从 $0$ 到 $n-1$)。
1. 如果 dp[i] == 0,直接跳过以优化常数。
1. 否则,将 $T$ 从 $i+1$ 到 $n$ 的剩余部分作为一个新的模式串,对其运行 KMP 算法求解 pi 数组。
1. 在计算 pi 数组的过程中,对于当前长度 $k$,只要发现对应的 pi 值为 $0$,就说明从 $i+1$ 开始、长度为 $k$ 的这一段是无 Border 的,立刻将 dp[i] 的值累加到对应的 dp[i + k] 上即可。
**复杂度分析**
外层遍历左端点 $i$,共执行 $n$ 次。每次针对剩余后缀计算 pi 数组时,KMP 算法的复杂度为线性的 $O(n-i)$。
因此整体的时间复杂度为 $O(n^2)$。题目给定的所有测试用例的 $n$ 之和 $\sum n \le 8000$,其平方规模在 $6 \times 10^7$ 左右,在 2 秒的时限内可以非常高效地通过。空间复杂度仅需维护 dp 数组和单次 KMP 的 pi 数组,为 $O(n)$。
:::
不过总体上来说,我们对 border 的概念不是很熟。
确实,这道题目的难点就在于,对于不同的划分,如果有相同的这个答案怎么办?这个时候就需要引入字符串算法。
::: Border 的具体性质以及解释
**Border 的定义**
在序列(如字符串或数组)中,如果该序列的一个**非平凡前缀**(即长度大于 $0$ 且小于序列总长度的前缀)和它的一个**非平凡后缀**完全相同,那么这个相同的前缀或后缀就被称为该序列的一个 Border。
举个具体的例子:考虑数组 `[1, 2, 4, 5, 1, 2]`。
这个数组长度为 $6$。取它的前缀 `[1, 2]`,再取它的后缀 `[1, 2]`,两者完全相同。因此,`[1, 2]` 就是这个数组的一个 Border。
**Border 对计数产生重复的具体机制**
题目要求我们计算能生成多少种**不同**的初始数组 $S$。如果我们在动态规划中不加任何限制,直接枚举所有可能的划分方式,就会把“产生相同最终数组的不同划分方式”重复计算。
我们继续以数组 `[1, 2, 4, 5, 1, 2]` 为例。假设它是目标数组 $T$ 里的某一个连续子段。现在我们要对这一段进行划分并分别翻转。观察以下两种截然不同的划分方式:
**划分方案一:作为一个整体翻转**
我们将 `[1, 2, 4, 5, 1, 2]` 视为单独的一大段,整体进行一次翻转操作。
翻转后的结果是:`[2, 1, 5, 4, 2, 1]`。
**划分方案二:沿着 Border 将其拆分后分别翻转**
我们把这段数组拆分成三小段,分别是:前缀 Border、中间剩余的部分、后缀 Border,即拆分为 `[1, 2]`、`[4, 5]`、`[1, 2]`。
我们对这三个小段分别独立进行翻转:
第一段 `[1, 2]` 翻转得到 `[2, 1]`;
第二段 `[4, 5]` 翻转得到 `[5, 4]`;
第三段 `[1, 2]` 翻转得到 `[2, 1]`。
最后,把这三段翻转后的结果原样拼接起来,得到的结果依然是:`[2, 1, 5, 4, 2, 1]`。
可以看出,**不同的划分方式(整体分** $1$ **段对比拆分成** $3$ **段)最终产生了一模一样的生成数组**。如果不加干预,这两种划分方案都会被统计入总方案数中,对于同一个合法的数组 $S$,我们就进行了重复计数。
**将现象抽象化**
为什么只要存在 Border 就会发生这种情况?
我们可以把任意存在 Border 的序列抽象地表示为 $B + M + B$(其中 $B$ 是 Border 代表的子段,$M$ 是中间夹着的子段,$+$ 表示拼接操作)。
如果我们把它作为整体翻转,得到的是 $(B + M + B)^R$。根据翻转操作的数学性质,把一个拼接序列整体翻转,等价于把原序列从后往前依次翻转拼接,即结果为 $B^R + M^R + B^R$。
如果我们把它拆分成三段分别翻转并拼接,结果显然也是 $B^R + M^R + B^R$。
这就推导出了一个核心结论:**只要某一段序列内部存在 Border,那么把这段序列“整体翻转”所产生的效果,总是可以被“沿着 Border 切分成更小的块并分别翻转”的效果完全替代。**
**消除重复的最终策略**
既然“存在 Border 的大段”总是可以被等价替换为“没有 Border 的小段组合”,那么为了做到不重不漏,我们需要为每一种生成的最终数组 $S$ 寻找一个**唯一代表它**的划分方式。
我们的强制规定就是:**在所有能产生同一个结果** $S$ **的划分方案中,我们只统计那种“被拆分得最细”的方案**。
什么样的方案是拆得最细的?就是划分出来的每一小段序列,都**不存在任何 Border**。
因为一旦某个子段没有 Border,它就绝对无法再被拆解为类似于 $B + M + B$ 的形式,也就意味着它“作为一个整体翻转产生的结果”,绝对无法通过“拆分成更小的几段分别翻转”来伪造。
可以从数学上严谨证明,任意一个能够通过翻转操作生成的合法数组 $S$,都存在且仅存在一种完全由“无 Border 子段”构成的划分方式。因此,只要在动态规划转移时,严格限制划分出来的每一段都必须没有 Border,我们计算出的方案数就恰好等于最终生成的不同数组 $S$ 的数量,从而达到了去重目的的不同数组 $S$ 的数量。
:::
::: Gemini 的算法对样例的模拟演示
好的,我们对样例 `6 \\n 1 3 2 3 3 2` 进行详细的算法模拟。
目标数组 $T = [1, 3, 2, 3, 3, 2]$,长度 $n = 6$。
我们使用一维 DP,`dp[i]` 表示将 $T$ 的前 $i$ 个元素划分为若干个无 Border 子段的方案数。
初始化:`dp[0] = 1`,其余 `dp[1...6] = 0`。
---
### **第一步:以** $i = 0$ **为左端点进行拓展**
当前 `dp[0] = 1`。我们需要考察从下标 $1$ 开始的后缀 $T[1...6] = [1, 3, 2, 3, 3, 2]$。
对此后缀运行 KMP 求 `pi` 数组(注:为方便描述,这里子串内索引用 $1$ 开始,对应原数组 $T$ 的前缀长度 $k$):
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[1]` | $0$ | **是** | `dp[1] += dp[0]` $\rightarrow$ `dp[1] = 1` |
| $2$ | `[1, 3]` | $0$ | **是** | `dp[2] += dp[0]` $\rightarrow$ `dp[2] = 1` |
| $3$ | `[1, 3, 2]` | $0$ | **是** | `dp[3] += dp[0]` $\rightarrow$ `dp[3] = 1` |
| $4$ | `[1, 3, 2, 3]` | $0$ | **是** | `dp[4] += dp[0]` $\rightarrow$ `dp[4] = 1` |
| $5$ | `[1, 3, 2, 3, 3]` | $0$ | **是** | `dp[5] += dp[0]` $\rightarrow$ `dp[5] = 1` |
| $6$ | `[1, 3, 2, 3, 3, 2]` | $0$ | **是** | `dp[6] += dp[0]` $\rightarrow$ `dp[6] = 1` |
**本轮结束状态**:`dp = [1, 1, 1, 1, 1, 1, 1]`
---
### **第二步:以** $i = 1$ **为左端点进行拓展**
当前 `dp[1] = 1`。考察从下标 $2$ 开始的后缀 $T[2...6] = [3, 2, 3, 3, 2]$。
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[3]` | $0$ | **是** | `dp[1+1] += dp[1]` $\rightarrow$ `dp[2] = 2` |
| $2$ | `[3, 2]` | $0$ | **是** | `dp[1+2] += dp[1]` $\rightarrow$ `dp[3] = 2` |
| $3$ | `[3, 2, 3]` | $1$ (Border:`[3]`) | 否 | 无操作 |
| $4$ | `[3, 2, 3, 3]` | $1$ (Border:`[3]`) | 否 | 无操作 |
| $5$ | `[3, 2, 3, 3, 2]` | $2$ (Border:`[3, 2]`) | 否 | 无操作 |
**本轮结束状态**:`dp = [1, 1, 2, 2, 1, 1, 1]`
---
### **第三步:以** $i = 2$ **为左端点进行拓展**
当前 `dp[2] = 2`。考察从下标 $3$ 开始的后缀 $T[3...6] = [2, 3, 3, 2]$。
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[2]` | $0$ | **是** | `dp[2+1] += dp[2]` $\rightarrow$ `dp[3] = 4` |
| $2$ | `[2, 3]` | $0$ | **是** | `dp[2+2] += dp[2]` $\rightarrow$ `dp[4] = 3` |
| $3$ | `[2, 3, 3]` | $0$ | **是** | `dp[2+3] += dp[2]` $\rightarrow$ `dp[5] = 3` |
| $4$ | `[2, 3, 3, 2]` | $1$ (Border:`[2]`) | 否 | 无操作 |
**本轮结束状态**:`dp = [1, 1, 2, 4, 3, 3, 1]`
---
### **第四步:以** $i = 3$ **为左端点进行拓展**
当前 `dp[3] = 4`。考察从下标 $4$ 开始的后缀 $T[4...6] = [3, 3, 2]$。
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[3]` | $0$ | **是** | `dp[3+1] += dp[3]` $\rightarrow$ `dp[4] = 7` |
| $2$ | `[3, 3]` | $1$ (Border:`[3]`) | 否 | 无操作 |
| $3$ | `[3, 3, 2]` | $0$ | **是** | `dp[3+3] += dp[3]` $\rightarrow$ `dp[6] = 5` |
**本轮结束状态**:`dp = [1, 1, 2, 4, 7, 3, 5]`
---
### **第五步:以** $i = 4$ **为左端点进行拓展**
当前 `dp[4] = 7`。考察从下标 $5$ 开始的后缀 $T[5...6] = [3, 2]$。
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[3]` | $0$ | **是** | `dp[4+1] += dp[4]` $\rightarrow$ `dp[5] = 10` |
| $2$ | `[3, 2]` | $0$ | **是** | `dp[4+2] += dp[4]` $\rightarrow$ `dp[6] = 12` |
**本轮结束状态**:`dp = [1, 1, 2, 4, 7, 10, 12]`
---
### **第六步:以** $i = 5$ **为左端点进行拓展**
当前 `dp[5] = 10`。考察从下标 $6$ 开始的后缀 $T[6...6] = [2]$。
| 长度 $k$ | 当前子串 | KMP `pi[k]` | `pi[k] == 0`? | DP 转移操作 |
| --- | --- | --- | --- | --- |
| $1$ | `[2]` | $0$ | **是** | `dp[5+1] += dp[5]` $\rightarrow$ `dp[6] = 22` |
**最终状态**:`dp = [1, 1, 2, 4, 7, 10, 22]`
---
### **模拟结论**
遍历结束后,我们将整个数组 $T$(长度为 $6$)划分为若干个无 Border 子段的总方案数,即为 `dp[6]`。
模拟得出的 `dp[6]` 的值为 $22$。
对比题目样例:
```
6
1 3 2 3 3 2
```
样例输出恰好为 `22`。算法模拟过程严丝合缝地吻合了正确答案。
:::
众所周知,计数题目,必须要找到一种方法,**一种特征,保证符合这一特征的划分方式/方案之间是独立,互不相同的**。这道题目的特征如下:(注意,我们认为单一字符符合这个要求,毕竟递归需要有一终止条件嘛)
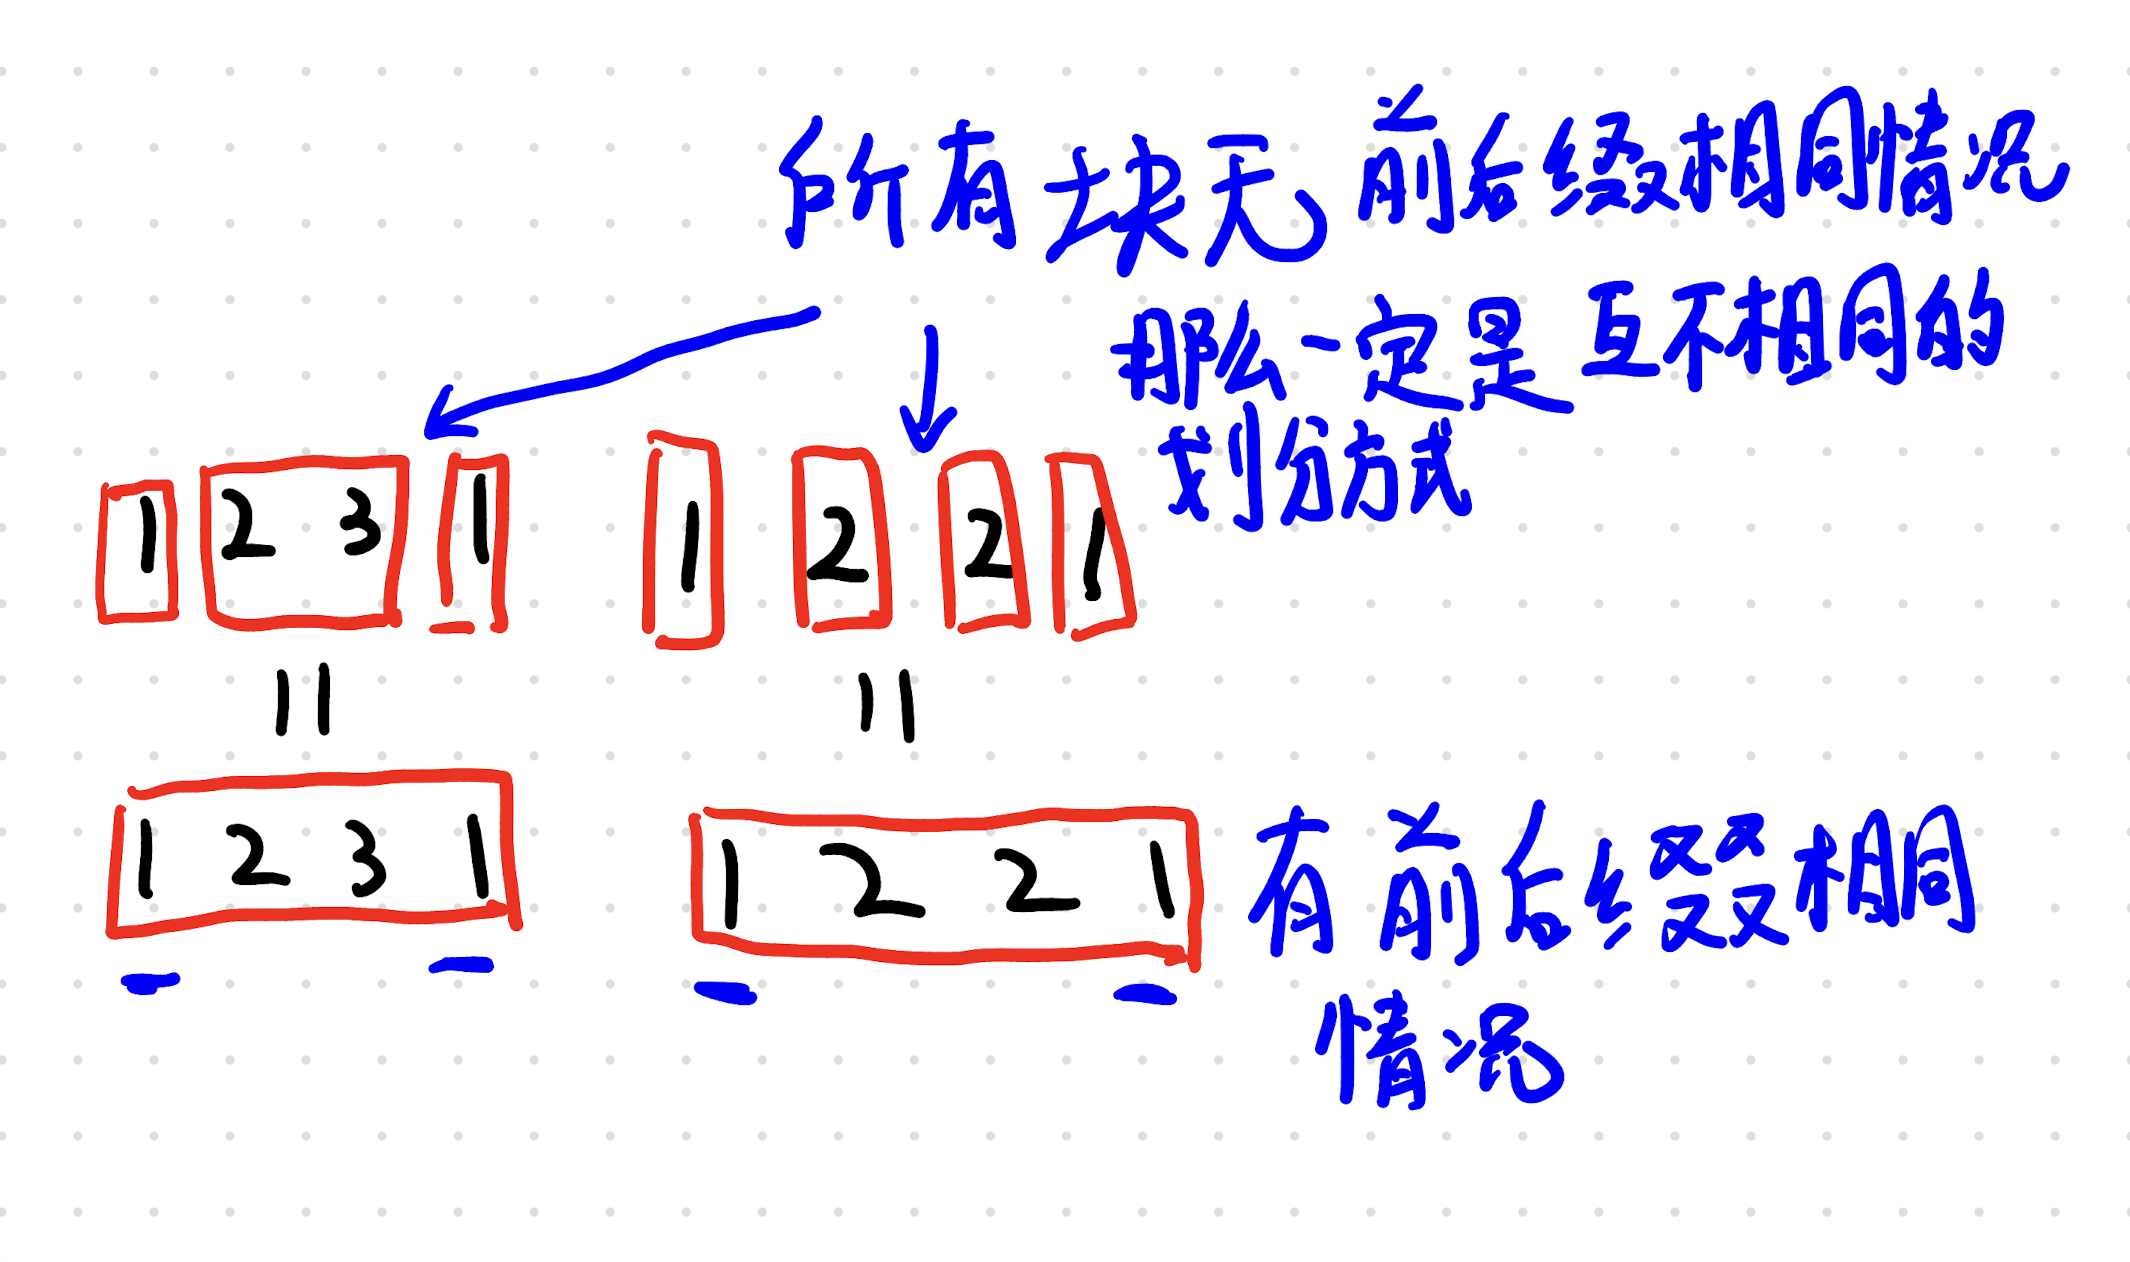
只要有前后缀相同情况,那么一定会有更加细粒度的切分方法,实现相同效果。
不过,如果**只是需要无前后缀相同情况的话,那么直接判断一下前后缀第一个一不一样不就行了**?事实上,我们要求,我们所选择的串,其所有子串(长度 ≥ 2)的前后缀都必须不同。