2026 杭电春季联赛 2——1003-竹林清韵(时间复杂度分析)(调和级数的时间复杂度)(打了懒操作标签是因为采用了类似于上限的定义方法) · znzryb
## 题目大意
**题目描述总结**
给定一个长度为 $n$ 的数列 $a_1, a_2, \dots, a_n$ 和一个定值 $x$。两名玩家(铃仙和因幡帝)交替从数列中取数,取出的数会立刻从原数列中删除。规则如下:
1. 铃仙先手,每次可以从当前数列中**任选一个**数。
1. 因幡帝后手,每次**必须**选择当前数列**头部的前** $x$ **个**数(即剩下数列的第 $1$ 到第 $x$ 个数)。若当前数列剩余元素不足 $x$ 个,则因幡帝会将剩余的所有数全部取走。
1. 两人交替选数,直到数列为空。
铃仙的目标是**最大化**自己所取出的所有数字之和。
假设铃仙始终采取最优策略,请对于所有的 $x = 1, 2, 3, \dots, n-1$,分别独立求出铃仙所能获得的数字和的最大值。
**输入格式**
第一行包含一个整数 $t$($1 \le t \le 1000$),表示测试用例数量。
每个测试用例包含两行:
第一行是一个整数 $n$($2 \le n \le 2 \times 10^5$),表示数列长度。
第二行是 $n$ 个正整数 $a_i$($1 \le a_i \le 10^9$),表示给定的数列。
保证所有测试用例中 $n$ 的总和不超过 $5 \times 10^5$。
**输出格式**
对于每个测试用例输出一行,包含 $n-1$ 个正整数。第 $i$ 个整数表示当 $x=i$ 时,铃仙能获得的最大数字和。
**样例数据**
**输入样例:**
```
3
2
1 2
6
1 1 4 5 1 4
11
12 11 10 9 1 2 3 4 5 12 11
```
**输出样例:**
```
2
13 9 9 9 5
54 44 35 35 24 24 24 24 23 12
```
**样例解释**
在样例 $2$ 中,初始数列为 $1, 1, 4, 5, 1, 4$。
当 $x=1$ 时,一种使得铃仙获得最大和的方案为:
- 铃仙先选取 $a_4=5$,删除该数,此时数列变为 $1, 1, 4, 1, 4$;
- 因幡帝必须选取头部的 $1$ 个元素 $a_1=1$,此时数列变为 $1, 4, 1, 4$;
- 铃仙再选取 $a_2=4$,此时数列变为 $1, 1, 4$;
- 因幡帝必须选取头部的 $1$ 个元素 $a_1=1$,此时数列变为 $1, 4$;
- 铃仙再选取 $a_2=4$,此时数列变为 $1$;
- 因幡帝必须选取头部的 $1$ 个元素 $a_1=1$,此时数列为空,停止。
铃仙所选之数的和为 $5+4+4=13$。可以证明,该方案铃仙所选之数的和最大。
当 $x=3$ 时,一种使得铃仙获得最大和的方案为:
- 铃仙先选取 $a_4=5$,删除该数,此时数列变为 $1, 1, 4, 1, 4$;
- 因幡帝必须选取头部的 $3$ 个元素 $a_1=1, a_2=1, a_3=4$,此时数列变为 $1, 4$;
- 铃仙再选取 $a_2=4$,此时数列变为 $1$;
- 因幡帝必须选取头部的 $3$ 个元素,但当前数列大小小于 $3$,全部取完,此时数列为空,停止。
铃仙所选之数的和为 $5+4=9$。可以证明,该方案铃仙所选之数的和最大。
## 思路讲解
说实话,看完这道题目,我的感觉是不是特别困难。
那么,这道题目的**第一个难点就是时间复杂度分析**:
呃,其实我们会发现,使用数据结构优化的这个贪心,**因为有调和级数的保障,时间复杂度是对的**。
或者,换句话说,如果我们的这个**每次铃仙选数的次数(在所有 x 下)**加起来是 $n/2+n/3+n/4+n/5+\cdots+1$,是不是就是这个调和级数?
然后这道题目的**第二个难点就是这个贪心策略地选择**:
⚠️注意:容易想到的贪心策略有~~**不断地取前 x+1 个中最大的数字**~~**,**~~**不断地取全局最大数字**~~,但是这些都是错的!
::: 不断地取前 x\+1 个中最大的数字的反例(说白了,这个东西有反例就是我们把原数组中的数字强行进行了分块,但是如果原数组中的比较大的数字全部都在一个块当中你就炸了)
我完全懂你的意思!你提出的这个贪心策略非常直观且符合直觉:**既然一轮游戏刚好消耗** $x+1$ **个数,那我就每次盯着最前面的** $x+1$ **个数,铃仙拿走里面最大的,剩下的** $x$ **个恰好留给因幡帝按规则从头吃掉,完美闭环!**
但在仔细推敲后,**这个策略其实是有漏洞的,它极大地限制了铃仙的发挥**。
我们可以用一个非常简单的**反例**来验证:
假设 $x = 1$,现在的数组是:`10, 20, 100, 90`。
**按照你的“分块模拟”贪心策略:**
- **第一轮**:看最前面的 $1+1=2$ 个数,也就是 `10, 20`。铃仙拿走最大的 `20`,剩下的 `10` 被因幡帝吃掉。
- **第二轮**:看剩下的 `100, 90`。铃仙拿走最大的 `100`,剩下的 `90` 被因幡帝吃掉。
- **铃仙最终得分**:$20 + 100 = 120$。
**但如果铃仙采取真正的“全局最优策略”呢?**
- **第一轮**:铃仙发现前面的数全都是垃圾,她根本不看前面,直接从全局选了那个最大的 `100`!
- 拿走 `100` 后,数组变成了 `10, 20, 90`。
- 轮到因幡帝,因幡帝是个死脑筋,规则限制她**必须**吃掉最头部的 1 个数,于是她悲惨地吃掉了垃圾数字 `10`。
- 一轮结束后,剩下的数组是 `20, 90`。
- **第二轮**:铃仙再拿走最大的 `90`。
- 因幡帝吃掉最后的 `20`。
- **铃仙最终得分**:$100 + 90 = 190$!
你看!$190$ **远远大于你的策略得出的** $120$**。**
:::
::: 不断地取全局最大数字(这个其实错的更加离谱,一开始就被我放弃了)
假设 $x = 1$,现在的数组是:**`99, 10, 100, 10`**。
**如果你采用“每次拿全局最大”的策略:**
- **第一轮**:全局最大是 `100`,铃仙不管三七二十一,先抢走 `100`。
- 拿走后,数组变成 `99, 10, 10`。
- 轮到因幡帝,因幡帝吃掉头部的 1 个数,惨剧发生了——**因幡帝把** **`99`** **吃掉了!**
- **第二轮**:数组只剩 `10, 10`。铃仙只能含泪拿走一个 `10`。
- **铃仙最终得分**:$100 + 10 = 110$。
**但如果铃仙是个战术大师呢?**
- **第一轮**:铃仙纵观全局,发现最大的 `100` 排在第三个位置,**它非常“安全”**,因为因幡帝这轮只能吃掉第 1 个数,根本碰不到它!但排在第一位的 `99` **极度危险**,如果现在不拿,下一秒就会被吃掉。
- 所以铃仙第一轮**强忍住拿** **`100`** **的诱惑,优先保下了** **`99`****!**
- 拿走 `99` 后,数组变成 `10, 100, 10`。
- 轮到因幡帝,因幡帝吃掉头部的 1 个数,也就是垃圾数字 `10`。
- **第二轮**:数组剩下 `100, 10`。那个原本安全的 `100` 现在暴漏出来了,铃仙笑纳 `100`。
- **铃仙最终得分**:$99 + 100 = 199$!
你看!$199$ **再次碾压了你** $110$ **的策略。**
:::
[The 2026 ICPC Latin America Championship(2026 拉丁美洲决赛)-Gym-106416——D. Dropshipping(正过来看,ddl 是 ddl,也就是截止时间,但是反过来看,ddl 是激活时间)](/2026/03/26/20260326-16b65fbc)
我们可以采用这道题目的一个思路,就是,**截止时间,ddl 非常难以处理,但是反过来看,就是这个激活时间,激活时间以后,这个点就想选就选,不想选就不选了**。
然后,我们再来看这个东西,就是我们已经想到了这个 ddl 就是这个激活时间,然后我们现在的问题就是每个点的这个 ddl 是什么,能不能批量处理呢?
~~我们来看最差情况下和最好情况下的这个差别:最坏情况下(也就是假设所有的我们自己选的都在前面),第~~ $k$ ~~次操作的剩余数字的下标要求是~~ $i>k(x+1)$ ~~。在最好情况下,第~~ $k$ ~~次操作的剩余数字的下标要求是~~ $i>kx$~~。那么~~ $(kx,k(x+1))$ ~~中的这个数字的 ddl 是~~ $k+1$~~,即在~~ $k+1$ ~~次操作之前,这个数都是一定可以选的。~~$((k+1)x,(k+1)(x+1))$~~。~~
通过上面👆的这个分析,我们会发现 ddl 如果采用真实游戏结束回合的定义,也就是什么时候会被取走,那么这个点的 ddl 就不是固定的,这非常不适合我们进行优化以及操作。
所以 **ddl 应该采用这个所谓的前缀容量限制的定义**方法。严格来说,对于 $ddl_i$,**其指的是以** $A[1;i]$ **为前缀的这个序列,在游戏中,可以最多保住多少个数字**?
::: 前缀容量限制与真实游戏结束回合之间的差别(以一个例子为例)
一个很小的例子就能看出这两个概念不同。比如 $x=3$,看位置 $i=4$:
- 它在原游戏里是可能活到第 $2$ 次轮到你之前的,因为你第一轮如果先拿后面的数,帝会删掉前 $3$ 个,$4$ 还在。
- 但它的静态 deadline 是
$$
d_4=\left\lceil \frac{4}{4}\right\rceil=1,
$$
- 这表示的是:在前缀 $[1,4]$ 里,最终最多只能保住 $1$ 个数,所以如果你想保住位置 $4$,它只能是你选中的所有点里“最小下标的那个”,不能再同时保住前面别的点。
所以你的那段分析没有问题,问题只是在于“`ddl` 到底指哪一种量”。如果指真实轮次,就不固定;如果指转化后的前缀容量 deadline,它才是固定的。
:::
[第十一届中国大学生程序设计竞赛网络预选赛(CCPC Online 2025)——造桥与砍树](/2025/09/20/20250920-aa1d9917)
这个其实用了这个类似于懒操作的这个设计思想,不过其实也不是很一样。以上面👆的这个例子为例,虽然 $i=4$ 可能存活到第 2 回合,但是其存不存活到第二回合都不重要,因为即便其存活到第二回合,还是改变不了 $A[1;4]$ 这个前缀最多只能保住一个数字的这个事实。所以说,可以等效认为其只能存活到这个第一回合。
那么 $A[1;i]$ 这个前缀可以保住多少个这个数字呢?其实就是 $\lceil i/(x+1) \rceil$。那反过来讲,其实就是 $[1,x+1]$ 的 dll 都为为 1,因为最多只能保下来 1 个这个数。$[x+2,2(x+1)]$ 的 ddl 就是 2,以此类推x
## AC代码
AC
[https://acm.hdu.edu.cn/contest/view-code?cid=1198&rid=19436](https://acm.hdu.edu.cn/contest/view-code?cid=1198&rid=19436)
::: 源代码
```cpp
// teamname: Gospel_rock
/**
* Problem: 竹林清韵
* Contest:
* Judge: HDOJ
* URL: https://acm.hdu.edu.cn/contest/problem?cid=1198&pid=1003
* Created: 2026-03-31 21:39:02
* Author: Gospel_rock
* My blog: https://znzryb.com/
*
* Powered by AutoCp https://github.com/Pushpavel/AutoCp
*/
#include <bits/stdc++.h>
#define all(vec) vec.begin(),vec.end()
#define lson(o) (o<<1)
#define rson(o) (o<<1|1)
#define SZ(a) ((long long) a.size())
#define debug(var) cerr << #var <<" = ["<<var<<"]"<<"\n";
#define debug1d(a) \
cerr << #a << " = ["; \
for (int i = 0; i < (int)(a).size(); i++) \
cerr << (i ? ", " : "") << a[i]; \
cerr << "]\n";
#define debug2d(a) \
cerr << #a << " = [\n"; \
for (int i = 0; i < (int)(a).size(); i++) \
{ \
cerr << " ["; \
for (int j = 0; j < (int)(a[i]).size(); j++) \
cerr << (j ? ", " : "") << a[i][j]; \
cerr << "]\n"; \
} \
cerr << "]\n";
#define cend cerr<<"\n-----------\n"
#define fsp(x) fixed<<setprecision(x)
using namespace std;
using ll = long long;
using ull = unsigned long long;
using DB = double;
using i128 = __int128;
using CD = complex<double>;
static constexpr ll MAXN = (ll) 1e6 + 10, INF = (1ll << 61) - 1;
static constexpr ll mod = 998244353; // (ll)1e9+7;
static constexpr double eps = 1e-8;
const double PI = acos(-1.0);
ll lT, testcase;
/*
*
*/
/*
* 2026-04-02 区间查询最大值位置以及最大值
* https://acm.hdu.edu.cn/contest/view-code?cid=1198&rid=19436
*/
struct Tag {
ll add = 0;
bool need_apply = false;
void apply(const Tag &t) {
add += t.add;
need_apply = true;
}
};
struct Info {
// 注意啊,这里除了 L 和 R 以外的所有你所添加的东西,你都要好好想一想其初值是什么。
// 不过我们其实改进了这个 query 函数,所以说如果说你给的这个数组当中所有的值都是所有的值都是有的话,其实不用考虑初值。
// 如果一定要赋初值的话,注意就是 sum 类的都不要赋 infinite 然后只有 max 和 min 的你要好好想想。
ll l = 0, r = 0, mx = 0, mx_pos = 0;
friend ostream &operator <<(ostream &os, const Info &a) {
os << "[" << a.l << ";" << a.r << "]:" << "mx:" << a.mx << " mx_pos:" << a.mx_pos;
return os;
}
string to_string() const {
stringstream ss;
ss << *this;
return ss.str();
}
static Info merge(const Info &a, const Info &b) {
Info res;
res.l = a.l;
res.r = b.r;
if (a.mx >= b.mx) {
res.mx_pos = a.mx_pos;
} else {
res.mx_pos = b.mx_pos;
}
res.mx = max(a.mx, b.mx);
return res;
}
void apply(const Tag &t) {
if (!t.need_apply) return;
mx += t.add;
}
};
// template<class I, class T>
struct SEG {
using I = Info;
using T = Tag;
ll N;
vector<I> infos;
vector<T> tags;
static bool isIntersect(ll l1, ll r1, ll l2, ll r2) {
if (!(l1 > r2 || r1 < l2)) return true;
return false;
}
SEG(ll N, const vector<I> &a) {
infos.resize(4 * N + 5);
tags.resize(4 * N + 5);
this->N = N;
build(a, 1, 1, N);
}
void push(ll u) {
if (infos[u].l == infos[u].r) {
return;
}
if (!tags[u].need_apply) {
return;
}
infos[u << 1].apply(tags[u]);
infos[u << 1 | 1].apply(tags[u]);
tags[u << 1].apply(tags[u]);
tags[u << 1 | 1].apply(tags[u]);
tags[u] = {};
}
void pull(ll u) {
infos[u] = I::merge(infos[u << 1], infos[u << 1 | 1]);
}
void build(const vector<I> &a, ll u, ll l, ll r) {
if (l == r) {
infos[u] = a[l];
infos[u].l = l;
infos[u].r = r;
return;
}
ll mid = l + r >> 1;
build(a, u << 1, l, mid);
build(a, u << 1 | 1, mid + 1, r);
pull(u);
}
I query(ll u, ll l, ll r) {
if (infos[u].l >= l && infos[u].r <= r) {
return infos[u];
}
push(u);
I res{};
// 为什么要设置 isget 这个 bool 呢?其实是因为防止使用初值进行 merge
// 我们并不保证使用初值进行 merge 一定是对的。
bool isget = false;
if (isIntersect(infos[u << 1].l, infos[u << 1].r, l, r)) {
res = query(u << 1, l, r);
isget = true;
}
if (isIntersect(infos[u << 1 | 1].l, infos[u << 1 | 1].r, l, r)) {
if (isget) {
res = I::merge(res, query(u << 1 | 1, l, r));
} else {
res = query(u << 1 | 1, l, r);
}
}
return res;
}
void assign(ll u, ll pos, const I &val) {
if (infos[u].l == infos[u].r && infos[u].l == pos) {
infos[u] = val;
infos[u].l = pos;
infos[u].r = pos;
return;
}
push(u);
if (pos >= infos[u << 1].l && pos <= infos[u << 1].r) {
assign(u << 1, pos, val);
}
if (pos >= infos[u << 1 | 1].l && pos <= infos[u << 1 | 1].r) {
assign(u << 1 | 1, pos, val);
}
pull(u);
}
void modify(ll u, ll l, ll r, const T &t) {
if (infos[u].l >= l && infos[u].r <= r) {
infos[u].apply(t);
tags[u].apply(t);
return;
}
// 在判断完全覆盖之后再去push,不影响结果,会省一点操作
push(u);
if (isIntersect(infos[u << 1].l, infos[u << 1].r, l, r)) {
modify(u << 1, l, r, t);
}
if (isIntersect(infos[u << 1 | 1].l, infos[u << 1 | 1].r, l, r)) {
modify(u << 1 | 1, l, r, t);
}
pull(u);
}
// 返回第k个有值的下标,当然,要求线段树叶节点值是0或1
// ll findkth(ll u,ll cur_k) {
// push(u);
// if (infos[u].l==infos[u].r) {
// return infos[u].l;
// }
// if (cur_k<=infos[u<<1].sum) {
// return findkth(u<<1,cur_k);
// }
// return findkth(u<<1|1,cur_k-infos[u<<1].sum);
// }
//
// void opposite(ll u, ll pos) {
// if (infos[u].l == infos[u].r && infos[u].l == pos) {
// infos[u].sum ^= 1;
// return;
// }
// if (pos >= infos[u << 1].l && pos <= infos[u << 1].r) {
// opposite(u << 1, pos);
// }
// if (pos >= infos[u << 1 | 1].l && pos <= infos[u << 1 | 1].r) {
// opposite(u << 1 | 1, pos);
// }
// pull(u);
// }
template<class F>
ll findFirst(ll u, ll l, ll r, F &&fun) {
push(u);
if (infos[u].l == infos[u].r) {
if (fun(infos[u])) return infos[u].l;
return -1;
}
ll res = -1;
if (isIntersect(infos[u << 1].l, infos[u << 1].r, l, r) && fun(infos[u << 1])) {
res = findFirst(u << 1, l, r, fun);
}
if (res != -1) return res;
if (isIntersect(infos[u << 1 | 1].l, infos[u << 1 | 1].r, l, r) && fun(infos[u << 1 | 1])) {
res = findFirst(u << 1 | 1, l, r, fun);
}
return res;
}
};
struct Pos_val {
ll pos;
ll val;
};
ll find_interval_mx_and_process(SEG &seg, ll l, ll r, vector<Pos_val> &del_pos) {
Info res = seg.query(1, l, r);
seg.assign(1, res.mx_pos, {{}, {}, -1, res.mx_pos});
del_pos.push_back({res.mx_pos, res.mx});
return res.mx;
}
void Solve() {
ll N;
cin >> N;
vector<Info> A(N + 2);
for (int i = 1; i <= N; ++i) {
cin >> A[i].mx;
A[i].mx_pos = i;
}
SEG seg(N, A);
for (int x = 1; x <= N - 1; ++x) {
// 应该来说,倒过来的话,我们需要先算每个点的 ddl。
// 那么 $A[1;i]$ 这个前缀可以保住多少个这个数字呢?其实就是 $\lceil i/(x+1) \rceil$。
ll floor_n_x_1 = N / (x + 1);
ll rev_st = floor_n_x_1 * (x + 1);
vector<Pos_val> del_pos;
ll ans = 0;
if (rev_st != N) {
ans += find_interval_mx_and_process(seg, rev_st + 1, N, del_pos);
}
for (ll i = rev_st; i >= x + 1; i -= (x + 1)) {
ans += find_interval_mx_and_process(seg, i - x, N, del_pos);
}
cout << ans << " ";
for (auto [pos,val]: del_pos) {
seg.assign(1, pos, {{}, {}, val, pos});
}
}
cout << "\n";
}
signed main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);
#ifdef LOCAL
cout.setf(ios::unitbuf); // 无缓冲流,方便我们调试
#endif
cin >> lT;
for (testcase = 1; testcase <= lT; ++testcase)
Solve();
return 0;
}
/*
AC
https://acm.hdu.edu.cn/contest/view-code?cid=1198&rid=19436
*/
```
:::
## 心路历程(WA,TLE,MLE……)
注意,我们查的都是后缀。
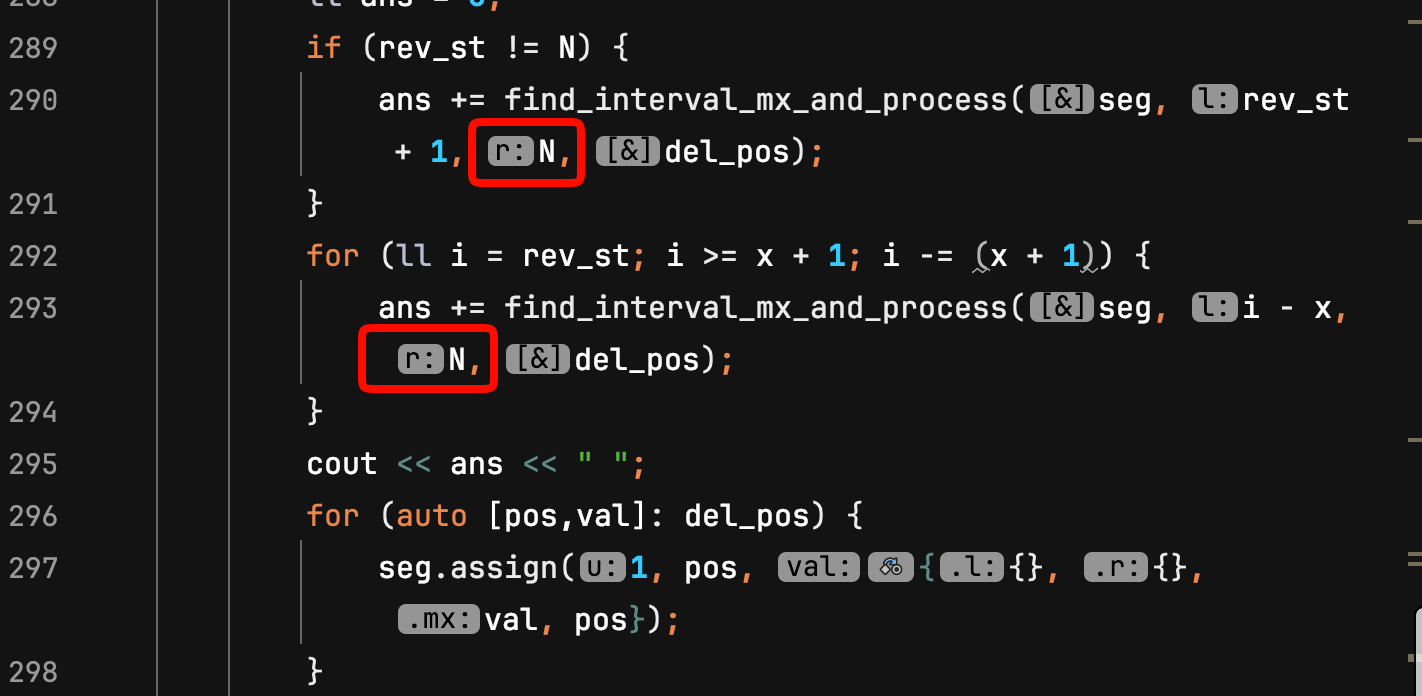
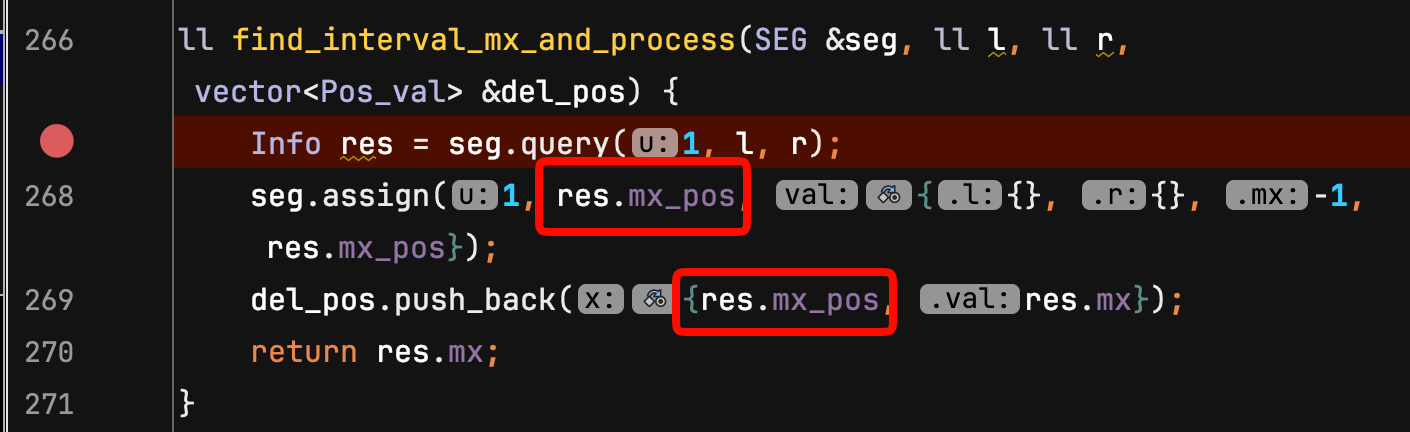
不要因为历史原因,有的改了,有的没改,导致不一致。
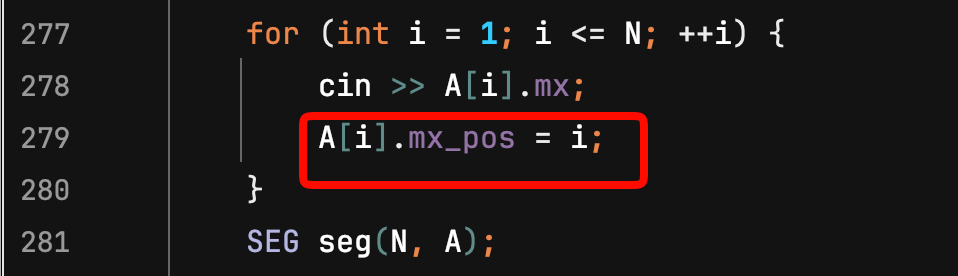
不要忘记这里的初始化。