2026 杭电春季联赛 3——1006-骰子大战(一定要好好读题,把题面中的所有限制信息都读到) · znzryb
## 题目大意
**题目描述**
需要构造 $n$ 个具有 $k$ 个面的骰子,每个面上的数字取值范围为 $0 \sim m$。
两个骰子进行对决时,随机掷出一个面,点数大者获胜。要求构造的骰子组合必须同时满足以下三个条件:
1. **循环劣势**:形成 $1 \to 2 \to 3 \to \dots \to n-1 \to n \to 1$ 的胜负关系。即 1 号骰子输给 2 号,2 号输给 3 号,……,$n$ 号输给 1 号(“输给”定义为在 $k \times k$ 种可能的掷出组合中,获胜的次数严格少于对方)。
1. **绝对无平局**:**每个数字至多只能出现在一个骰子上**,保证任意两个骰子对决时不可能掷出相同的点数。
1. **字典序最小**:将 1 号到 $n$ 号骰子上的所有数字按顺序拼接成一个长度为 $n \times k$ 的序列,要求该序列在所有合法方案中字典序最小。
**输入格式**
第一行输入一个正整数 $T$,表示测试数据组数。
接下来每组数据输入三个正整数 $n$、$m$、$k$,分别表示骰子数量、面上的最大允许数字、每个骰子的面数。
**输出格式**
对于每组数据,输出一行 $n \times k$ 个用空格分隔的整数,依次表示 1 号到 $n$ 号骰子各个面上的数字。
**样例数据**
**输入样例:**
```
1
3 4 3
```
**输出样例:**
```
0 3 3 1 1 4 2 2 2
```
**样例解释**
输入代表需要构造 $3$ 个骰子,每个骰子有 $3$ 个面,数字范围在 $0 \sim 4$ 之间。根据输出样例,三个骰子的构造如下:
- 1 号骰子:`[0, 3, 3]`
- 2 号骰子:`[1, 1, 4]`
- 3 号骰子:`[2, 2, 2]`
胜负关系验证(总对决情况数为 $3 \times 3 = 9$ 种):
- **1 号 vs 2 号**:1 号获胜的情况为 `3>1`(共 4 次),2 号获胜的情况为 `1>0`、`1>0`、`4>0`、`4>3`、`4>3`(共 5 次)。2 号胜率更高,**1 号输给 2 号**。
- **2 号 vs 3 号**:2 号获胜的情况为 `4>2`(共 3 次),3 号获胜的情况为 `2>1`(共 6 次)。3 号胜率更高,**2 号输给 3 号**。
- **3 号 vs 1 号**:3 号获胜的情况为 `2>0`(共 3 次),1 号获胜的情况为 `3>2`(共 6 次)。1 号胜率更高,**3 号输给 1 号**。
该方案数字各不相同(无平局),构成了 $1 \to 2 \to 3 \to 1$ 的循环劣势,且可以证明拼接后的序列 `0 3 3 1 1 4 2 2 2` 是所有满足条件的方案中字典序最小的。
## 思路讲解
::: gemini 的思路以及代码
[https://acm.hdu.edu.cn/contest/view-code?cid=1199&rid=17028](https://acm.hdu.edu.cn/contest/view-code?cid=1199&rid=17028)
这道题是一道非常精妙的构造题,涉及博弈与贪心策略。为了得到字典序最小的方案,我们需要深入分析骰子胜负的数学本质。
### 题目描述
我们需要构造 $n$ 个具有 $k$ 个面的骰子,每面的数字范围为 $0 \sim m$。要求形成 $1 \to 2 \to 3 \to \dots \to n \to 1$ 的循环劣势(即 $i+1$ 击败 $i$,$1$ 击败 $n$),其中“击败”定义为在 $k^2$ 次可能对决中获胜次数严格大于一半。不仅要满足该条件,还要使所有骰子的面按顺序拼接后的序列字典序最小。
### 解题思路
**1. 胜负条件的数学转化:**
由于不能平局,任意两个骰子对决共有 $k^2$ 种结果。“$B$ 击败 $A$” 等价于 $B$ 在对决中获胜的次数 $W(B, A) \ge \lfloor k^2/2 \rfloor + 1$。
令目标获胜次数为 $w = \lfloor k^2/2 \rfloor + 1$。
**2. 字典序最小的贪心框架:**
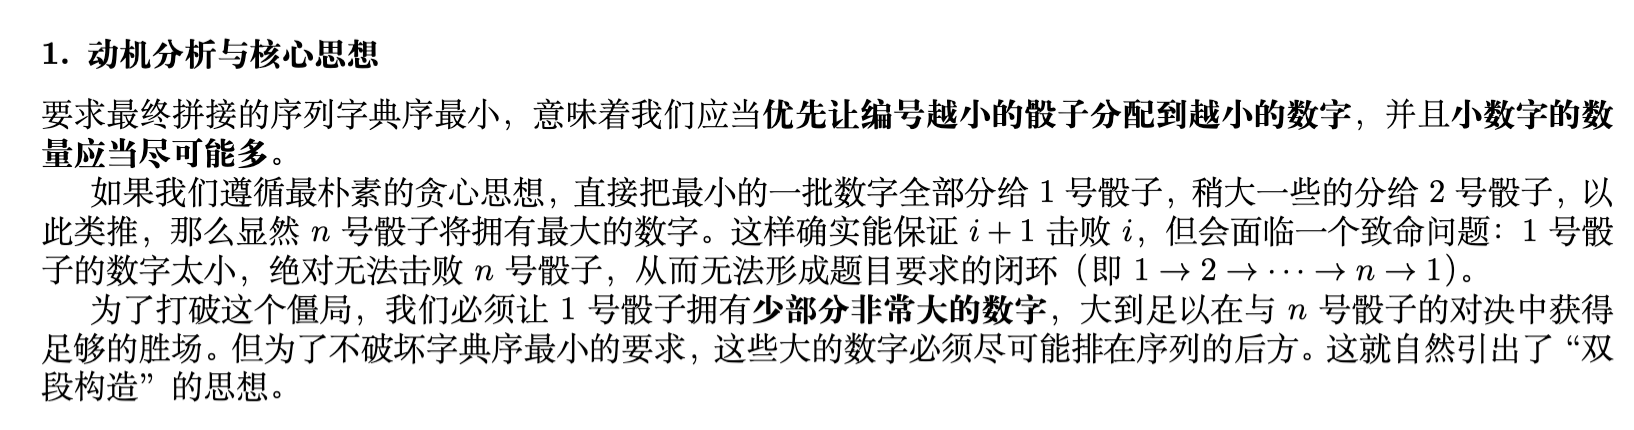
为了让整体拼接成的序列字典序最小,我们需要让 $1$ 号骰子的数字尽可能小,且小数字尽可能多;接着是 $2$ 号骰子,依此类推。
这启发我们设计一种 **“两阶段划分(双段构造)”** 的模式。将每个骰子 $i$ 的 $k$ 个面分成两部分:
- **早段(较小的数字)**:包含 $x_i$ 个面。
- **晚段(较大的数字)**:包含 $y_i = k - x_i$ 个面。
为了最小化序列,我们按照如下顺序分配逐渐递增的数值:
$1$ 号早段 $\to 2$ 号早段 $\dots \to n$ 号早段 $\to 1$ 号晚段 $\to 2$ 号晚段 $\dots \to n$ 号晚段。
同一段内的面赋予完全相同的数字,不同段赋予递增的数字。
**3. 推导核心不等式:**
在上述赋值顺序下,考虑相邻骰子的对决:
- $i+1$ **击败** $i$ **(**$1 \le i < n$**)**:
$i+1$ 的“早段”排在 $i$ 的“早段”之后,所以能赢 $x_{i+1} \times x_i$ 次。
$i+1$ 的“晚段”排在 $i$ 的两段之后,所以能赢 $y_{i+1} \times k$ 次。
总获胜次数:$x_{i+1} x_i + (k - x_{i+1}) k \ge w$
化简得:$x_{i+1} (k - x_i) \le k^2 - w$。令 $R = k^2 - w$,即 $x_{i+1} (k - x_i) \le R$。
- $1$ **击败** $n$:
$1$ 的“早段”排在最前面,赢不了 $n$ 的任何面。
$1$ 的“晚段”排在 $n$ 的“早段”之后、“晚段”之前,所以能赢 $y_1 \times x_n$ 次。
总获胜次数:$y_1 x_n = (k - x_1) x_n \ge w$。
**4. 贪心求解** $x_i$**:**
要使字典序最小,我们要尽可能让早段容量变大(即尽量最大化 $x_1, x_2, \dots$):
- 由 $(k - x_1) x_n \ge w$,且 $x_n \le k$,可知 $(k - x_1) k \ge w$,即 $x_1 \le k - \lceil w/k \rceil$。我们直接取最大值:$x_1 = k - \lceil w/k \rceil$。
- 对于后续的 $x_i$ ($i \ge 2$),根据 $x_i (k - x_{i-1}) \le R$,只要 $k - x_{i-1} > 0$,我们就贪心地取最大合法值:$x_i = \min(k, \lfloor R / (k - x_{i-1}) \rfloor)$。
(如果 $x_{i-1} = k$,意味着 $i$ 号骰子可以无条件获胜,此时直接设 $x_i = k$)。
由于题目保证解存在,$m$ 必定足够大,我们只需依据 $x_i$ 和 $y_i$ 生成非空的段并依次赋上递增的数字即可。
### 代码实现
```cpp
#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;
void solve() {
long long n, m, k;
if (!(cin >> n >> m >> k)) return;
// w 为获胜所需的最少胜场数,R 为不等式中的常数上限
long long w = (1LL * k * k) / 2 + 1;
long long R = 1LL * k * k - w; // 即 ceil(k^2 / 2) - 1
vector<long long> x(n + 1);
// 确定贪心的最优化分段容量
x[1] = k - (w + k - 1) / k; // k - ceil(w / k)
for (int i = 2; i <= n; i++) {
long long denom = k - x[i - 1];
if (denom == 0) {
x[i] = k;
} else {
x[i] = min((long long)k, R / denom);
}
}
// 记录分配的具体数字,用 -1 初始化
long long current_val = 0;
vector<long long> early_val(n + 1, -1);
vector<long long> late_val(n + 1, -1);
// 首先按顺序分配给所有存在的“早段”
for (int i = 1; i <= n; i++) {
if (x[i] > 0) {
early_val[i] = current_val++;
}
}
// 然后按顺序分配给所有存在的“晚段”
for (int i = 1; i <= n; i++) {
long long y = k - x[i];
if (y > 0) {
late_val[i] = current_val++;
}
}
// 按要求输出 n*k 个序列数字
bool first = true;
for (int i = 1; i <= n; i++) {
// 输出早段的数字
for (int j = 0; j < x[i]; j++) {
if (!first) cout << " ";
cout << early_val[i];
first = false;
}
// 输出晚段的数字
long long y = k - x[i];
for (int j = 0; j < y; j++) {
if (!first) cout << " ";
cout << late_val[i];
first = false;
}
}
cout << "\n";
}
int main() {
// 提升 I/O 效率
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int t;
if (cin >> t) {
while (t--) {
solve();
}
}
return 0;
}
```
### 复杂度分析
- **时间复杂度**:计算所有的段落分布 $x_i$ 只需要一重循环遍历 $1$ 到 $n$。为骰子面赋值和打印输出的循环总计处理了 $n \times k$ 次操作。所以处理每组测试数据的时间复杂度为 $\mathcal{O}(n \times k)$。结合总和 $\sum n \times k \le 2 \times 10^5$,算法能在极短时间内高速执行完成。
- **空间复杂度**:由于只存储了诸如 `x`、`early_val` 和 `late_val` 这些一维状态数组,占用空间为 $\mathcal{O}(n)$。这远低于题目宽松的 $512 \text{ MB}$ 空间限制。
:::
::: gemini 的 latex 代码
```latex
\documentclass{article}
\usepackage{graphicx} % Required for inserting images
\usepackage{amsmath} % bmatrix、cases、aligned 等数学环境
\usepackage{amssymb} % 数学符号宏包,支持 \mathbb 等
\usepackage{xeCJK} % 核心:添加这个宏包以支持中文
\usepackage{multicol} % 引入分栏宏包
\usepackage{xcolor} % 用于设置颜色;须先于 minted 以便 bgcolor 等生效
\usepackage[cachedir=_minted-main]{minted} % Pygments 高亮,需 -shell-escape + pygmentize
\usepackage[a4paper, left=2cm, right=2cm, top=2.5cm, bottom=2.5cm]{geometry}
% 保持与模板一致的 minted 样式
\setminted{
breaklines=true,
breakanywhere=true,
fontsize=\small,
frame=single,
bgcolor=gray!5,
tabsize=2,
}
\usepackage[colorlinks=true, linkcolor=black, anchorcolor=black, citecolor=black, filecolor=black, menucolor=black, runcolor=black, urlcolor=blue]{hyperref}
\begin{document}
\begin{center}
\section*{骰子大战}
\end{center}
\subsection*{题目大意}
有 $n$ 个具有 $k$ 个面的骰子,每面的数字范围为 $0 \sim m$。需要构造一种赋值方案,使得 $i+1$ 号骰子击败 $i$ 号骰子(其中 $1 \le i < n$),并且 $1$ 号骰子击败 $n$ 号骰子。这里的“击败”定义为:两个骰子组合的 $k^2$ 种对决结果中,获胜次数严格大于一半。
同时要求在所有满足上述循环劣势条件的方案中,将 $1$ 号到 $n$ 号骰子的所有面按顺序拼接后的序列\textbf{字典序最小}。题目保证解一定存在。
\subsection*{解题思路}
这道题的核心难点在于平衡“循环劣势”与“字典序最小”这两个看似矛盾的条件。我们将推导过程分为动机分析、构造模型、条件转化和贪心求解四个部分。
\subsubsection*{1. 动机分析与核心思想}
要求最终拼接的序列字典序最小,意味着我们应当\textbf{优先让编号越小的骰子分配到越小的数字},并且\textbf{小数字的数量应当尽可能多}。
如果我们遵循最朴素的贪心思想,直接把最小的一批数字全部分给 $1$ 号骰子,稍大一些的分给 $2$ 号骰子,以此类推,那么显然 $n$ 号骰子将拥有最大的数字。这样确实能保证 $i+1$ 击败 $i$,但会面临一个致命问题:$1$ 号骰子的数字太小,绝对无法击败 $n$ 号骰子,从而无法形成题目要求的闭环(即 $1 \to 2 \to \dots \to n \to 1$)。
为了打破这个僵局,我们必须让 $1$ 号骰子拥有\textbf{少部分非常大的数字},大到足以在与 $n$ 号骰子的对决中获得足够的胜场。但为了不破坏字典序最小的要求,这些大的数字必须尽可能排在序列的后方。这就自然引出了“双段构造”的思想。
\subsubsection*{2. 双段构造法模型}
我们将每个骰子的 $k$ 个面拆分为两个集合:
\begin{itemize}
\item \textbf{早段(分配较小的数字)}:设第 $i$ 号骰子的早段分配了 $x_i$ 个面。同一个骰子的所有早段面填写的数字完全相同。
\item \textbf{晚段(分配较大的数字)}:设第 $i$ 号骰子的晚段分配了 $y_i \leftarrow k - x_i$ 个面。同一个骰子的所有晚段面填写的数字完全相同。
\end{itemize}
如你所见,为了满足“字典序最小”,我们将较小的数字优先分配给靠前的骰子,于是天然形成了两个内部递增的顺序:$\text{早段}_1 < \dots < \text{早段}_n$ 以及 $\text{晚段}_1 < \dots < \text{晚段}_n$。
但\textbf{为什么早段和晚段之间,必须是完全割裂的“所有的早段都小于所有的晚段”}(即 $\text{早段}_n < \text{晚段}_1$)呢?能不能把它们的大小关系穿插一下?
这个强行不穿插的规定,是由\textbf{“$1$ 号骰子必须击败 $n$ 号骰子”这个游戏规则倒逼出来的。}
\begin{itemize}
\item \textbf{如果穿插了会发生什么(反证法)?}
假设我们不这么分,而是让 $\text{晚段}_1 < \text{早段}_n$。
因为对于任何一个骰子来说,它的早段肯定小于它的晚段,所以 $\text{早段}_1 < \text{晚段}_1$。
如果 $\text{晚段}_1 < \text{早段}_n$,那么对 $1$ 号骰子来说,它的\textbf{所有数字}($\text{早段}_1$ 和 $\text{晚段}_1$)就都严格小于 $n$ 号骰子的 $\text{早段}_n$ 了。
这意味着,$1$ 号骰子的\textbf{最大面},都比 $n$ 号骰子的\textbf{最小面}还要小。那 $1$ 号骰子打 $n$ 号骰子的胜率直接就是 $0$,绝对不可能击败 $n$ 号。
\item \textbf{破局的唯一方式}:
为了让 $1$ 号能够击败 $n$ 号,$1$ 号骰子必须拥有一些能够大过 $n$ 号的数字。为了不破坏整体序列尽量小的字典序,我们把这些大数字安排在 $1$ 号骰子的末尾(也就是 $\text{晚段}_1$)。为了让这部分数字能赢过 $n$ 号,它至少必须大过 $n$ 号最小的那批数字(也就是 $\text{早段}_n$)。
\item \textbf{贪心衔接形成最终顺序}:
因此,$\text{晚段}_1$ 被强行拔高,必须放在 $\text{早段}_n$ 之后,即确立了不可逾越的界限:$\text{早段}_n < \text{晚段}_1$。
而在确立了这个界限之后,剩下的数字继续按照字典序贪心法则,依次递增地分配给 $\text{晚段}_1 \to \text{晚段}_2 \to \dots \to \text{晚段}_n$。
\end{itemize}
这就是最终的全局数值大小分配顺序必须为以下形式的原因:
$$ \text{早段}_1 < \text{早段}_2 < \dots < \text{早段}_n < \text{晚段}_1 < \text{晚段}_2 < \dots < \text{晚段}_n $$
\subsubsection*{3. 胜负条件的代数推导}
任意两个骰子对决没有平局,共有 $k^2$ 种结果。要实现“击败”,获胜次数必须大于等于 $w \leftarrow \lfloor k^2/2 \rfloor + 1$。
在双段构造的大小关系下,我们来计算对决的胜场数:
\textbf{第一种情况:$1$ 号骰子击败 $n$ 号骰子}
$1$ 号的“早段”是全局最小的,无法击败 $n$ 号的任何面;
$1$ 号的“晚段”仅大于 $n$ 号的“早段”(因为 $\text{晚段}_1 < \text{晚段}_n$),因此 $1$ 号获胜的次数完全由“$1$ 号晚段”对战“$n$ 号早段”贡献。
所以 $1$ 号的总获胜次数为 $y_1 \times x_n$。我们需要满足:
$$ (k - x_1) \times x_n \ge w $$
\textbf{第二种情况:$i+1$ 号骰子击败 $i$ 号骰子(对于 $1 \le i < n$)}
\begin{itemize}
\item $i+1$ 号的“早段”排在 $i$ 号的“早段”之后,所以能击败 $i$ 号的“早段”,贡献胜场 $x_{i+1} \times x_i$。
\item $i+1$ 号的“晚段”排在 $i$ 号的“晚段”之后,自然也大于 $i$ 号的“早段”,所以能击败 $i$ 号的所有面,贡献胜场 $y_{i+1} \times k$。
\end{itemize}
总获胜次数要求:
$$ x_{i+1} \times x_i + y_{i+1} \times k \ge w $$
将 $y_{i+1} \leftarrow k - x_{i+1}$ 代入并化简:
$$ x_{i+1} \times x_i + k^2 - x_{i+1} \times k \ge w $$
$$ x_{i+1} \times (k - x_i) \le k^2 - w $$
为了方便,我们令常数 $R \leftarrow k^2 - w$。核心不等式即为:
$$ x_{i+1} \times (k - x_i) \le R $$
\subsubsection*{4. 贪心求解 $x_i$}
为了使字典序最小,我们需要让每个骰子尽量多地获得“早段”的容量(即小数字)。因此我们要尽可能地\textbf{最大化} $x_1$,$x_2$,$\dots$,$x_n$。
\begin{itemize}
\item \textbf{确定 $x_1$}:根据 $1$ 击败 $n$ 的条件 $(k - x_1) \times x_n \ge w$。由于 $x_n$ 的理论最大值为 $k$,要使 $x_1$ 尽可能大,就必须让 $(k - x_1)$ 尽可能小。最极限的情况是 $x_n$ 达到最大值 $k$,此时:
$$ (k - x_1) \times k \ge w \implies k - x_1 \ge \left\lceil \frac{w}{k} \right\rceil $$
因此,我们贪心地取 $x_1$ 的最大合法值:
$$ x_1 \leftarrow k - \left\lceil \frac{w}{k} \right\rceil $$
\item \textbf{确定 $x_{i}$(对于 $i \ge 2$)}:基于不等式 $x_i \times (k - x_{i-1}) \le R$,我们要贪心地让 $x_i$ 尽可能大:
\begin{itemize}
\item 如果 $k - x_{i-1} > 0$,则:
$$ x_i \leftarrow \min\left(k, \left\lfloor \frac{R}{k - x_{i-1}} \right\rfloor\right) $$
\item 如果 $x_{i-1} \leftarrow k$,意味着 $i-1$ 号骰子全部分配为早段。此时无论 $x_i$ 取何值,$i$ 号骰子的晚段都能击败 $i-1$ 号的全部面(晚段大于一切早段)。因此可以直接贪心地让 $x_i \leftarrow k$。
\end{itemize}
\end{itemize}
题目保证解一定存在,所以按照上述方式递推求出所有的 $x_i$ 后,我们依次给存在的早段和晚段分配严格递增的数值即可。
\subsection*{代码实现}
\begin{minted}{cpp}
#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;
void solve() {
long long n, m, k;
if (!(cin >> n >> m >> k)) return;
// w 为获胜所需的最少场数
long long w = (1LL * k * k) / 2 + 1;
// R 为推导出的常数界限
long long R = 1LL * k * k - w;
vector<long long> x(n + 1);
// 贪心确定 1 号骰子的最大早段容量
x[1] = k - (w + k - 1) / k;
// 递推贪心确定后续骰子的最大早段容量
for (int i = 2; i <= n; i++) {
long long denom = k - x[i - 1];
if (denom == 0) {
x[i] = k;
} else {
x[i] = min((long long)k, R / denom);
}
}
// current_val 用于按顺序分配递增的数值
long long current_val = 0;
vector<long long> early_val(n + 1, -1);
vector<long long> late_val(n + 1, -1);
// 阶段一:按顺序给所有骰子的“早段”分配小数值
for (int i = 1; i <= n; i++) {
if (x[i] > 0) {
early_val[i] = current_val++;
}
}
// 阶段二:按顺序给所有骰子的“晚段”分配大数值
for (int i = 1; i <= n; i++) {
long long y = k - x[i];
if (y > 0) {
late_val[i] = current_val++;
}
}
// 按照 1 到 n 号骰子的顺序,格式化输出所有的面
bool first = true;
for (int i = 1; i <= n; i++) {
// 输出早段
for (int j = 0; j < x[i]; j++) {
if (!first) cout << " ";
cout << early_val[i];
first = false;
}
// 输出晚段
long long y = k - x[i];
for (int j = 0; j < y; j++) {
if (!first) cout << " ";
cout << late_val[i];
first = false;
}
}
cout << "\n";
}
int main() {
ios_base::sync_with_stdio(false);
cin.tie(NULL);
int t;
if (cin >> t) {
while (t--) solve();
}
return 0;
}
\end{minted}
\subsection*{复杂度分析}
\begin{itemize}
\item \textbf{时间复杂度}:贪心推导 $x_i$ 的过程仅需一次遍历,时间复杂度为 $\mathcal{O}(n)$。为每个面输出数值的过程需要两层循环,执行次数恰好为 $\sum_{i=1}^n x_i + y_i = n \times k$。因此总时间复杂度为 $\mathcal{O}(n \times k)$,非常高效。
\item \textbf{空间复杂度}:存储状态数组及对应的分配数值所需的数组长度均为 $n+1$,整体占用空间为 $\mathcal{O}(n)$,能够轻松满足题目要求。
\end{itemize}
\end{document}
```
:::
首先,我们为什么会想到双段构造?呃,其实正常的思维链路应该是,我们先想怎么构造,
其实题面里面讲的非常清楚,一个骰子最多只会有两种不同的数字,每个数字仅能出现在至多一个骰子上。
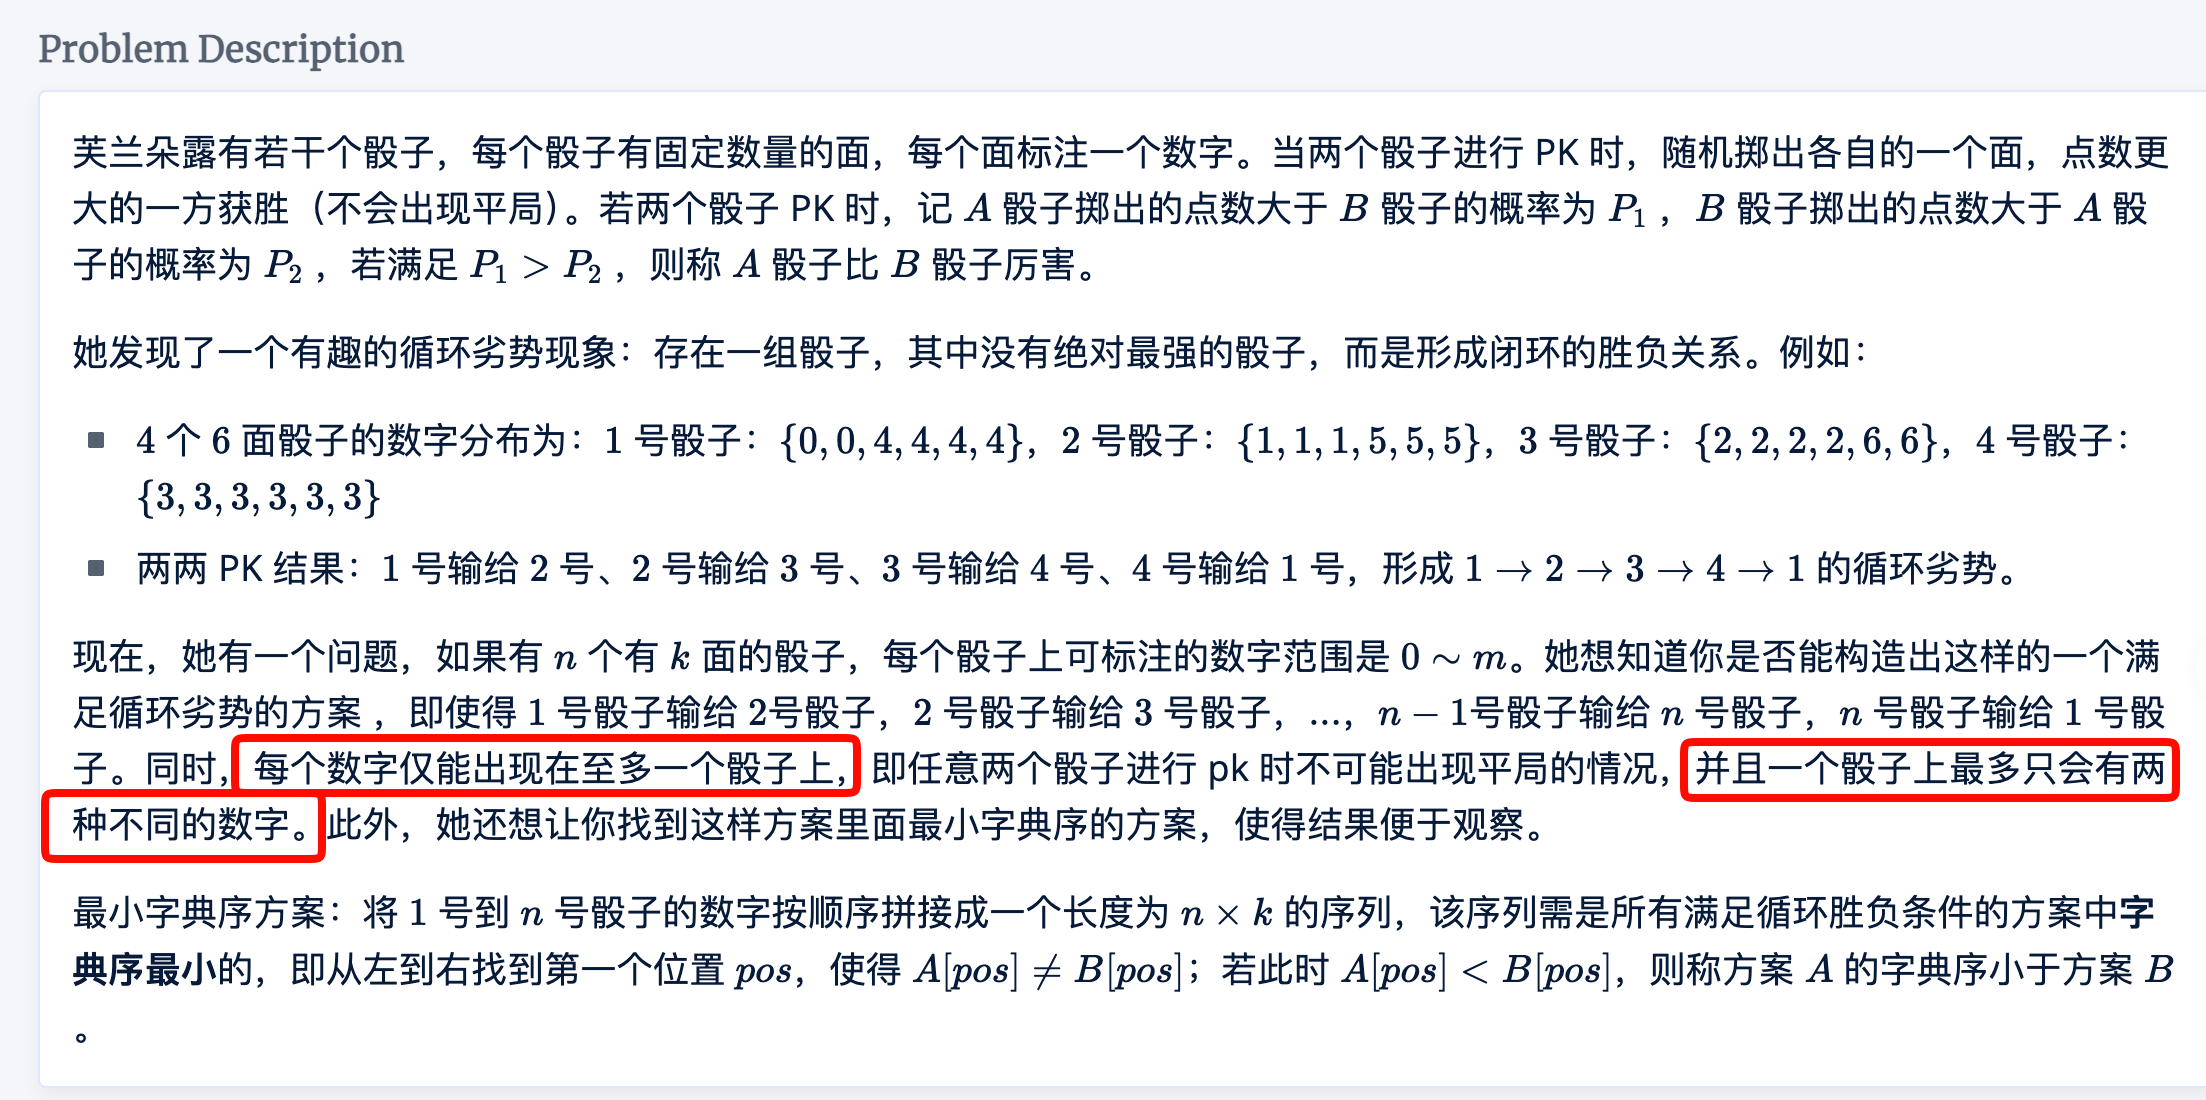
那都说了,最多两个数,那还能不是双段构造吗?
如果分成双段构造,那么不难看出:
$\text{早段}_1 < \text{早段}_2 < \dots < \text{早段}_n$,$\text{晚段}_1 < \text{晚段}_2 < \dots < \text{晚段}_n $(为了字典序最小,这两个条件是必须的),但是早晚段之间是什么关系呢?
注意啊,为了赢得游戏,$\text{早段}_n < \text{晚段}_1$,这个也是为了赢得游戏,满足所谓的“循环劣势要求”,所必须的这个构造,一个的最小的,大于一个的最大的,两者之间是绝对不会发生这个穿插的这个情况的,因此就是 $\text{早段}_1 < \text{早段}_2 < \dots < \text{早段}_n < \text{晚段}_1 < \text{晚段}_2 < \dots < \text{晚段}_n$。
okay,那这道题目比较关键的部分就做完了,当然,还需要处理一些细节问题,就是每个段的早段是几个数,晚段是几个数?
不过贪心求解的部分也不是那么容易的。
首先,先写出一系列的这个获胜条件:
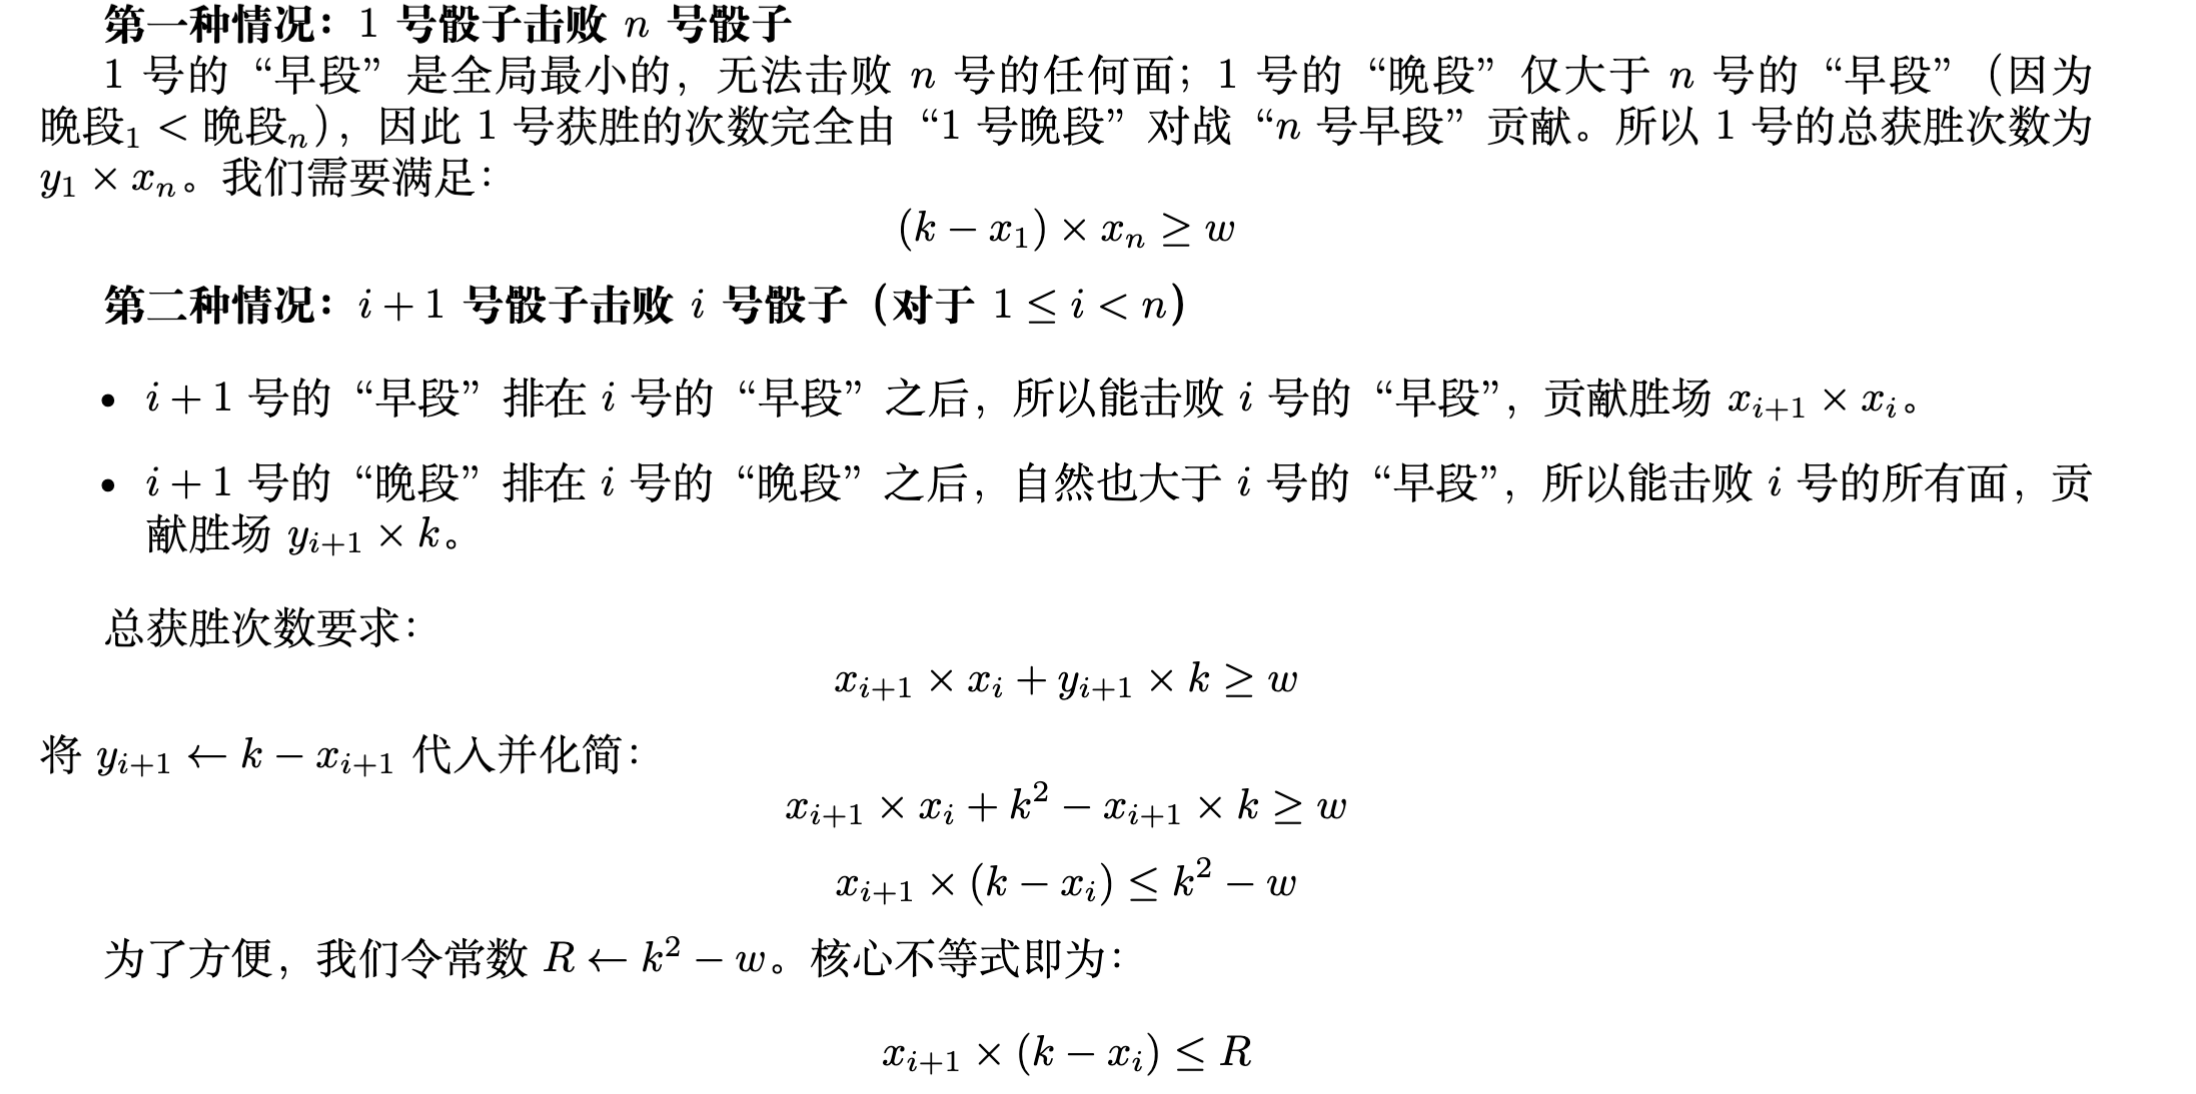
接着,我们要进行这个贪心求解,我们不难发现:
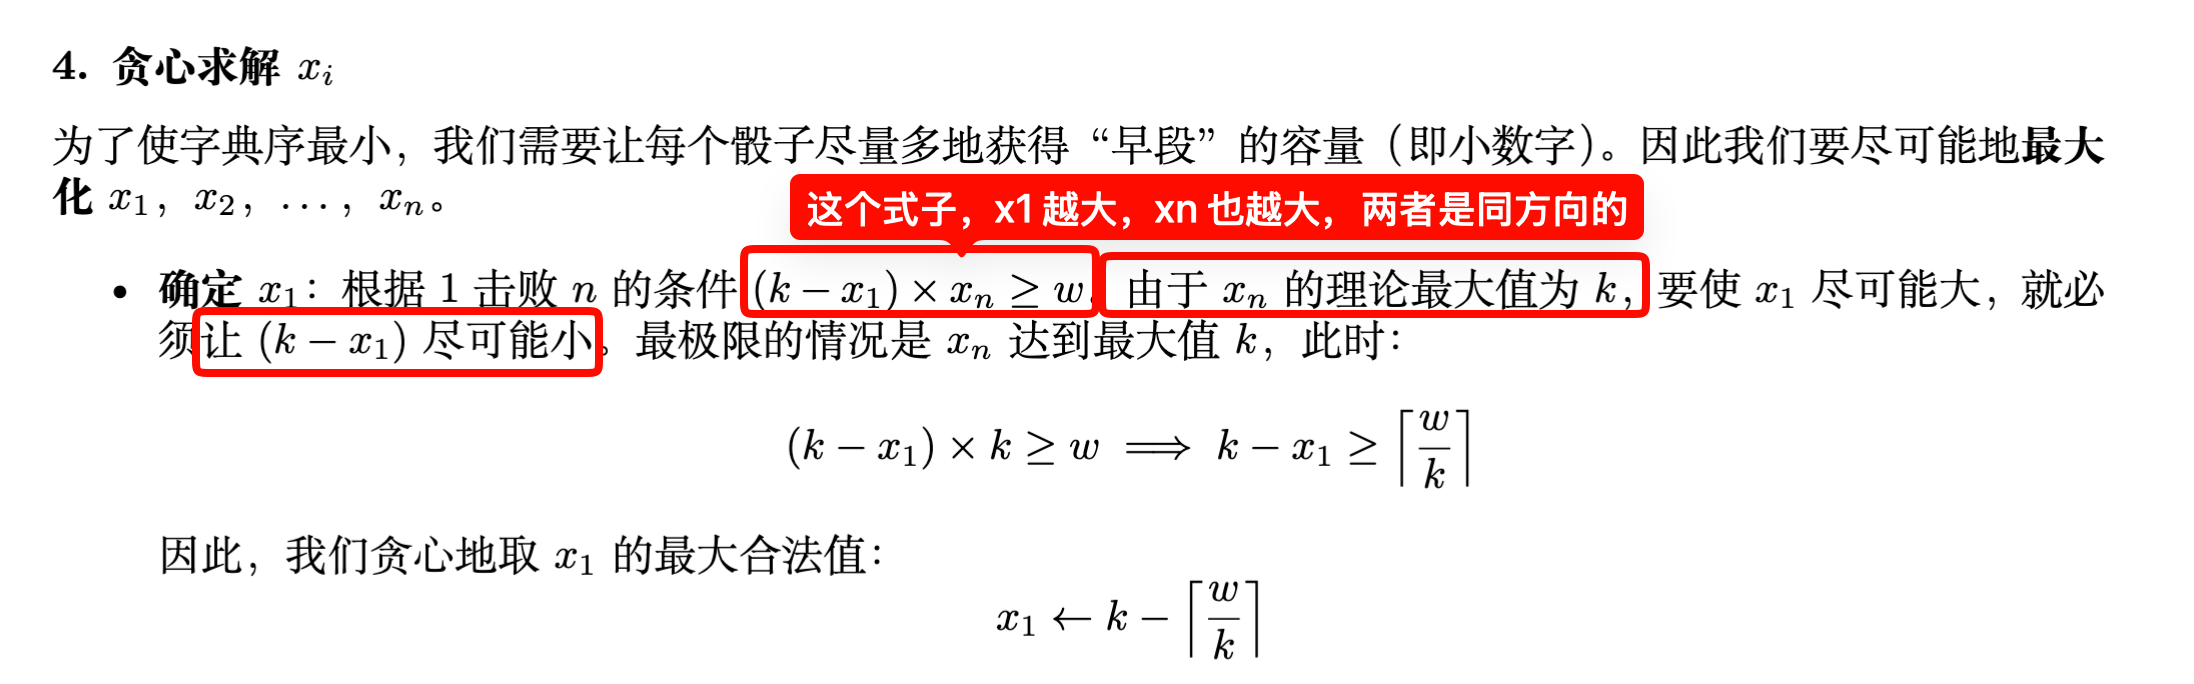
然后我们知道了 x1 的值,后面就用前面的限制,一个一个往后推就行了。
```cpp
void gen_eraly_seg() {
for (int i = 1; i <= N; ++i) {
ll early_sz;
if (i == 1) {
early_sz = K - (bound_win + K - 1) / K;
} else {
if (early_sz_ls[i - 1] - K == 0) {
early_sz = K;
} else {
early_sz = (bound_win - K * K) / (early_sz_ls[i - 1] - K);
}
}
early_sz = min(early_sz, K);
early_sz_ls[i] = early_sz;
for (int j = 1; j <= early_sz; ++j) {
ans_mat[i][j] = idx;
}
if (early_sz != 0) {
++idx;
}
}
}
void gen_late_seg() {
for (int i = 1; i <= N; ++i) {
for (int j = early_sz_ls[i] + 1; j <= K; ++j) {
ans_mat[i][j] = idx;
}
if (early_sz_ls[i] != K) {
++idx;
}
}
}
```
## AC代码
AC
[https://acm.hdu.edu.cn/contest/view-code?cid=1199&rid=17137](https://acm.hdu.edu.cn/contest/view-code?cid=1199&rid=17137)
::: 源代码
```cpp
// teamname: Gospel_rock
/**
* Problem: 骰子大战
* Contest:
* Judge: HDOJ
* URL: https://acm.hdu.edu.cn/contest/problem?cid=1199&pid=1006
* Created: 2026-04-06 16:32:16
* Author: Gospel_rock
* My blog: https://znzryb.com/
*
* Powered by AutoCp https://github.com/Pushpavel/AutoCp
*/
#include <bits/stdc++.h>
#define all(vec) vec.begin(),vec.end()
#define lson(o) (o<<1)
#define rson(o) (o<<1|1)
#define SZ(a) ((long long) a.size())
#define debug(var) cerr << #var <<" = ["<<var<<"]"<<"\n";
#define debug1d(a) \
cerr << #a << " = ["; \
for (int i = 0; i < (int)(a).size(); i++) \
cerr << (i ? ", " : "") << a[i]; \
cerr << "]\n";
#define debug2d(a) \
cerr << #a << " = [\n"; \
for (int i = 0; i < (int)(a).size(); i++) \
{ \
cerr << " ["; \
for (int j = 0; j < (int)(a[i]).size(); j++) \
cerr << (j ? ", " : "") << a[i][j]; \
cerr << "]\n"; \
} \
cerr << "]\n";
#define cend cerr<<"\n-----------\n"
#define fsp(x) fixed<<setprecision(x)
using namespace std;
using ll = long long;
using ull = unsigned long long;
using DB = double;
using i128 = __int128;
using CD = complex<double>;
static constexpr ll MAXN = (ll) 1e6 + 10, INF = (1ll << 61) - 1;
static constexpr ll mod = 998244353; // (ll)1e9+7;
static constexpr double eps = 1e-8;
const double PI = acos(-1.0);
ll lT, testcase;
/*
*
*/
struct Solve {
ll N, M, K;
ll idx = 0;
ll bound_win;
vector<vector<ll> > ans_mat;
vector<ll> early_sz_ls;
void gen_eraly_seg() {
for (int i = 1; i <= N; ++i) {
ll early_sz;
if (i == 1) {
early_sz = K - (bound_win + K - 1) / K;
} else {
if (early_sz_ls[i - 1] - K == 0) {
early_sz = K;
} else {
early_sz = (bound_win - K * K) / (early_sz_ls[i - 1] - K);
}
}
early_sz = min(early_sz, K);
early_sz_ls[i] = early_sz;
for (int j = 1; j <= early_sz; ++j) {
ans_mat[i][j] = idx;
}
if (early_sz != 0) {
++idx;
}
}
}
void gen_late_seg() {
for (int i = 1; i <= N; ++i) {
for (int j = early_sz_ls[i] + 1; j <= K; ++j) {
ans_mat[i][j] = idx;
}
if (early_sz_ls[i] != K) {
++idx;
}
}
}
Solve() {
cin >> N >> M >> K;
ans_mat.resize(N + 2, vector<ll>(K + 2));
bound_win = K * K / 2 + 1;
early_sz_ls.resize(N + 2);
gen_eraly_seg();
// #ifdef LOCAL
// debug1d(early_sz_ls);
// #endif
gen_late_seg();
for (int i = 1; i <= N; ++i) {
for (int j = 1; j <= K; ++j) {
cout << ans_mat[i][j] << " ";
}
}
cout << "\n";
}
};
signed main() {
ios::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);
#ifdef LOCAL
cout.setf(ios::unitbuf); // 无缓冲流,方便我们调试
#endif
cin >> lT;
for (testcase = 1; testcase <= lT; ++testcase)
Solve solve;
return 0;
}
/*
AC
https://acm.hdu.edu.cn/contest/view-code?cid=1199&rid=17137
*/
```
:::
## 心路历程(WA,TLE,MLE……)
除零错误——INTEGER_DIVIDE_BY_ZERO