从一条直线到逻辑回归:概率、似然和交叉熵 · znzryb
# 从一条直线到逻辑回归:概率、似然和交叉熵
主要参考:[Luis Serrano 的 A friendly introduction to Deep Learning and Neural Networks](https://www.youtube.com/watch?v=BR9h47Jtqyw)。本文是结合观看截图与手写批注整理的中文学习笔记,截图来自该视频及观看时的批注,原视频与画面版权归原作者所有。
接上一篇的分类问题,本篇按时间顺序放第 13—20 张截图。我们已经有一条用于分红蓝点的直线,现在希望模型不只回答“蓝还是红”,还回答“有多相信它是蓝色”。
## 一条边界,配上一整张概率地图
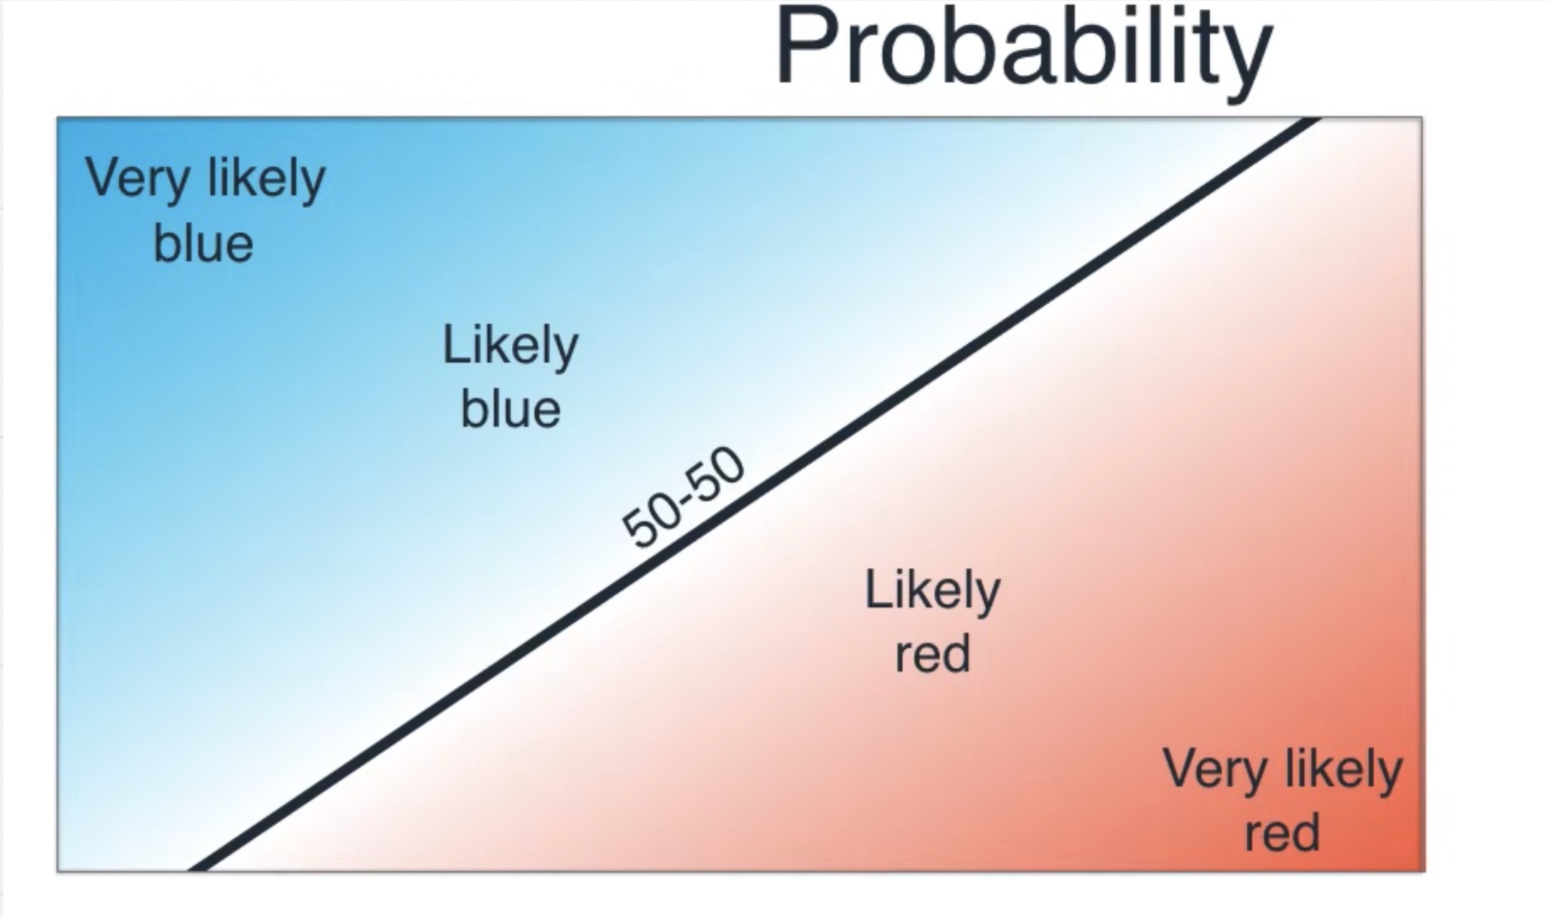
*截图 13|蓝色概率地图:边界附近难以判断,两侧逐渐变得确定*
把每个位置都涂上颜色:蓝得越深,模型越相信它是蓝点;红得越深,模型越相信它是红点;中间边界表示两种颜色各占一半。这是模型给出的概率估计,不是说现实一定按这张图生成,也不保证概率已经校准准确。
## 先计算一个分数,再把分数变成概率
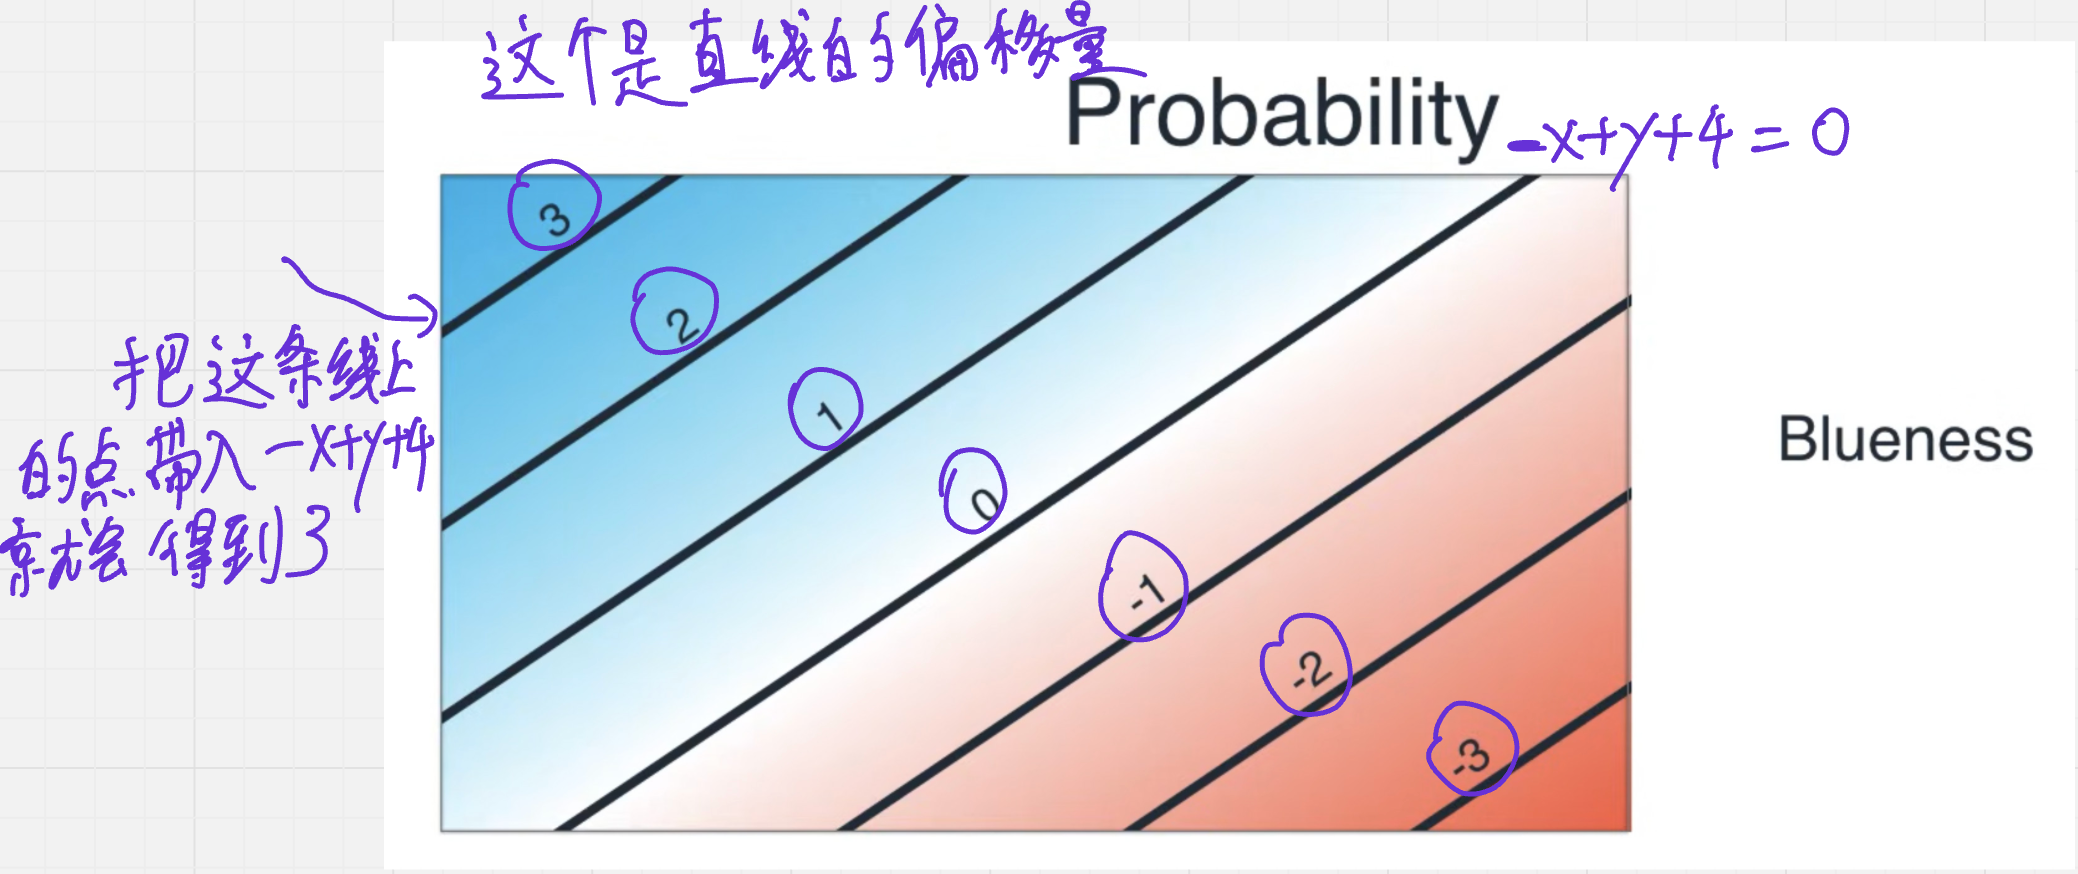
*截图 14|用一族平行线标出线性分数:零线两侧分别为正与负*
图中每条平行线上的数都一样,可以理解成“蓝色分数”。将横纵坐标分别乘一个系数,再加偏置,就得到这个分数。为避免把坐标与标签都叫作 $y$,这里将两个坐标记成 $x_1,x_2$:
$$
z=w_1x_1+w_2x_2+b.
$$
零分线是边界。正分更倾向蓝色,负分更倾向红色。这个分数不是概率,也不是未经归一化就能直接当成几何距离;同时放大系数和偏置,可以保持零线不动,却让分数变化更陡。
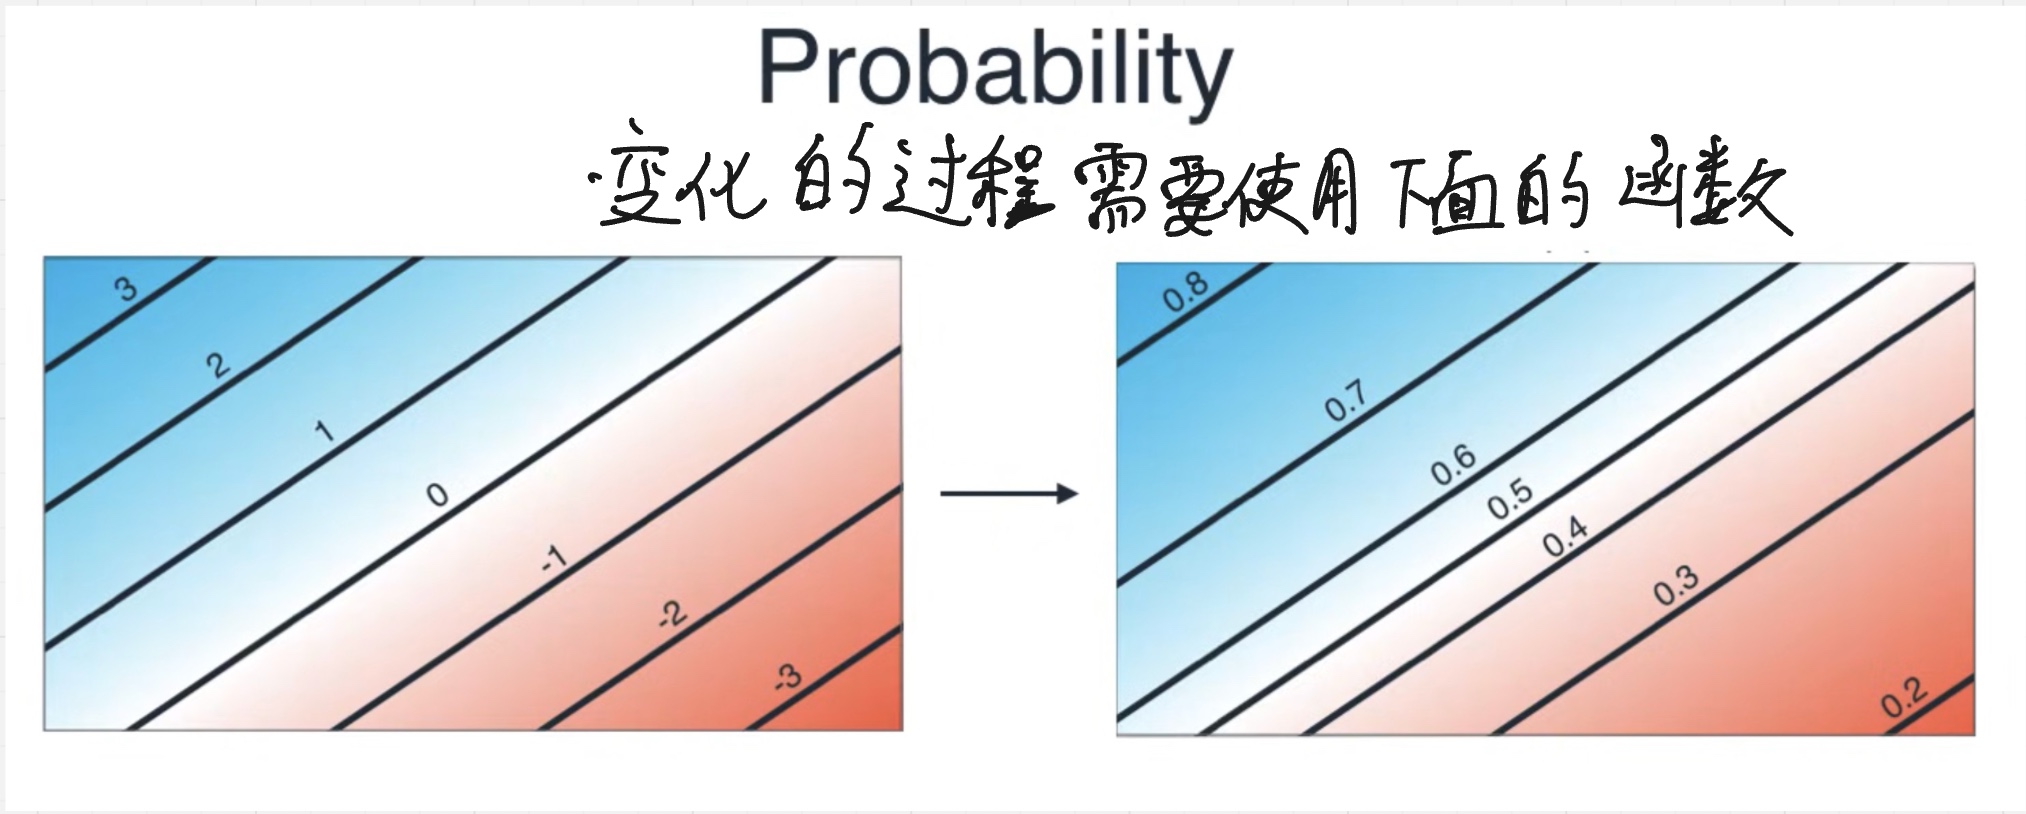
*截图 15|从任意实数分数,转换为零到一之间的蓝色概率*
我们希望保留分数的大小关系,同时把无界的数压到 0 与 1 之间。这样零分变成一半,较大的正数变成接近 1,较大的负数变成接近 0。
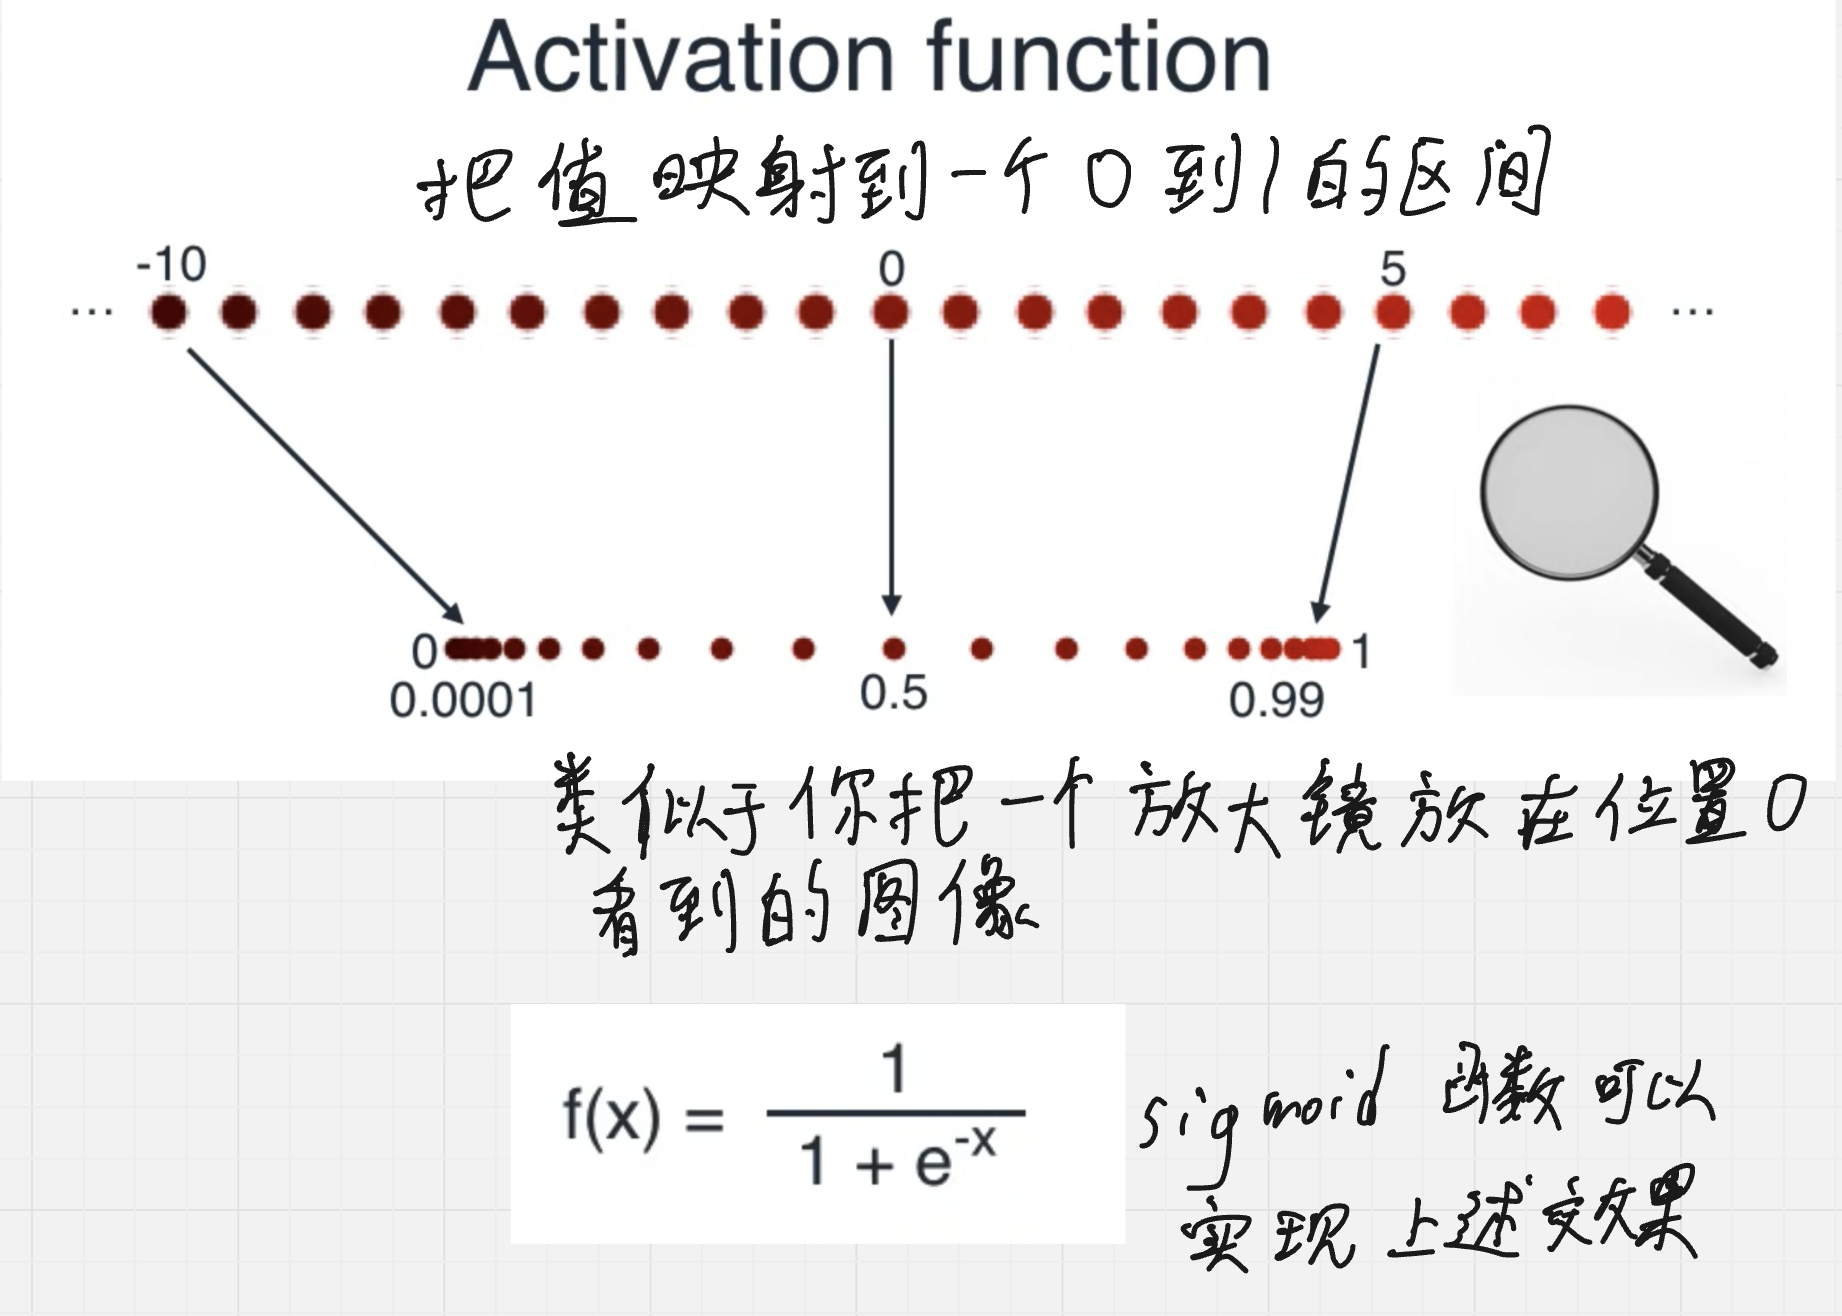
*截图 16|Sigmoid:把实数分数平滑映射到零和一之间*
这个转换使用 Sigmoid。它对有限输入的输出严格位于 0 与 1 之间:
$$
p=\sigma(z)=\frac{1}{1+e^{-z}}.
$$
例如零分对应 $0.5$;分数为 $5$ 时约为 $0.9933$;分数为 $-10$ 时约为 $0.0000454$。中间变化明显,两端逐渐饱和。“激活函数都把值压到 0—1”则不是通用定义,这里讲的是 Sigmoid,其他激活函数未必如此。
约定蓝色标签为 $t=1$,红色为 $t=0$。模型输出 $p$ 表示蓝色概率,因此红色概率是 $1-p$。采用 $0.5$ 作为阈值时,逻辑回归的分类边界仍然是一条直线;Sigmoid 本身没有把这个边界变弯。
## 似然:让模型尽量相信已经观察到的真实标签
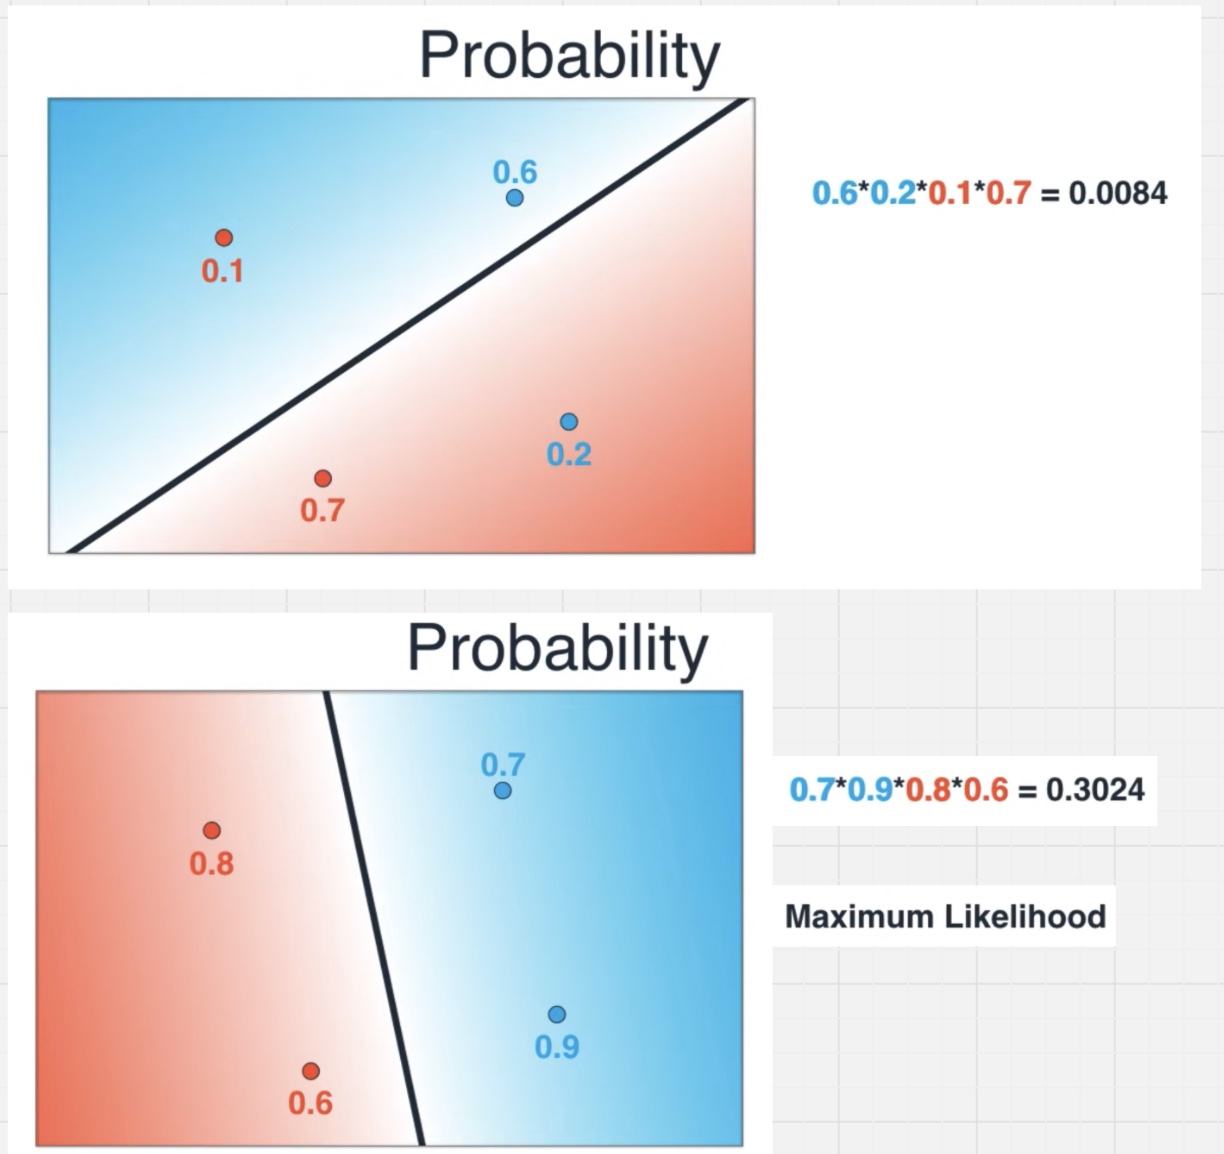
*截图 17|比较两组参数:把每个点真实颜色对应的概率乘起来*
截图上给某个点标的 $0.1$ 或 $0.7$,要结合它的真实颜色读:用于相乘的是**真实颜色对应的概率**,不一定全是蓝色概率。红点要取 $1-p$,蓝点才取 $p$。
在通常的条件独立建模假设下,整组已观察标签的似然是这些数的乘积。第一种边界对四个真实标签给出的概率相乘,是:
$$
0.6\times0.2\times0.1\times0.7=0.0084.
$$
第二种边界得到的是:
$$
0.7\times0.9\times0.8\times0.6=0.3024.
$$
第二种参数让已观察到的真实标签整体上更可信,这就是最大似然的直觉。这里的 $0.3024$ 按截图中的四个数直接计算;字幕中偶尔出现的 $0.324$ 不应照抄。
## 为什么要取负对数
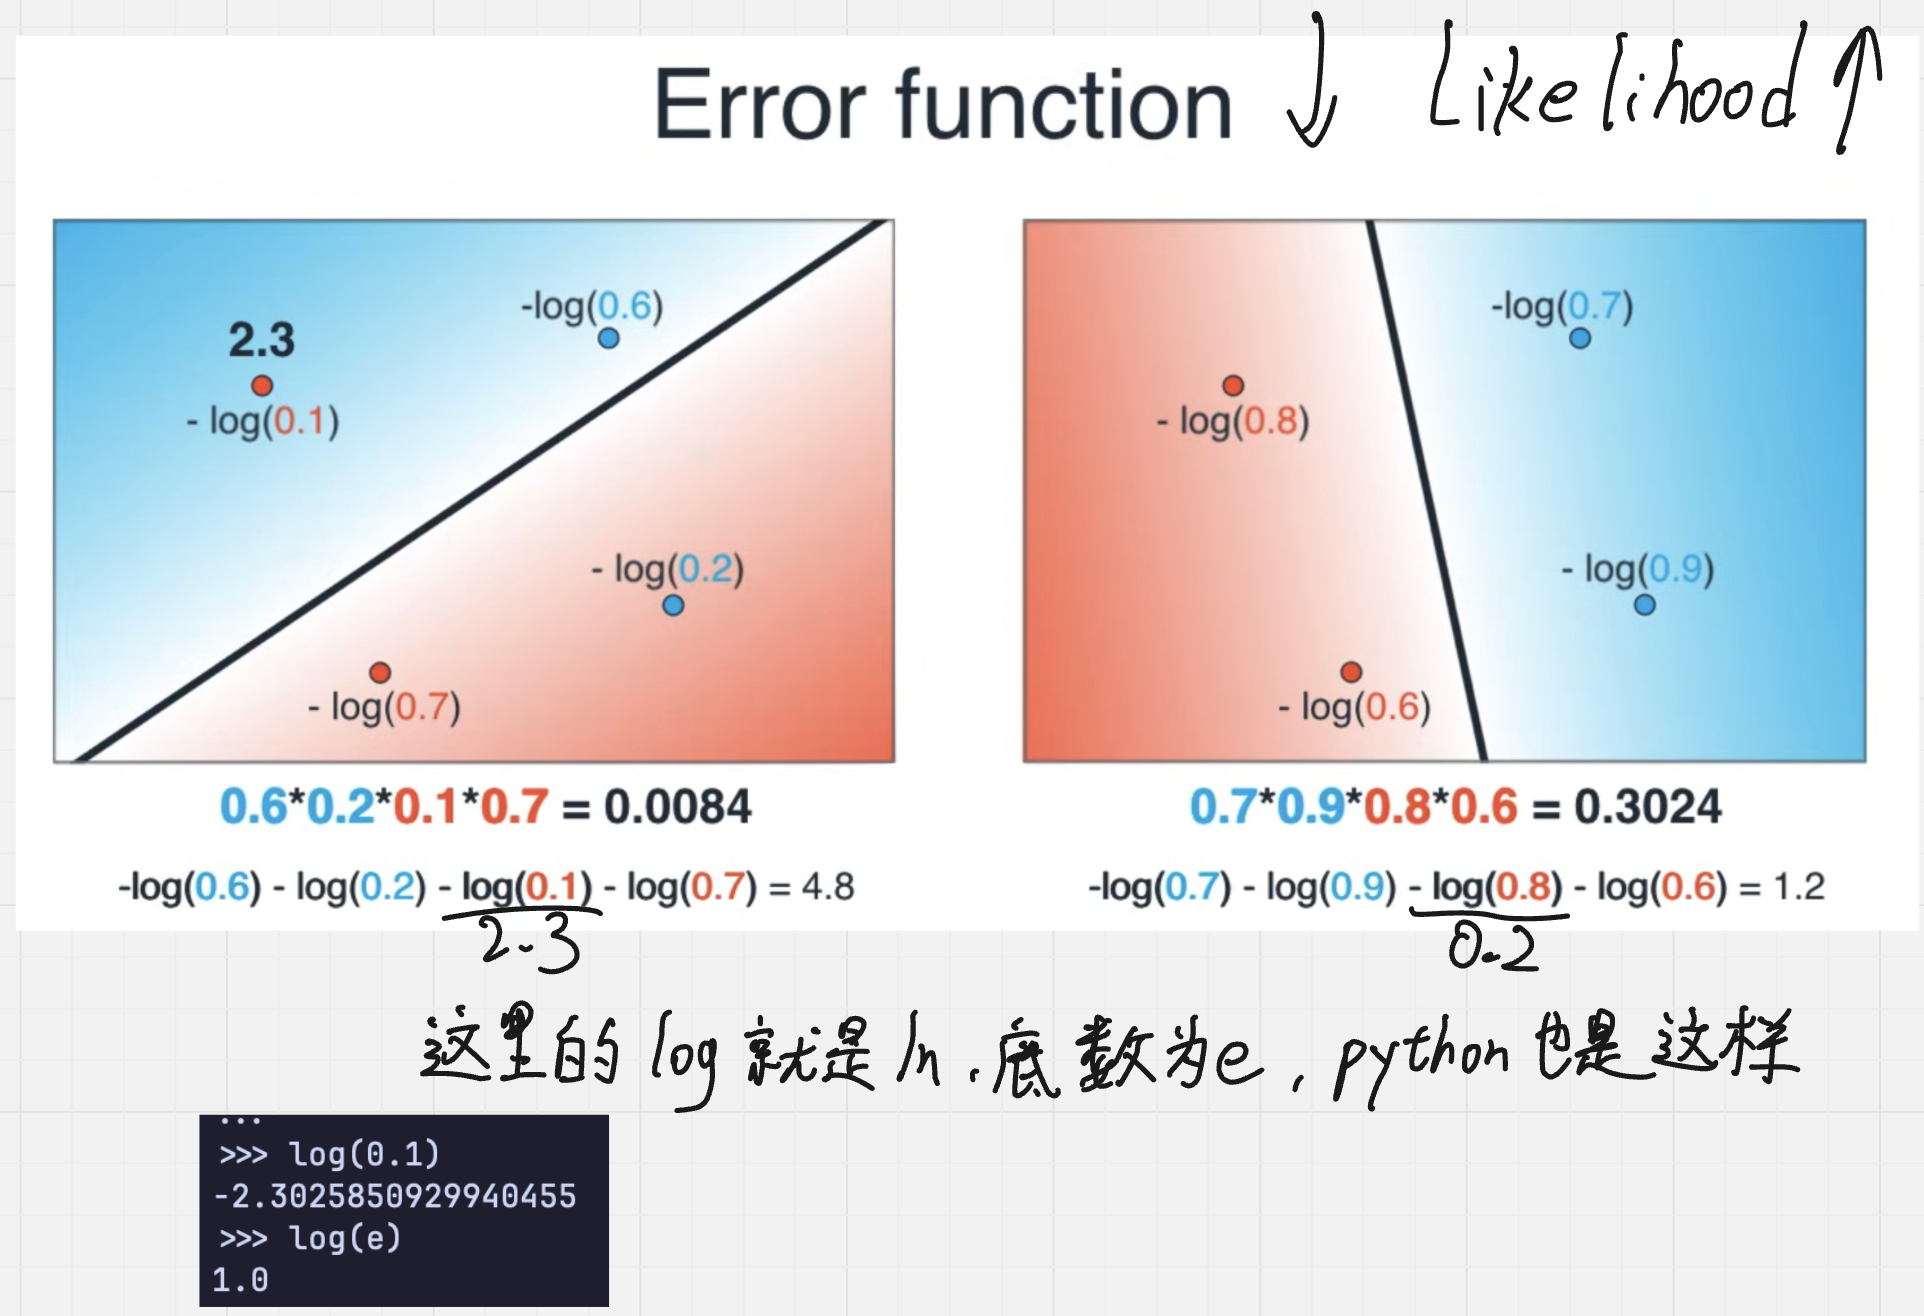
*截图 18|负对数把概率乘积变成可相加的损失:似然越大,损失越小*
这张图把完整评价过程串起来了:给每个点的真实标签一个概率,取负对数,再相加。对数能把乘法变成加法;加上负号以后,“最大化似然”就变成“最小化损失”。实际实现也能避免先乘一长串小概率导致数值下溢。
设某个点真实标签对应的概率为 $q$。若模型只给它 $0.1$,惩罚约为 $2.303$;给它 $0.9$,惩罚约为 $0.105$。**自信地预测错,会受到很大惩罚;相信真实标签,惩罚就小。**
对上面两组数,负对数总损失分别约为 $4.7795$ 与 $1.1960$。截图取整写成 $4.8$ 与 $1.2$,对应的是自然对数。
把蓝红两种情况合并,单个样本的损失是二元交叉熵:
$$
\ell(t,p)=-\bigl[t\ln p+(1-t)\ln(1-p)\bigr].
$$
当 $t=1$ 时只剩 $-\ln p$;当 $t=0$ 时只剩 $-\ln(1-p)$。把它们加起来或取平均,就得到了上一篇需要的平滑训练目标。总和与平均值只差样本数这一倍数,实际更新时需要相应考虑学习率。
## 原来,一个逻辑回归模型就是一个神经元
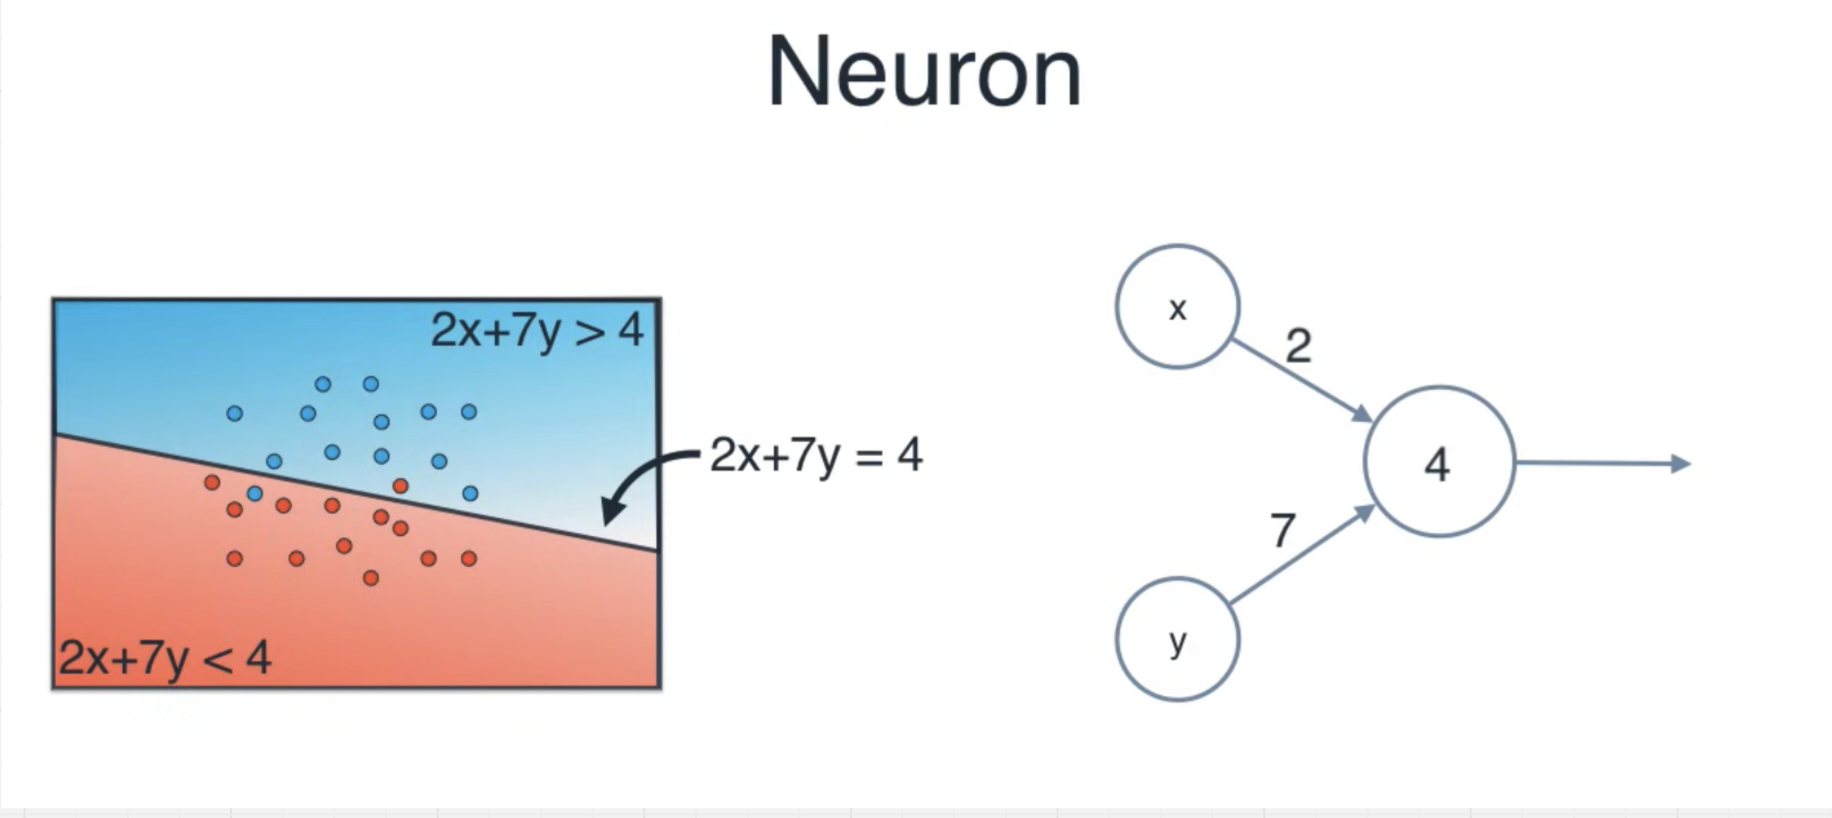
*截图 19|直线的两个系数变成输入连线的权重,阈值编码在结点中*
图中的边界是 $2x+7y=4$。若把“大于 4 的一侧”作为蓝色区域,先计算 $2x+7y-4$,再送进 Sigmoid,就得到一个神经元的输出。
这张截图把数字 $4$ 画在结点里,是用**阈值**记法;按常见的“加上偏置”记法,偏置应当是 $-4$。两种写法描述的是同一条线,不能把结点里的阈值原样当成相加的偏置。
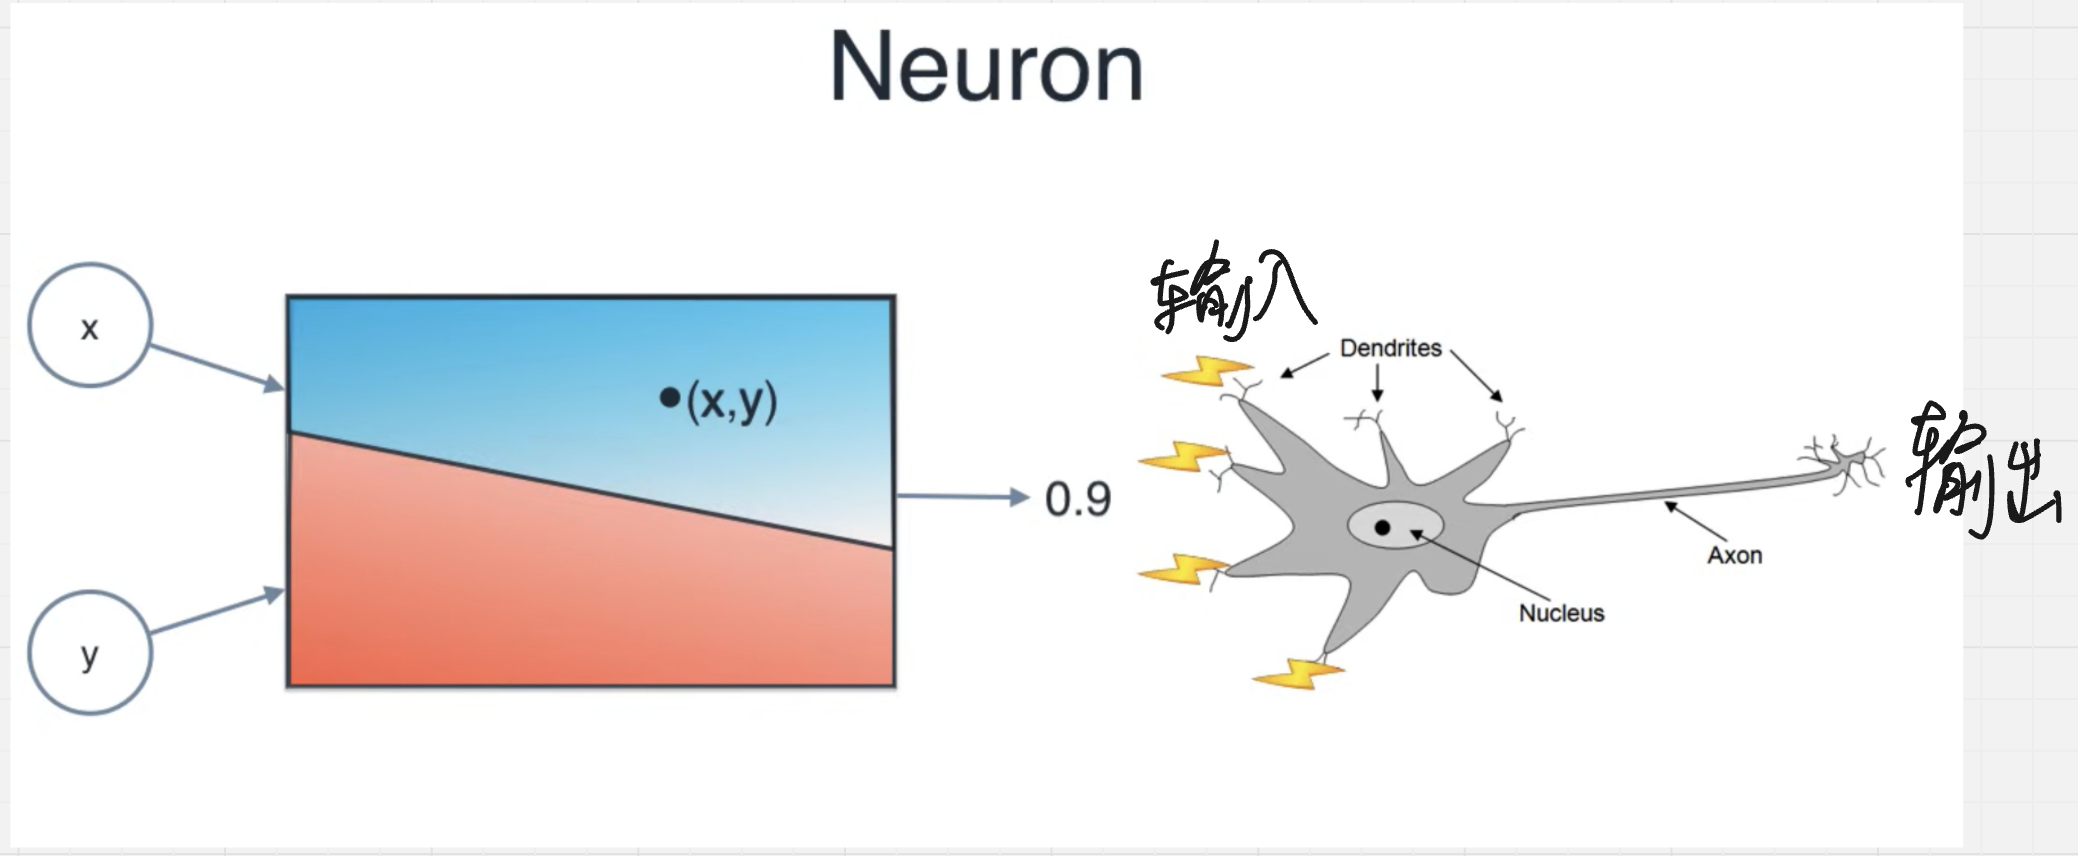
*截图 20|一个计算神经元接收输入,输出一个数;生物神经元只是启发性的类比*
把这一单元拆开看,只有三步:输入乘权重、求和加偏置、经过激活函数。图里的输出 $0.9$,可以解释为这个模型给出的蓝色概率。
所以不必把“神经元”想得神秘:在这里,它就是一个可以学习参数的小函数。生物神经元的图有助于记住输入与输出关系,却不意味着这个公式精确模拟了大脑。下一篇把多个这样的函数接起来,就会看到弯曲边界是怎么出现的。