从下山理解机器学习:为什么不能只数错了几个点 · znzryb
# 从“下山”理解机器学习:为什么不能只数错了几个点
主要参考:[Luis Serrano 的 A friendly introduction to Deep Learning and Neural Networks](https://www.youtube.com/watch?v=BR9h47Jtqyw)。本文是结合观看截图与手写批注整理的中文学习笔记,截图来自该视频及观看时的批注,原视频与画面版权归原作者所有。
这组笔记按截图的时间顺序展开,共 35 张原图,本篇放第 01—12 张。阅读只需要知道平面上的点、直线,以及导数描述变化快慢。不必先背那张密密麻麻的神经网络结构图。
先看整个学习过程:**规定什么算错,算出当前错得多严重,再调整参数,让错误逐步减小。**视频用找蛋糕和下山解释这件事。
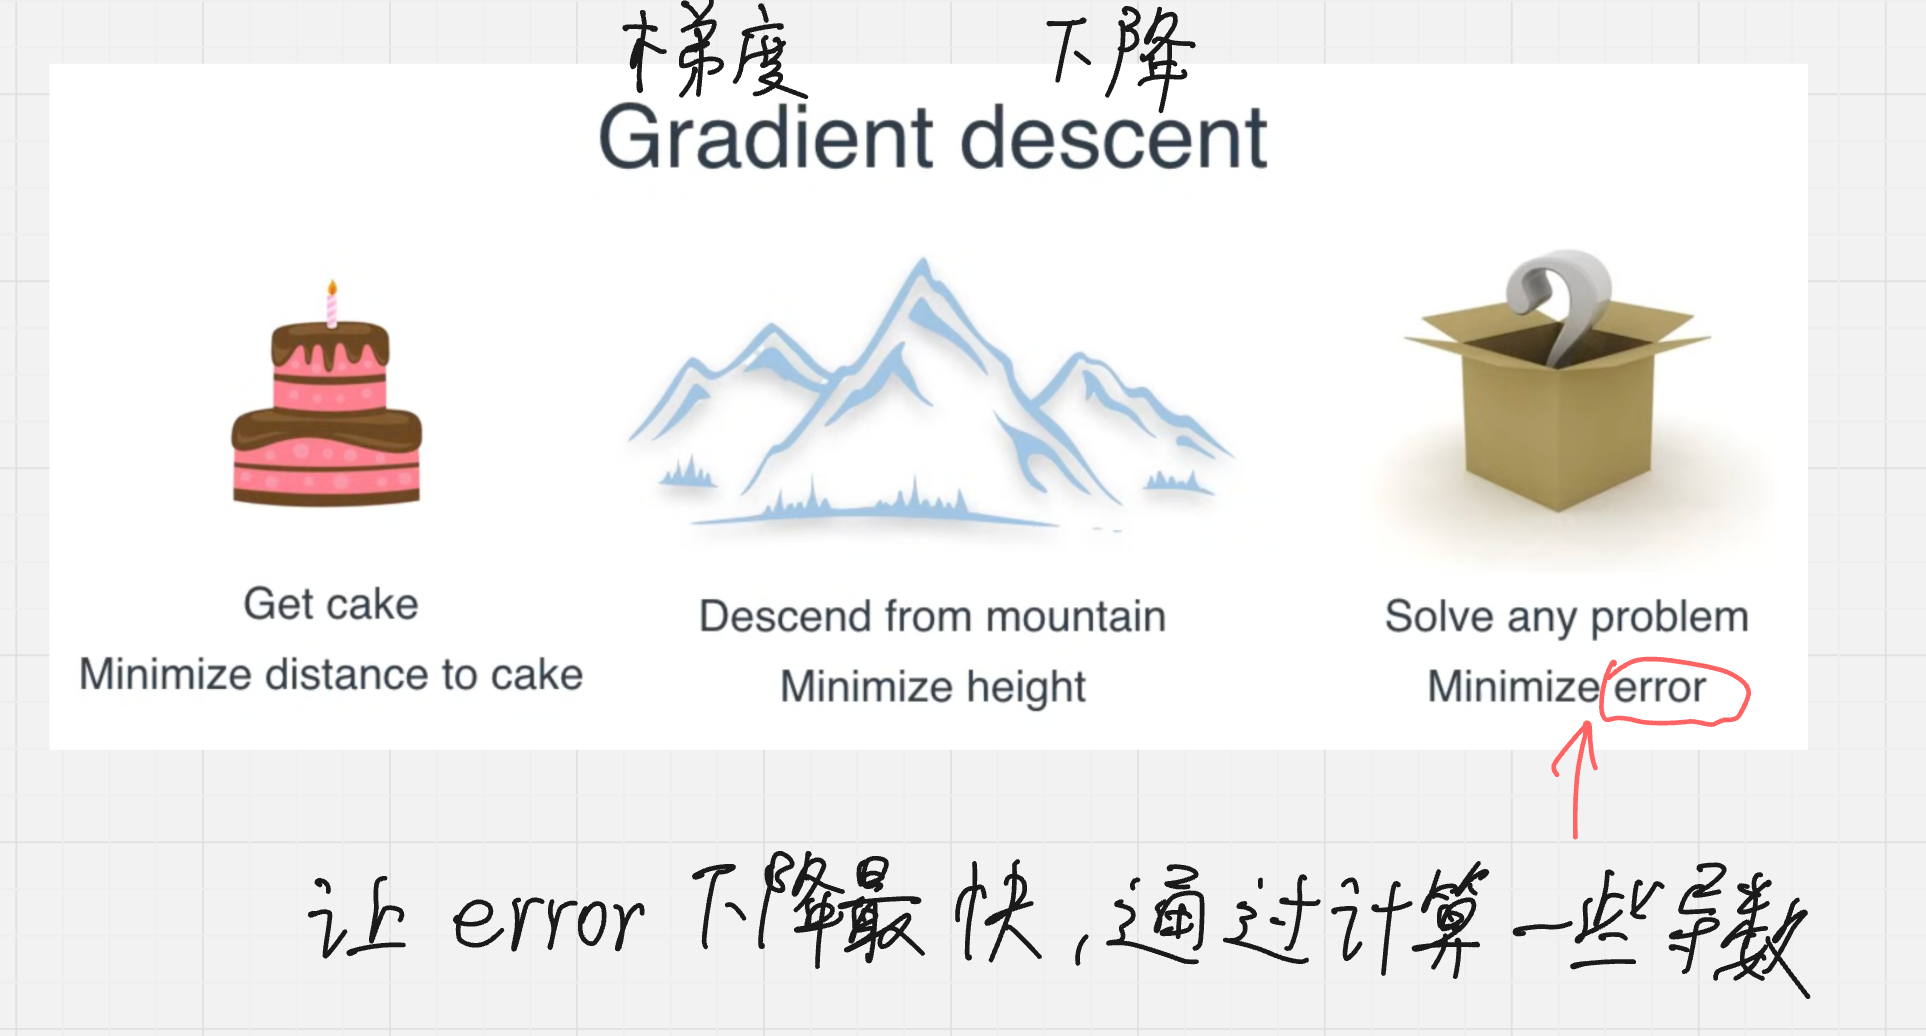
*截图 01|找蛋糕、下山和训练模型,都可以先定义一个需要减小的量*
找蛋糕时,关心离蛋糕有多远;下山时,关心当前位置有多高;训练模型时,关心预测与真实答案差得有多大。最后这个量叫损失。它把“模型表现不好”变成了可以比较、可以优化的数值。
不过,下山只是优化的比喻。训练损失下降,并不自动意味着在新数据上也预测得好;模型还需要用未参与训练的数据检验。
## 先把密密麻麻的网络放回一个具体任务
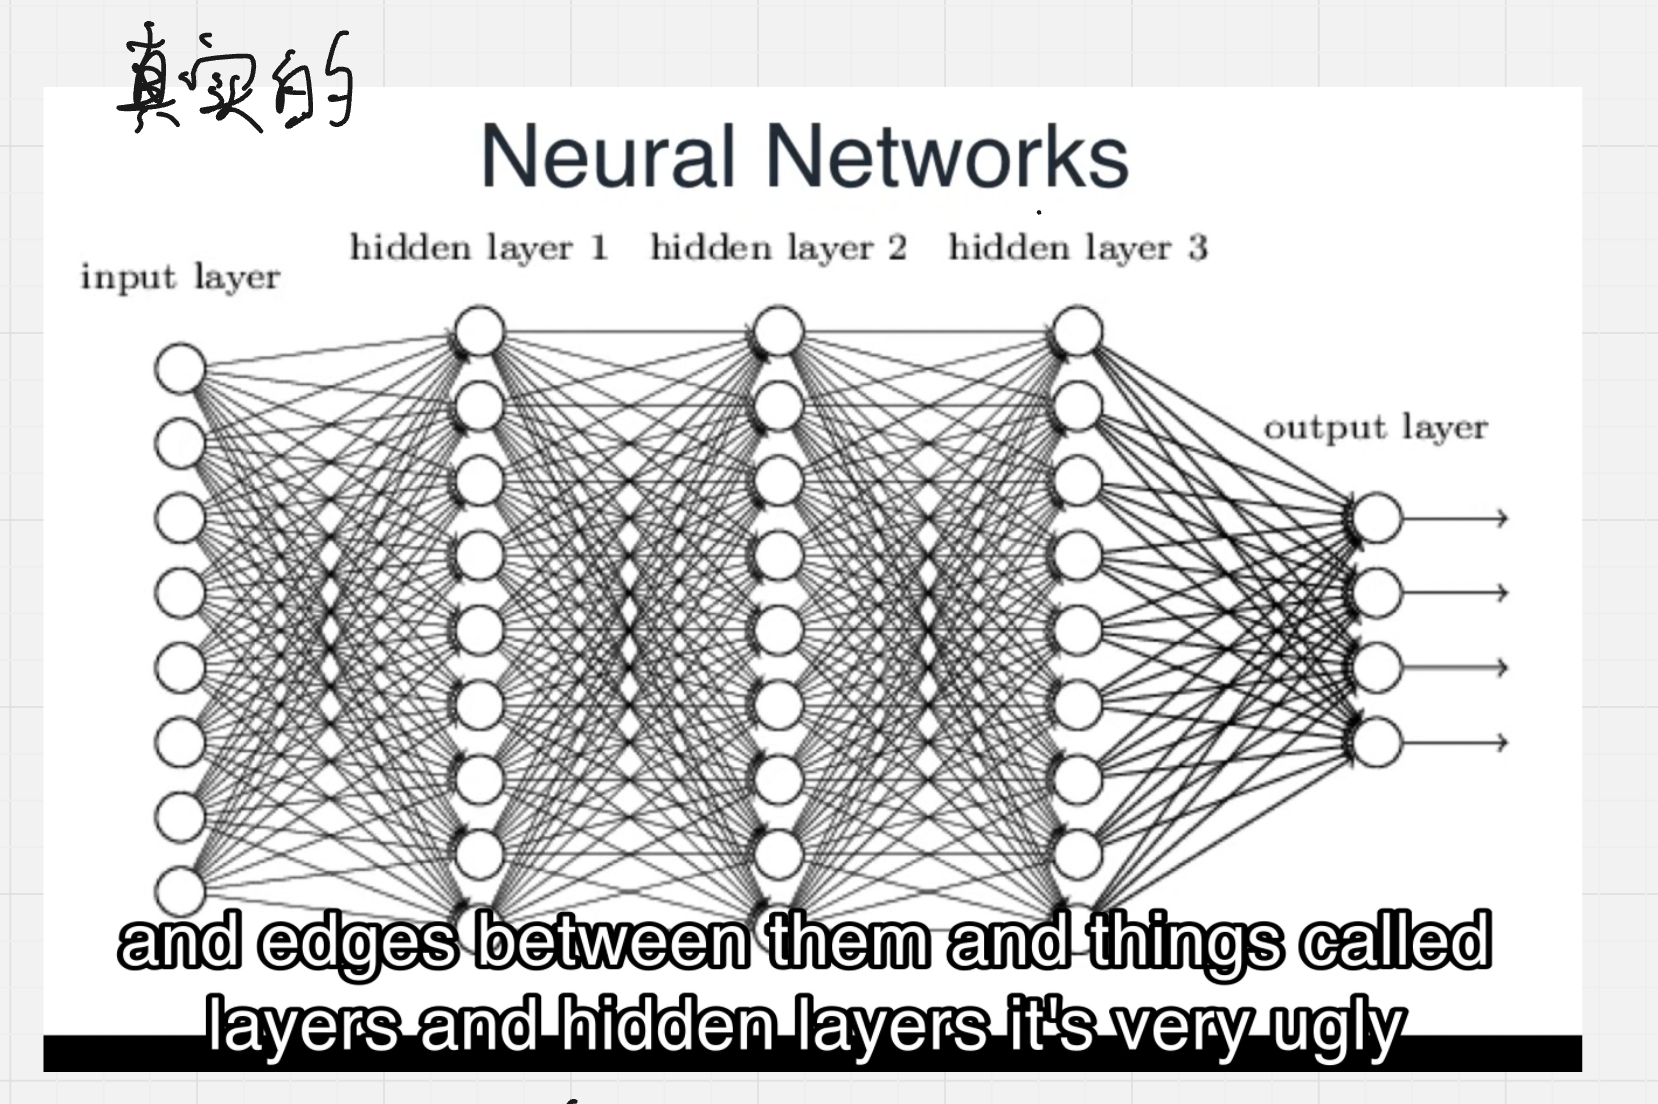
*截图 02|输入层、隐藏层、输出层:先认出结构,不急着理解每条边*
图里的圆点是计算单元,连线表示数值传递。现在先记住:输入进入网络,经过中间计算,最后得到输出。连线上那些需要学出来的数字,决定了网络如何处理输入。
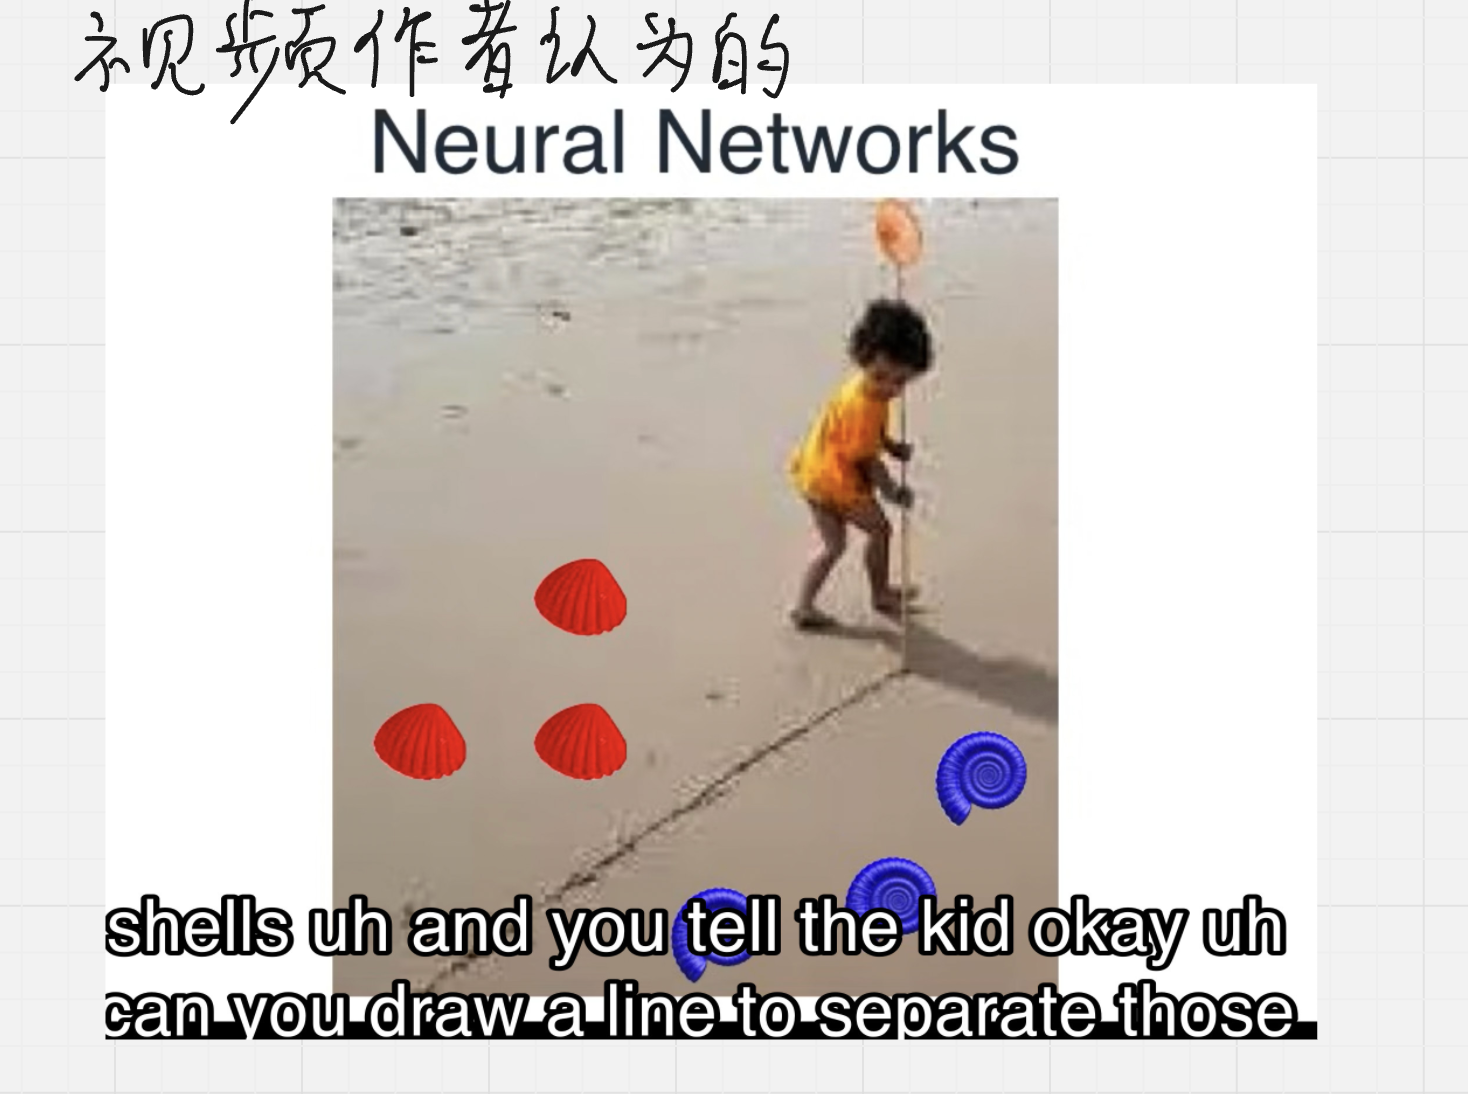
*截图 03|沙滩上的红蓝贝壳:把分类理解成划分区域*
把网络想成一个帮忙分贝壳的孩子,就容易多了。给出一些红色、蓝色的例子,希望它学会一条规则:以后遇到新贝壳,也能根据位置猜颜色。在这个教学例子里,每个样本只有两个特征,就是平面坐标。
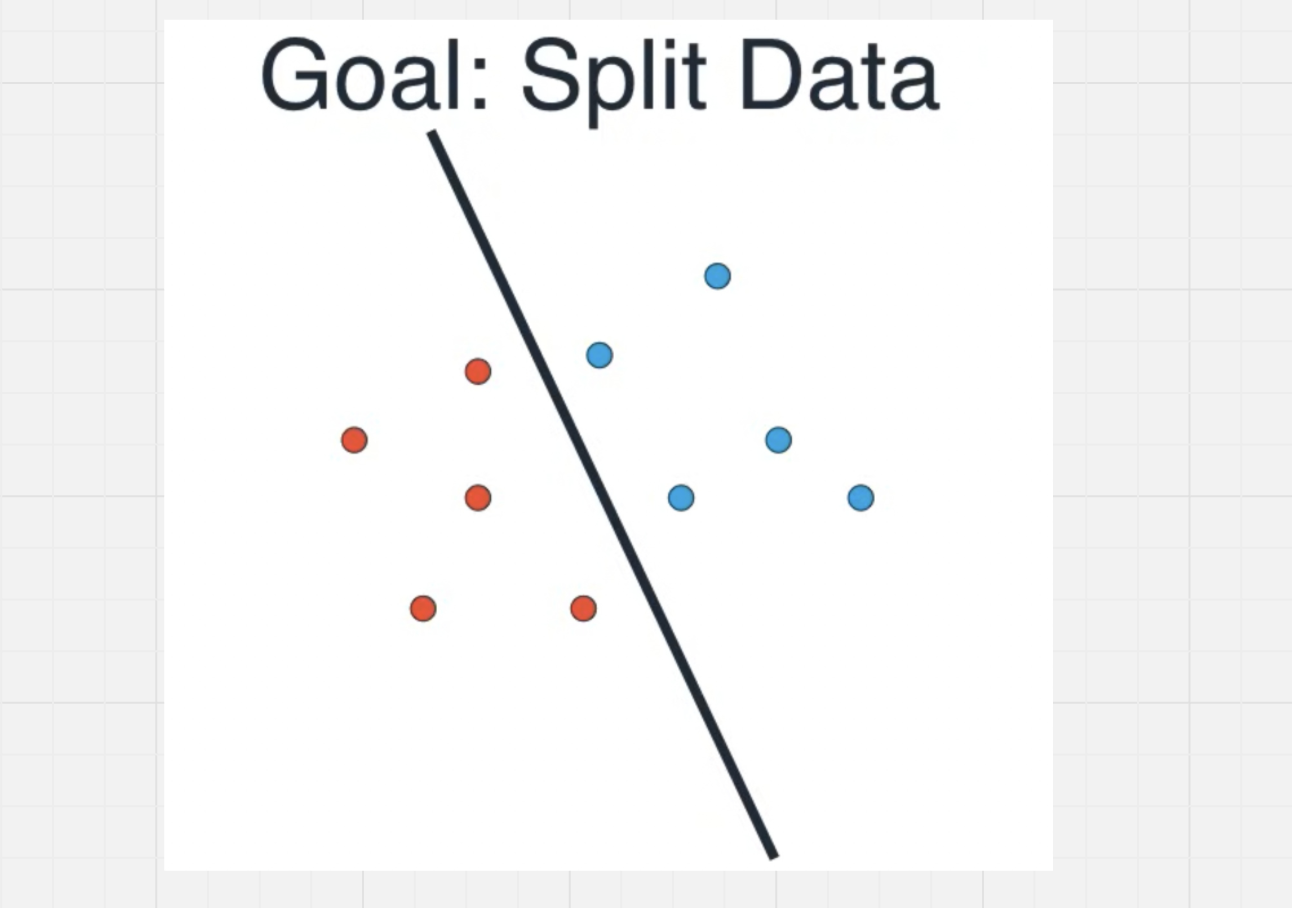
*截图 04|完整目标:找到把红点与蓝点分开的边界*
这张图是本篇任务的总览:黑线的一侧预测为蓝,另一侧预测为红。输入是点的位置,标签是点的真实颜色,模型要学的是这条线的位置和方向。
一条直线可以写成“横坐标乘一个数,加上纵坐标乘另一个数,再加一个常数等于零”。其中两个系数控制方向,常数配合系数控制位置。训练时移动的就是这些参数。
## 为什么“错了两个变成错了一个”还不够
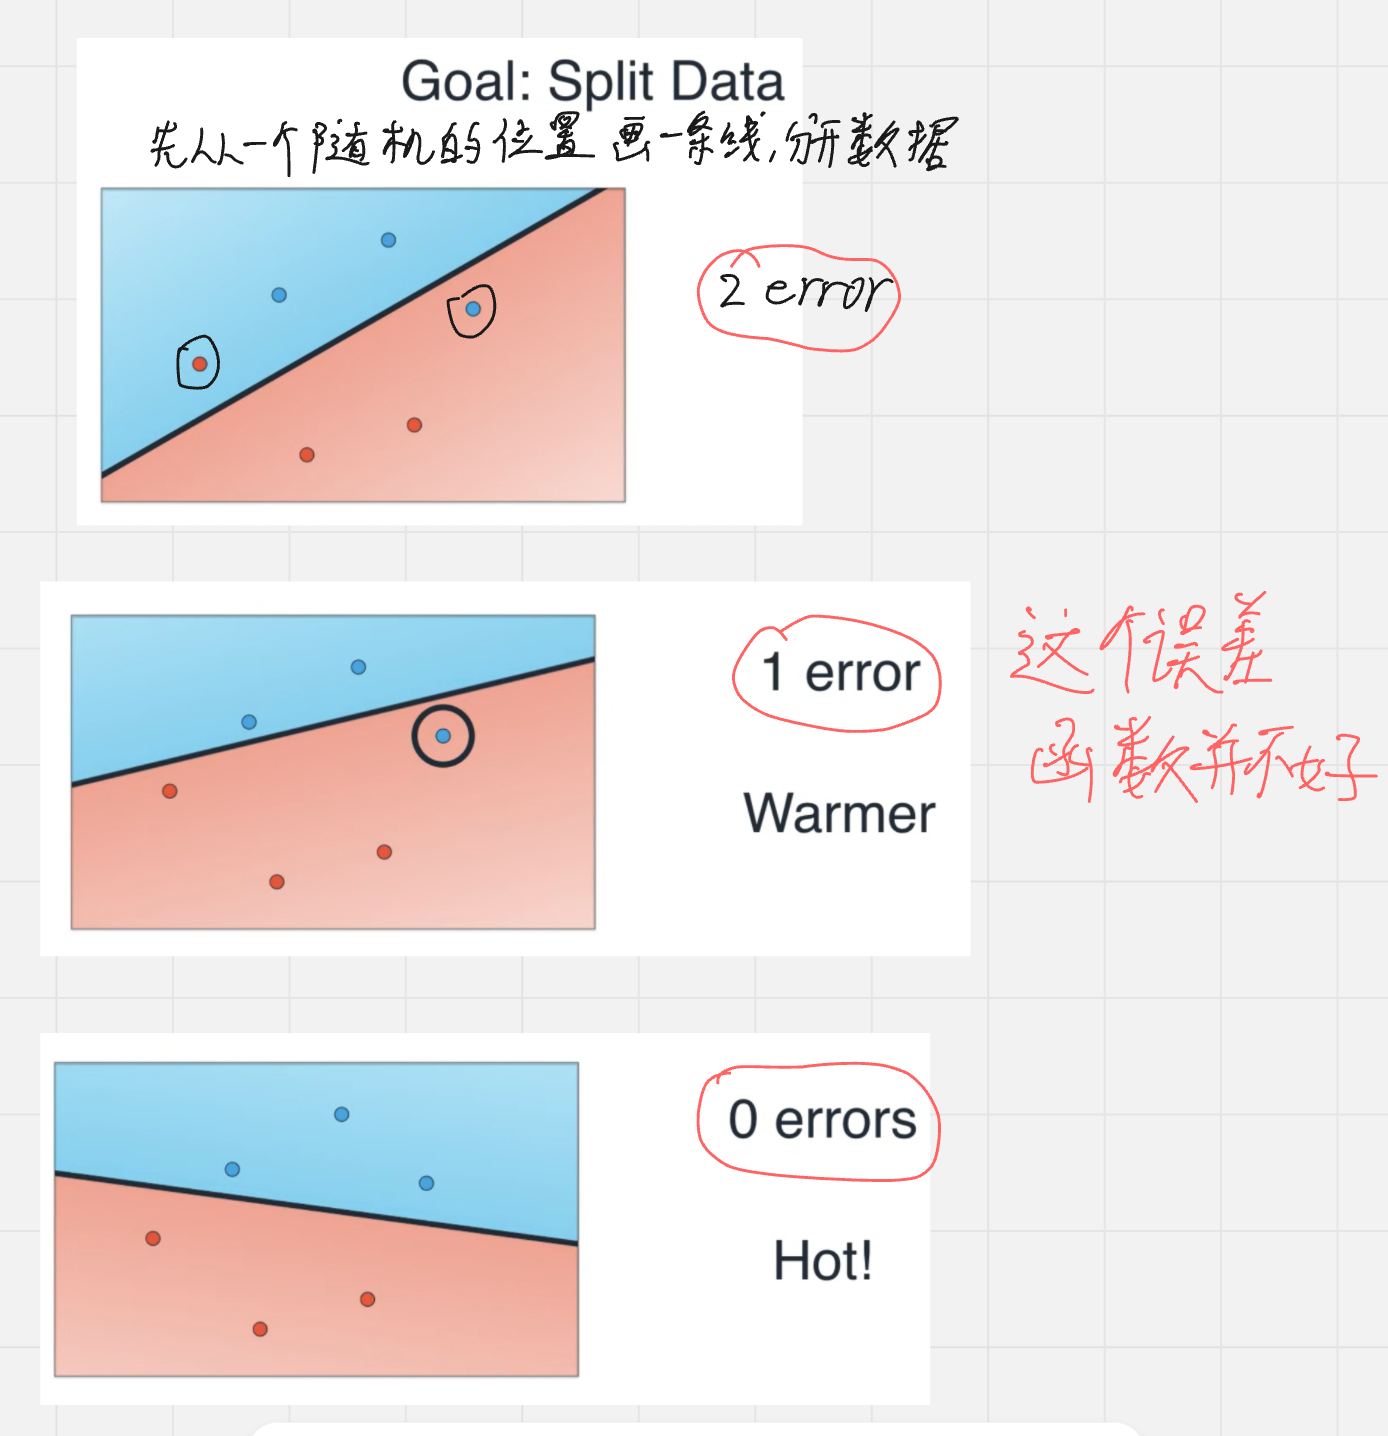
*截图 05|从两个错误到一个错误,再到零个错误*
直觉上,数分错的点很合理:错得越少,线就越好。截图展示了从 2 个错误到 1 个,再到 0 个的过程。但它只告诉我们“改完以后有没有变好”,没有告诉我们“现在该往哪个方向微调”。
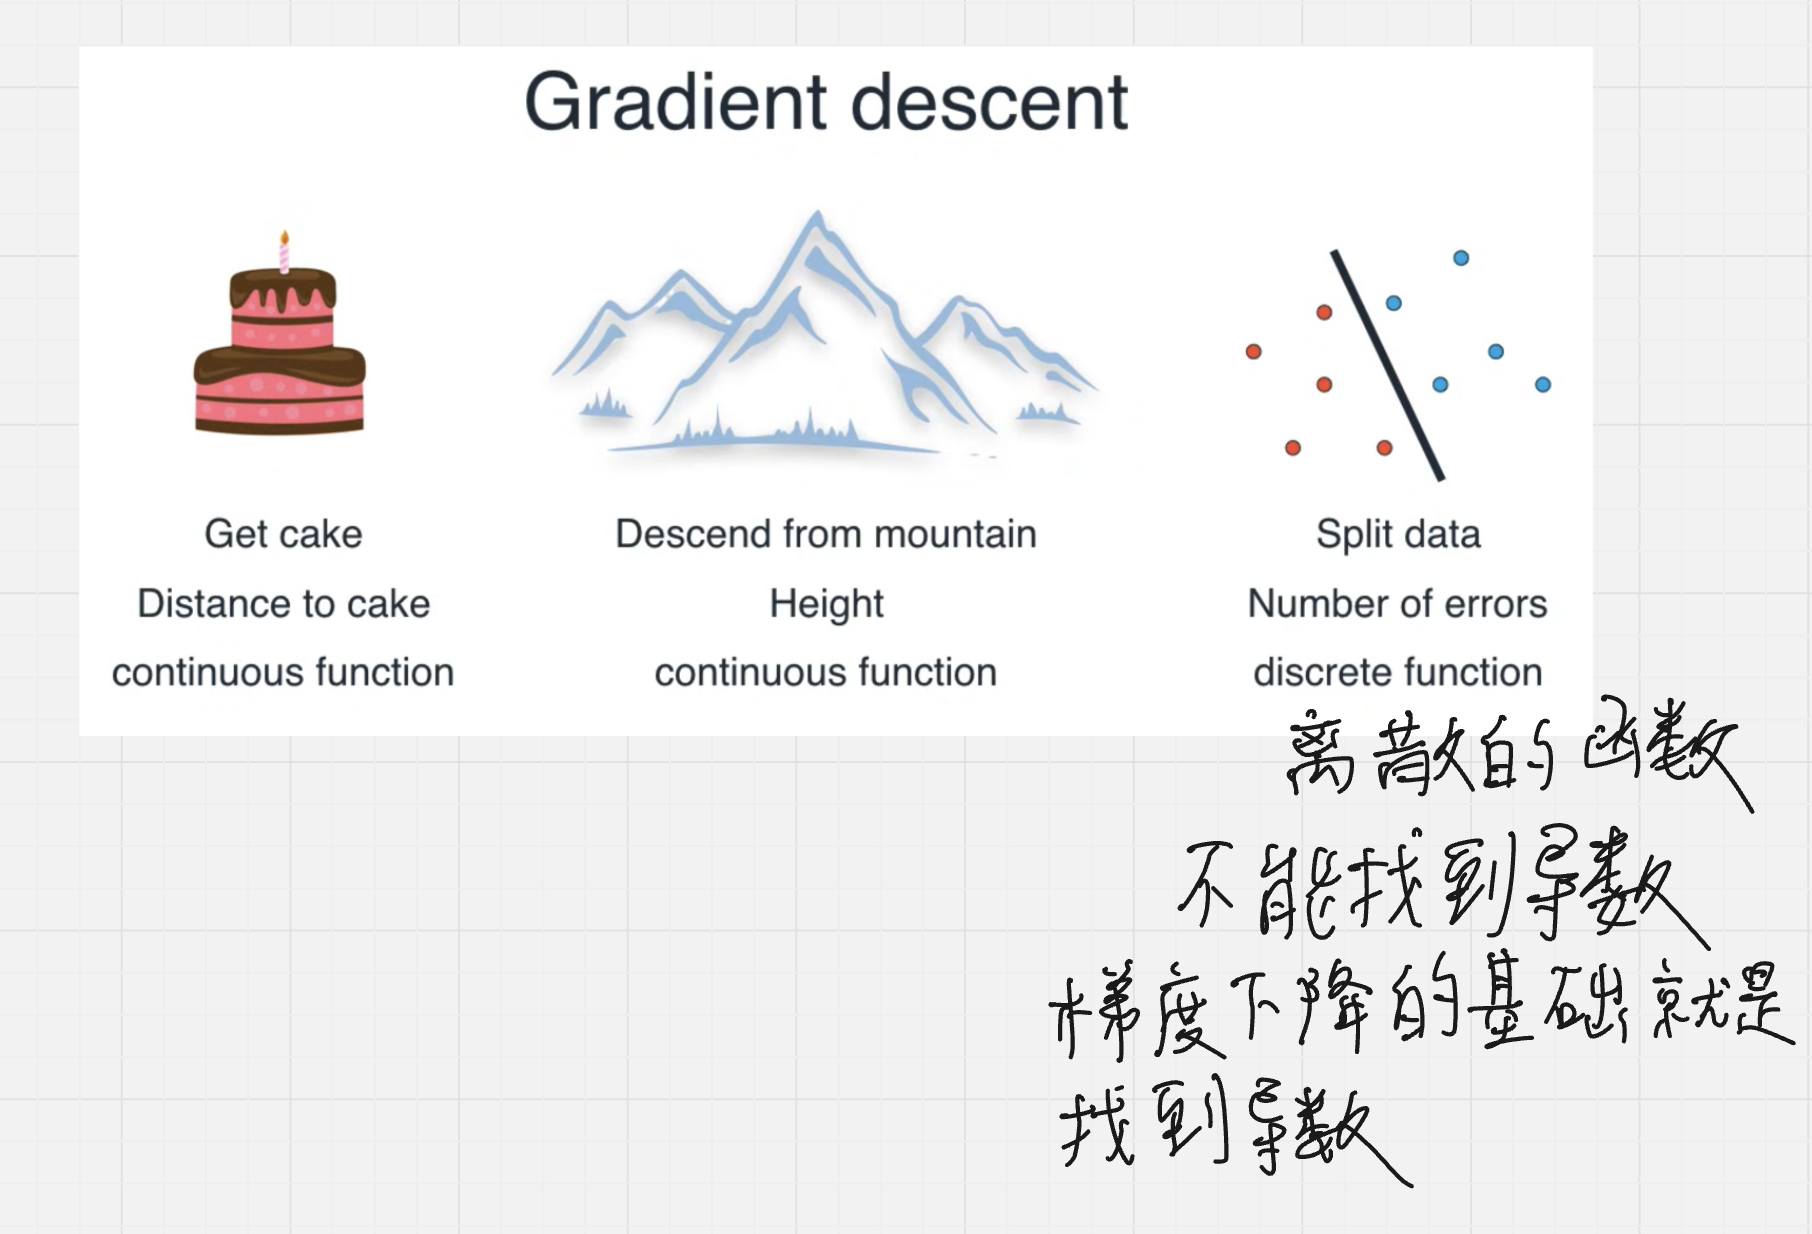
*截图 06|距离、高度与错误个数:前两者通常能反映细微变化,后者会跳变*
把直线稍微转一点,只要还没有跨过任何样本点,错分数量就不变。转很多次,也可能一直都是 2;越过某个点以后,才突然变成 1 或 3。
更准确地说,这个错分计数关于模型参数通常是**分段常数**:大片区域里导数为零,发生跳变的位置又不可导。问题不在于“离散任务都不能训练”,而在于这个目标提供不了有用的梯度。
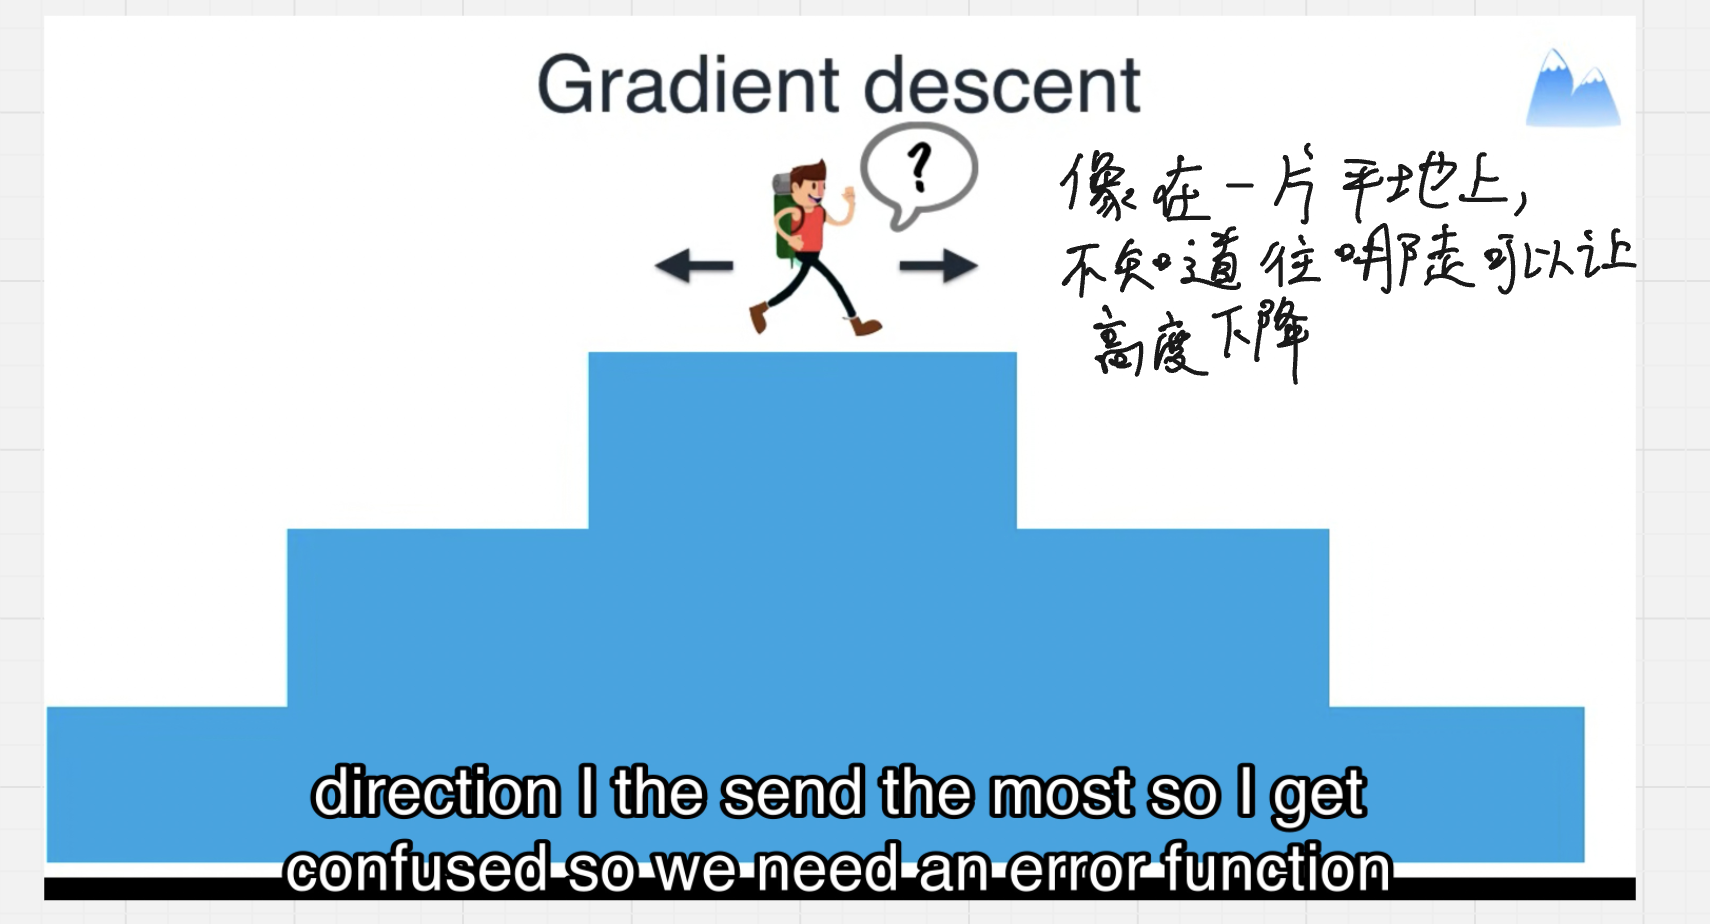
*截图 07|站在台阶的平面上:局部看起来处处一样高*
如果只看脚边一小块地面,台阶上的人无法判断往哪边走才会降低高度。优化器面对一大片不变的错误计数,也遇到了类似困难。我们需要一个能随着参数微调而细微变化的损失。
## 给每个点一个随预测变化的惩罚
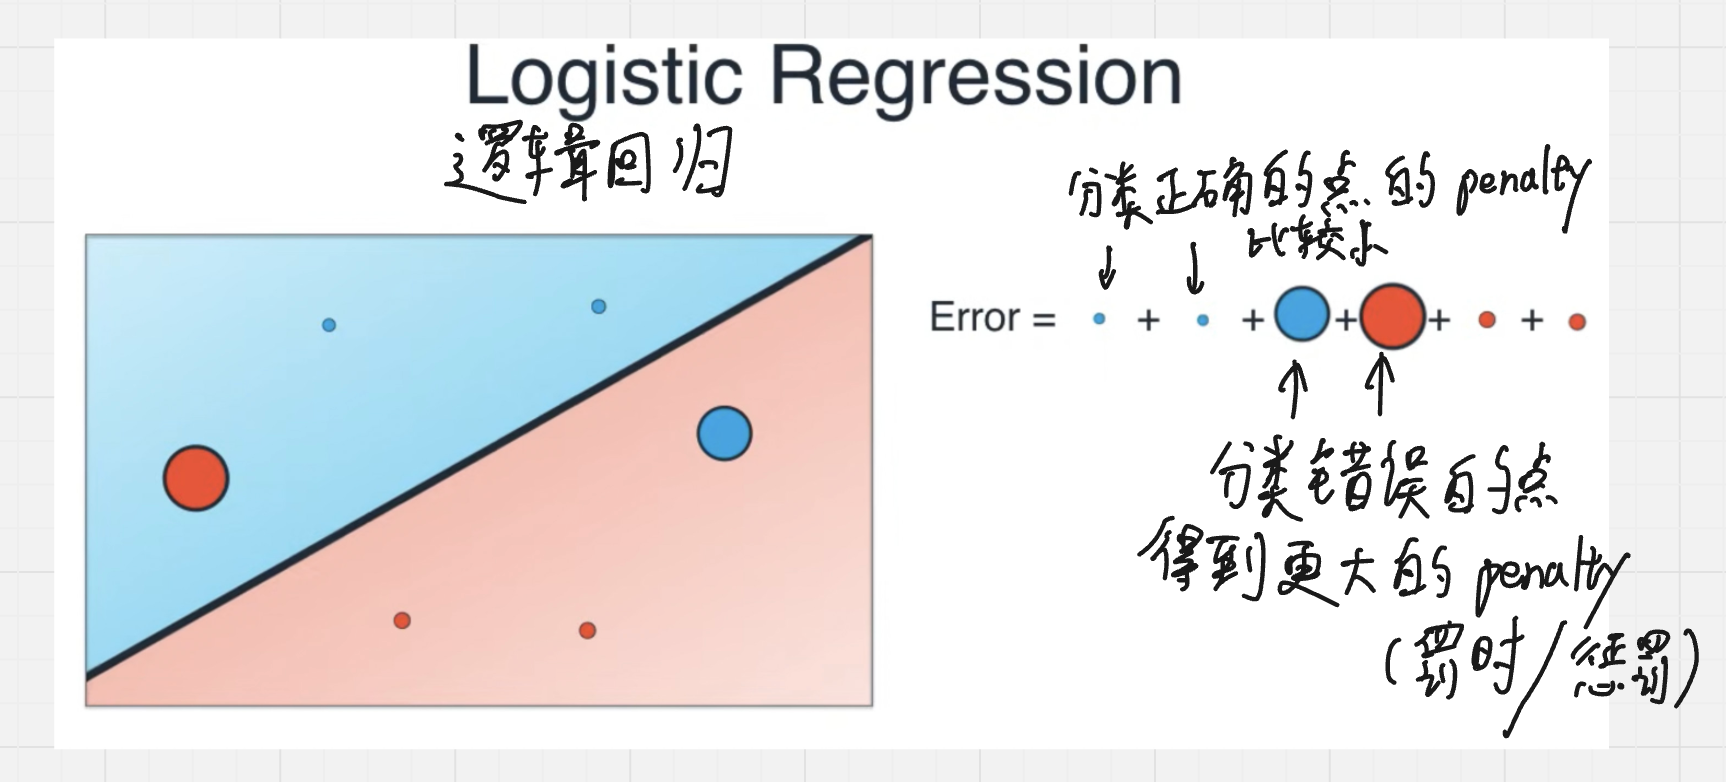
*截图 08|错分的点受罚较大,正确但不够确定的点也有较小惩罚*
先不急着写公式。设想每个点都有一笔惩罚:模型越不相信它的真实颜色,惩罚越大;越相信真实颜色,惩罚越小。即使一个点仍被分在同一侧,模型对它的把握也可以变化,因此惩罚能连续地变化。
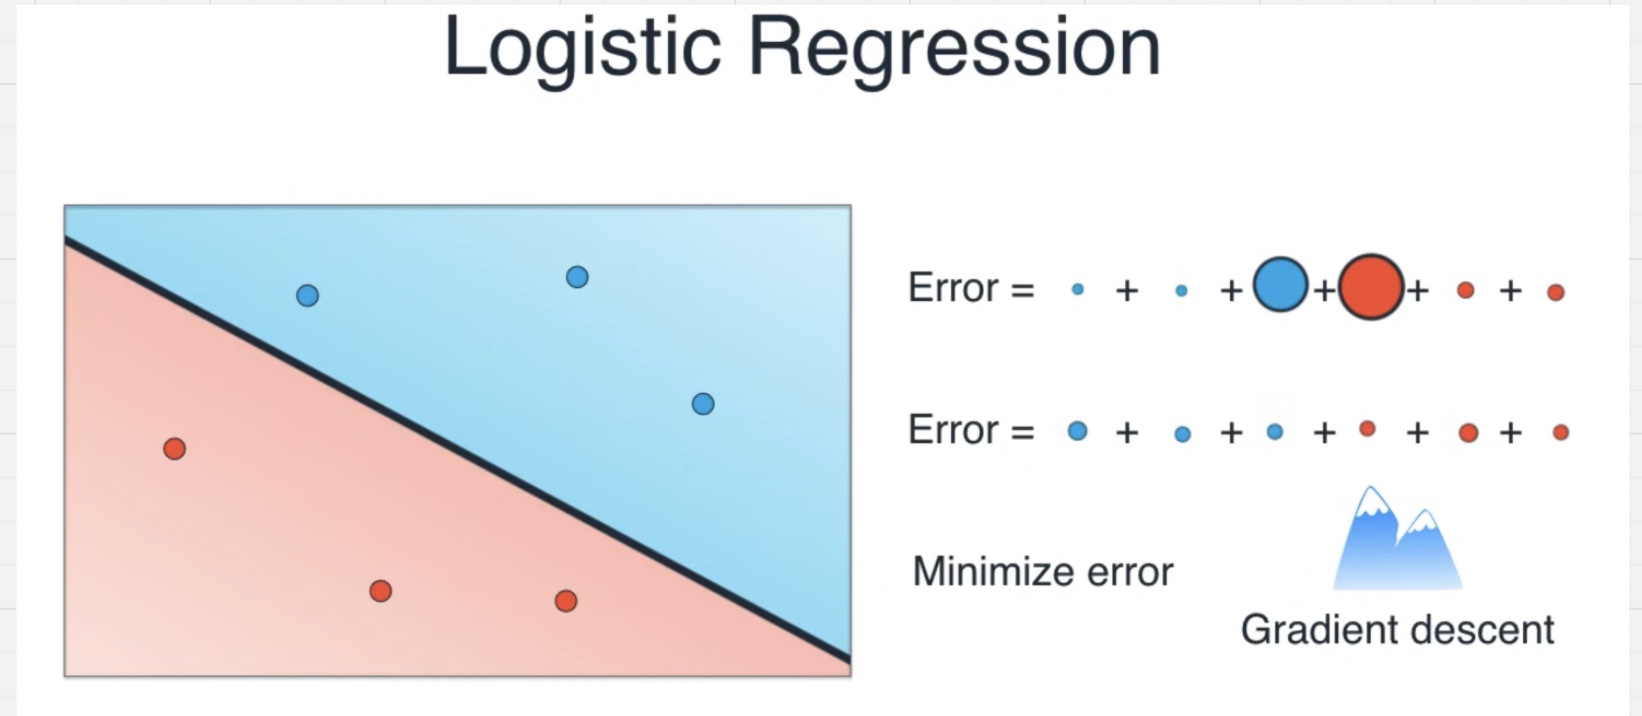
*截图 09|调整直线以后,比较所有点的总惩罚*
总损失就是把每个样本的惩罚加起来,或者取平均。调整边界时,某些点可能变好,另一些可能变差;我们看的是整体损失的变化,而不是要求每个点都同时改善。下一篇会用“给真实标签多少概率”把这笔惩罚具体算出来。
## 梯度下降到底往哪走
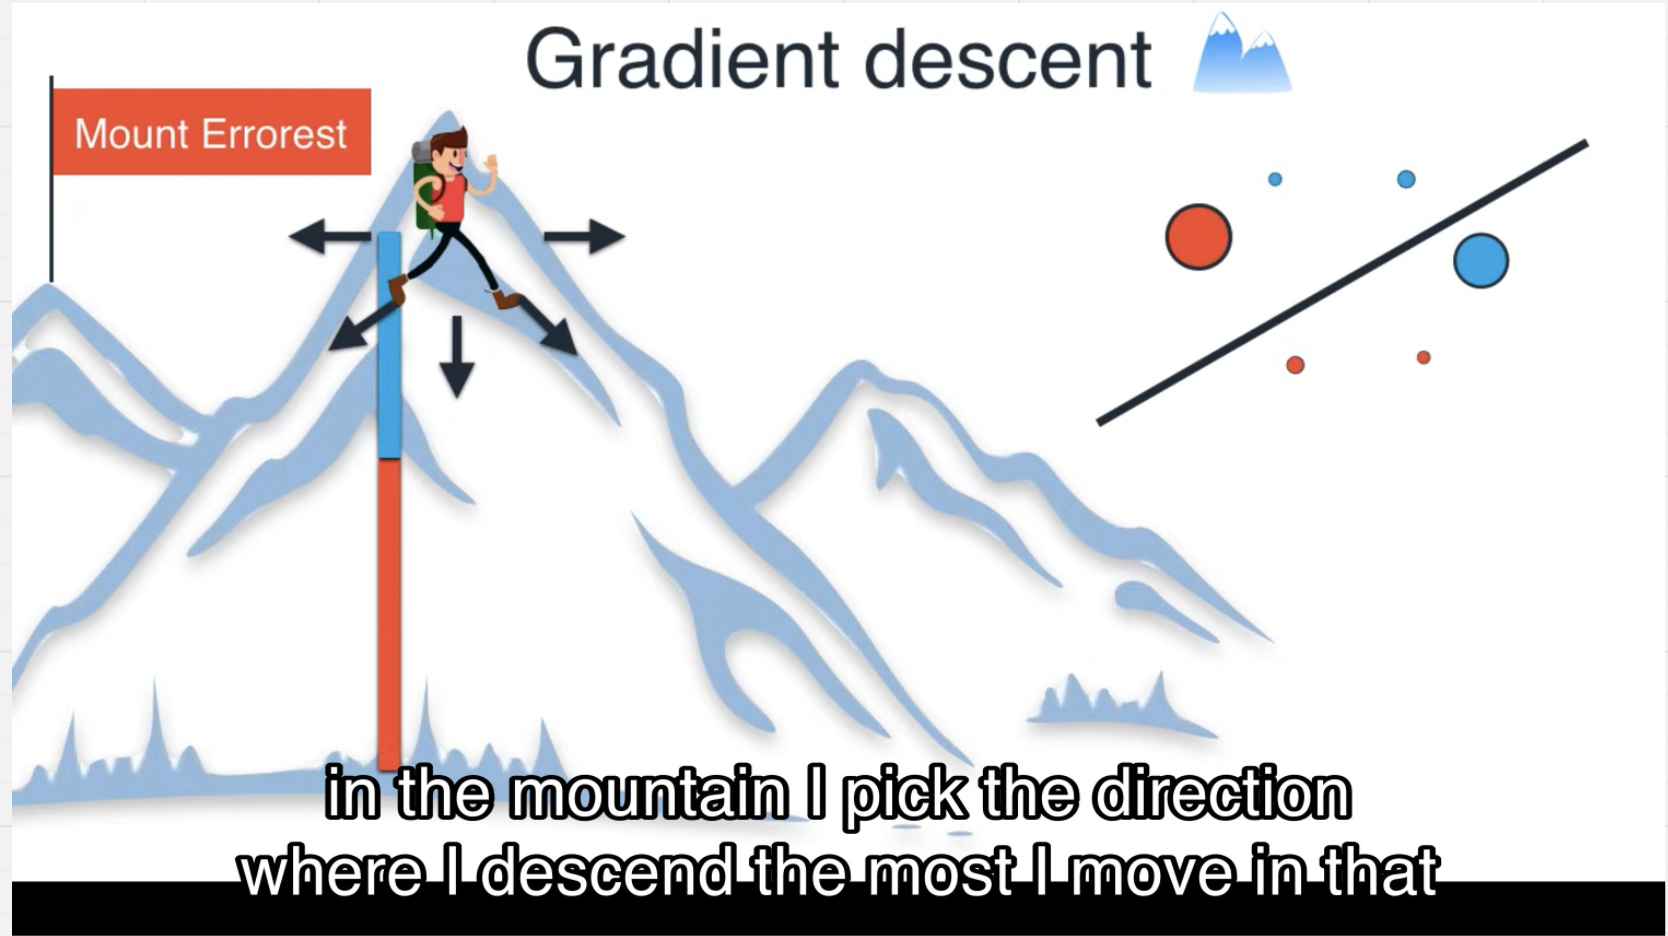
*截图 10|把参数对应的损失想成高度:每一步寻找局部下降方向*
“山”不是真实数据平面上的山,而是参数空间里的损失曲面。一个位置对应一组参数,高度对应这组参数的总损失。改变直线的参数,相当于在这座山上移动。
数学上的梯度指向局部上升最快的方向,**下降要走负梯度方向**。视频的下山比喻很有帮助,但不能把“梯度本身指向下降”记反了。
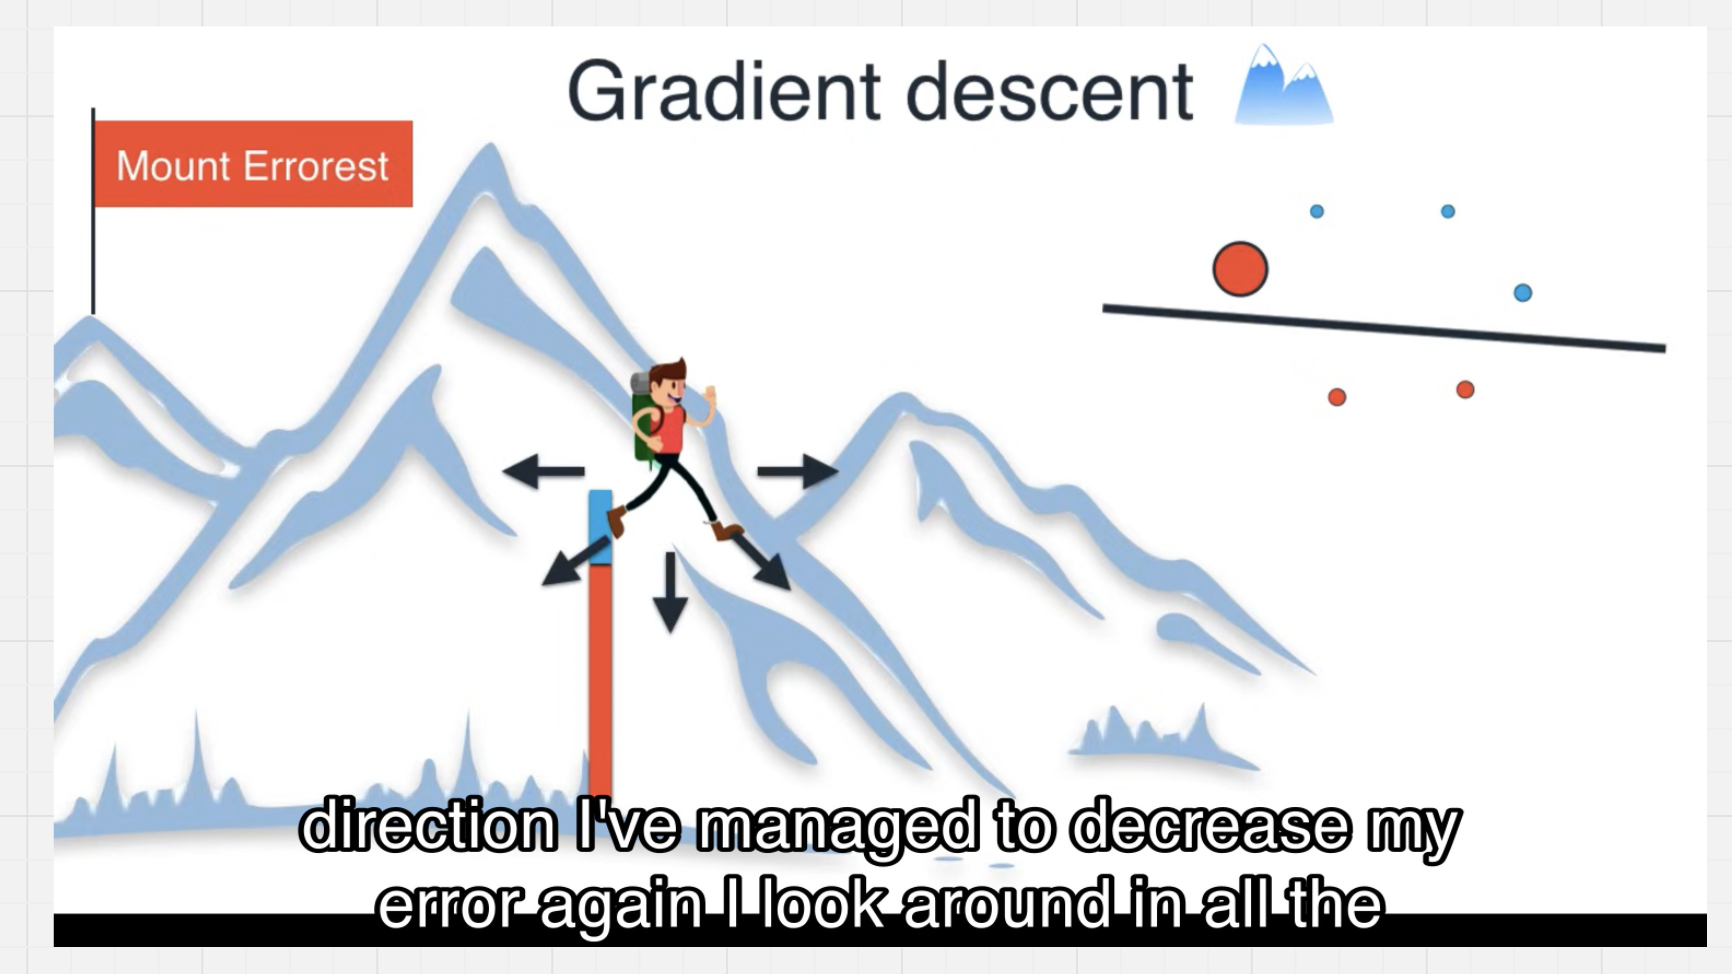
*截图 11|走完一步后重新判断:不是从起点一直沿一个方向走到底*
每走一步,都要在新的参数位置重新计算梯度。学习率控制步子大小:太大可能越过低处甚至让损失上升,太小则进展缓慢。它不是“每次保证走到最优位置”的按钮。
设全部参数合起来记为向量 $\theta$,总损失记为 $L$,学习率为正数 $\eta$。沿负梯度迈出一步,就是:
$$
\theta_{\mathrm{new}}=\theta_{\mathrm{old}}-\eta\nabla L(\theta_{\mathrm{old}}).
$$
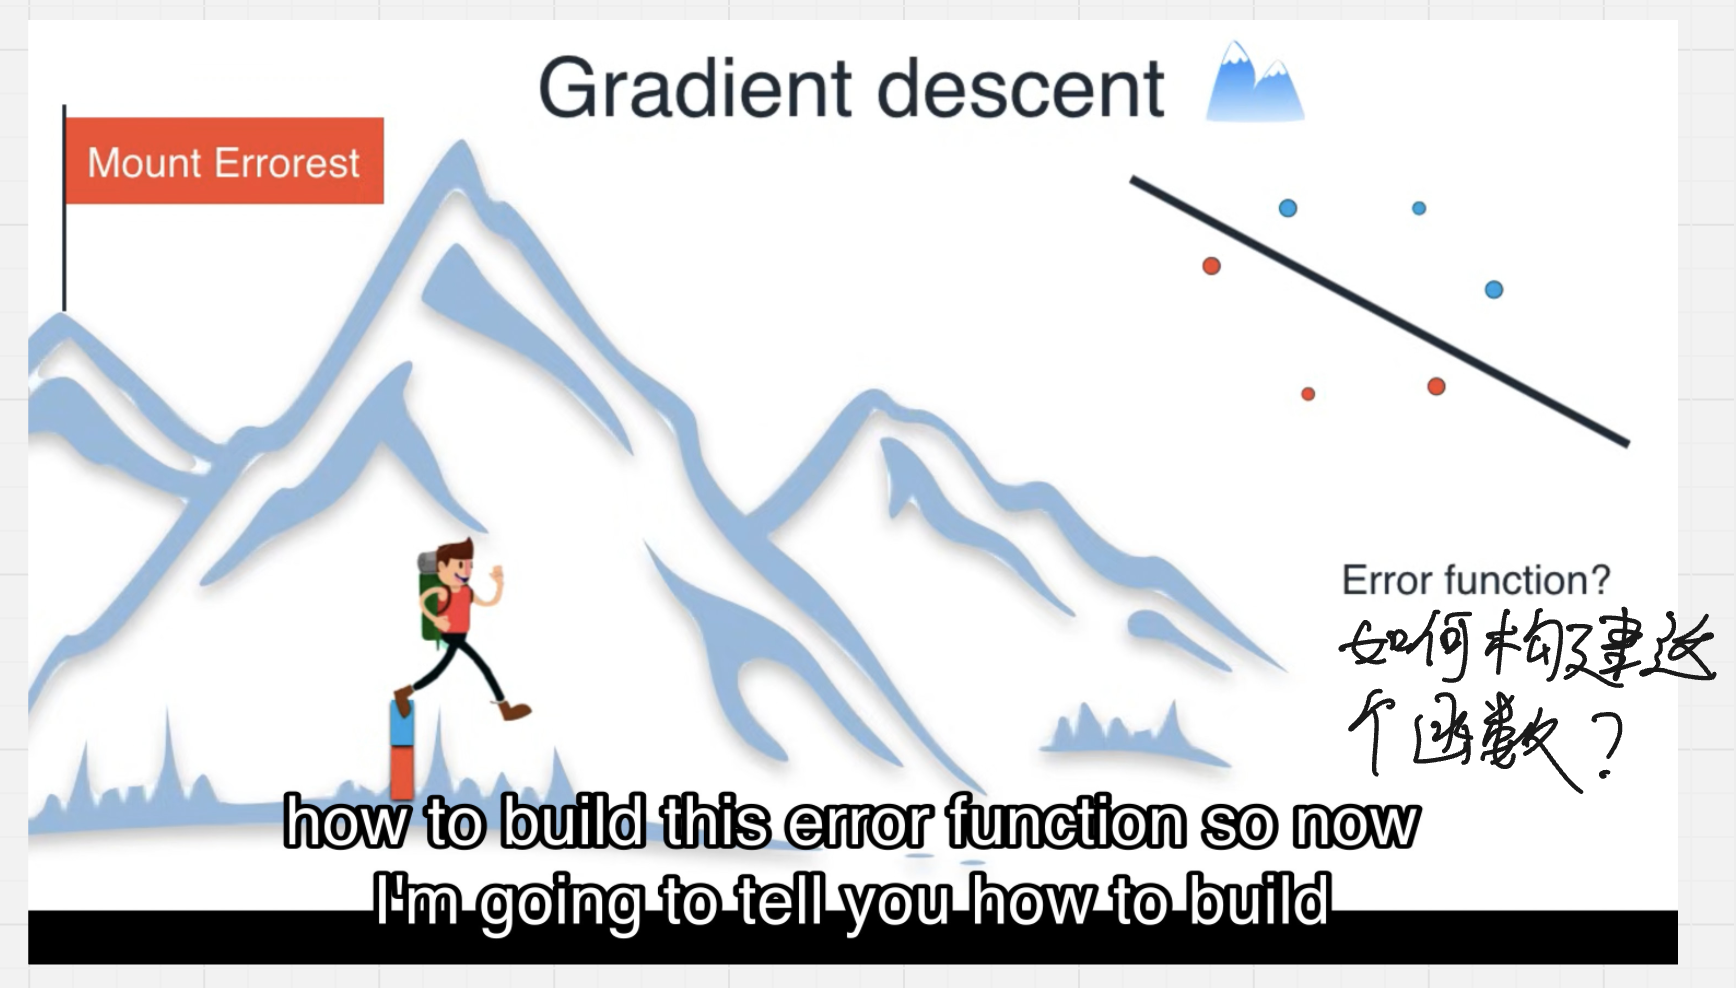
*截图 12|已经有优化方向,但仍欠一个关键问题:损失函数怎么构造*
现在任务只剩一个关键缺口:怎样给“预测不相信真实标签”定价?逻辑回归的回答是,先给每个点一个属于蓝色的概率,再用真实颜色对应概率的负对数作为惩罚。
这里也要分清两件事:梯度下降负责**怎么调整参数**,损失函数负责**用什么标准评价参数**。只有一个平滑的标准,才能让每次微调获得有用的反馈。神经网络的损失通常还有复杂的局部形状,不能从下山图直接推出一定找到全局最优。