亲手算一次 RNN:Food、Weather 与 non-linear · znzryb
# 亲手算一次 RNN:Food、Weather 与 non-linear
主要参考:[Luis Serrano:A friendly introduction to Recurrent Neural Networks](https://www.youtube.com/watch?v=UNmqTiOnRfg)。这组中文学习笔记结合视频与观看时的截图批注整理,保留 Intro RNN 文件夹中的全部 20 张原图。视频画面版权归原作者所有。
本篇使用第 14—20 张截图,重点解决一个具体问题:上一次是苹果派,这一次下雨,网络为什么会输出汉堡?
先看一次计算的总图,后面逐层拆开。图中的 Food、Weather、Add、Non-linear、Merge 依次完成“准备候选、标记分支、合并分数、选中赢家、恢复食物编码”。
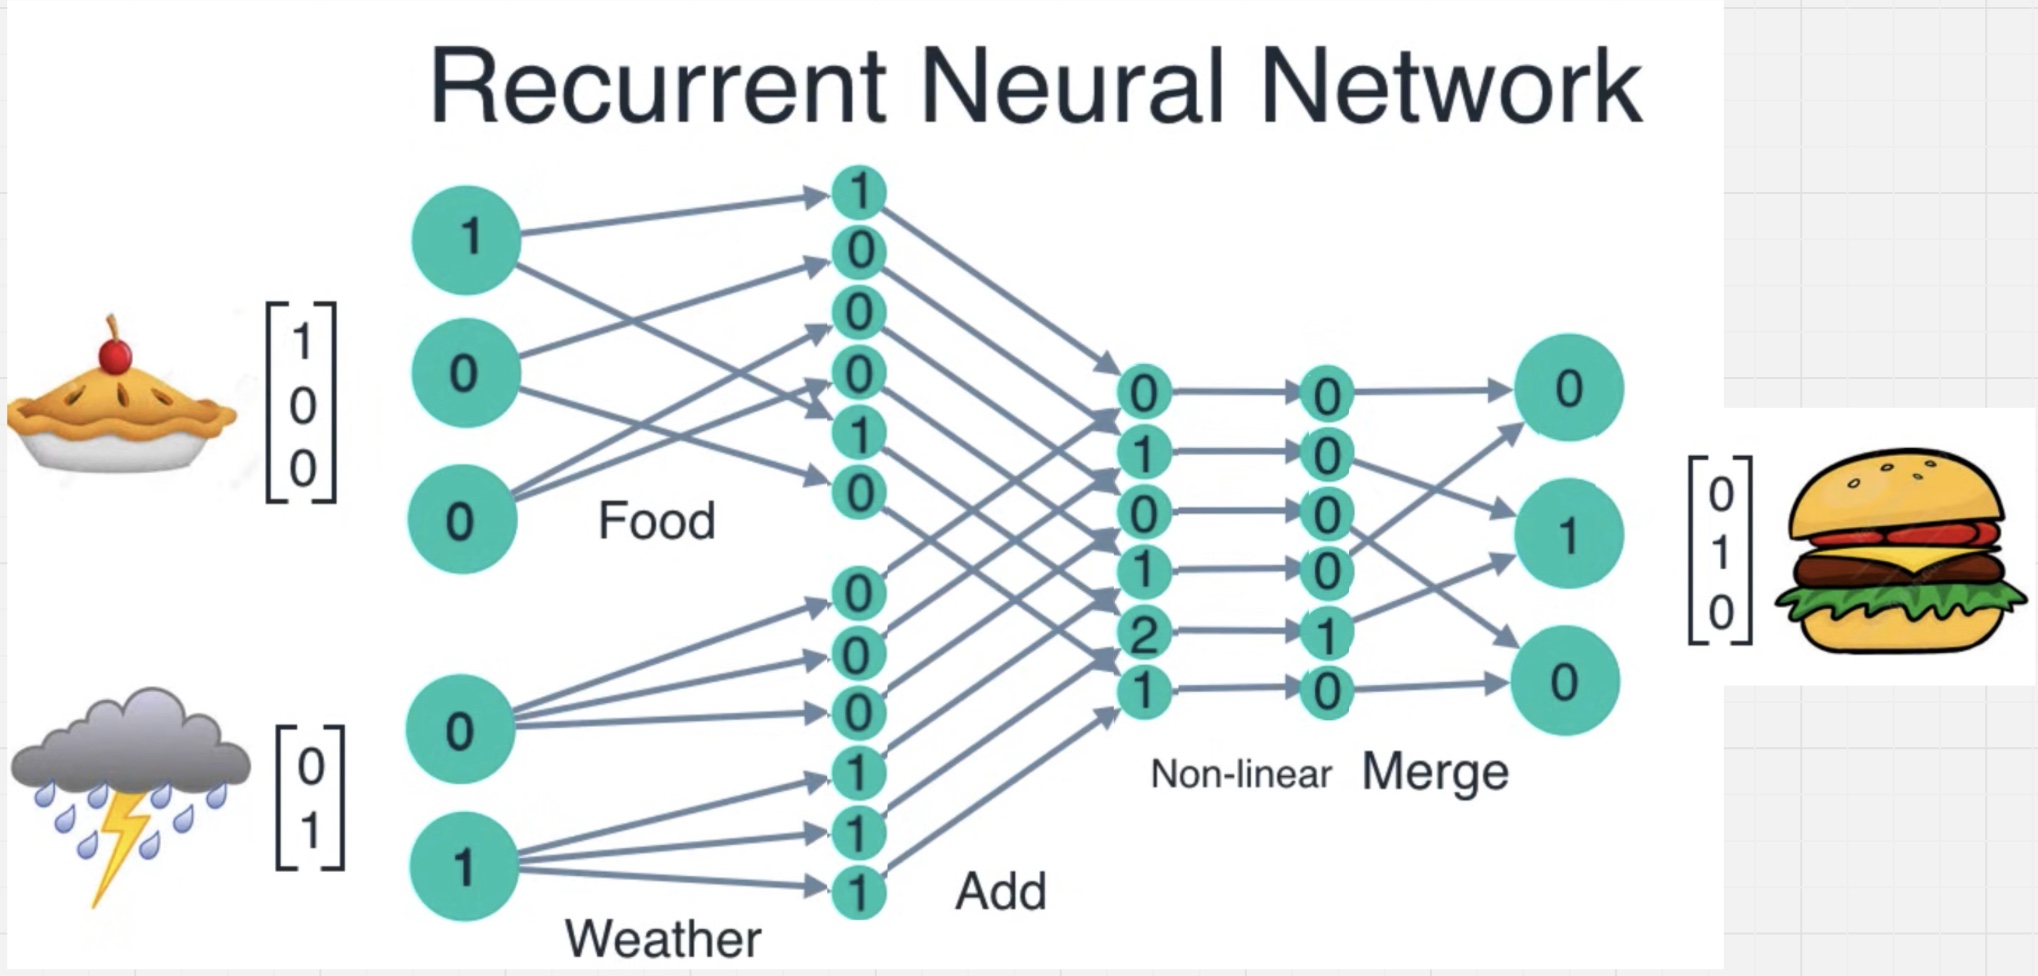
*截图 18|完整计算总图:苹果派与雨天经过五个环节,得到汉堡*
左上方是上一轮的食物,左下方是当前天气,最右边是这一次的食物。Food 与 Weather 各自产生六个数;Add 对应相加;Non-linear 选出最高分的位置;Merge 把六个位置变回三个食物位置。
中间六个位置分成上下两组,每组三个:上组是“保持原菜”的苹果派、汉堡、鸡肉,下组是“换下一道”的苹果派、汉堡、鸡肉。先认清这些位置的含义,矩阵就不再是一堆没有来由的数字。
## Food:同时准备“保持”和“换下一道”两个候选
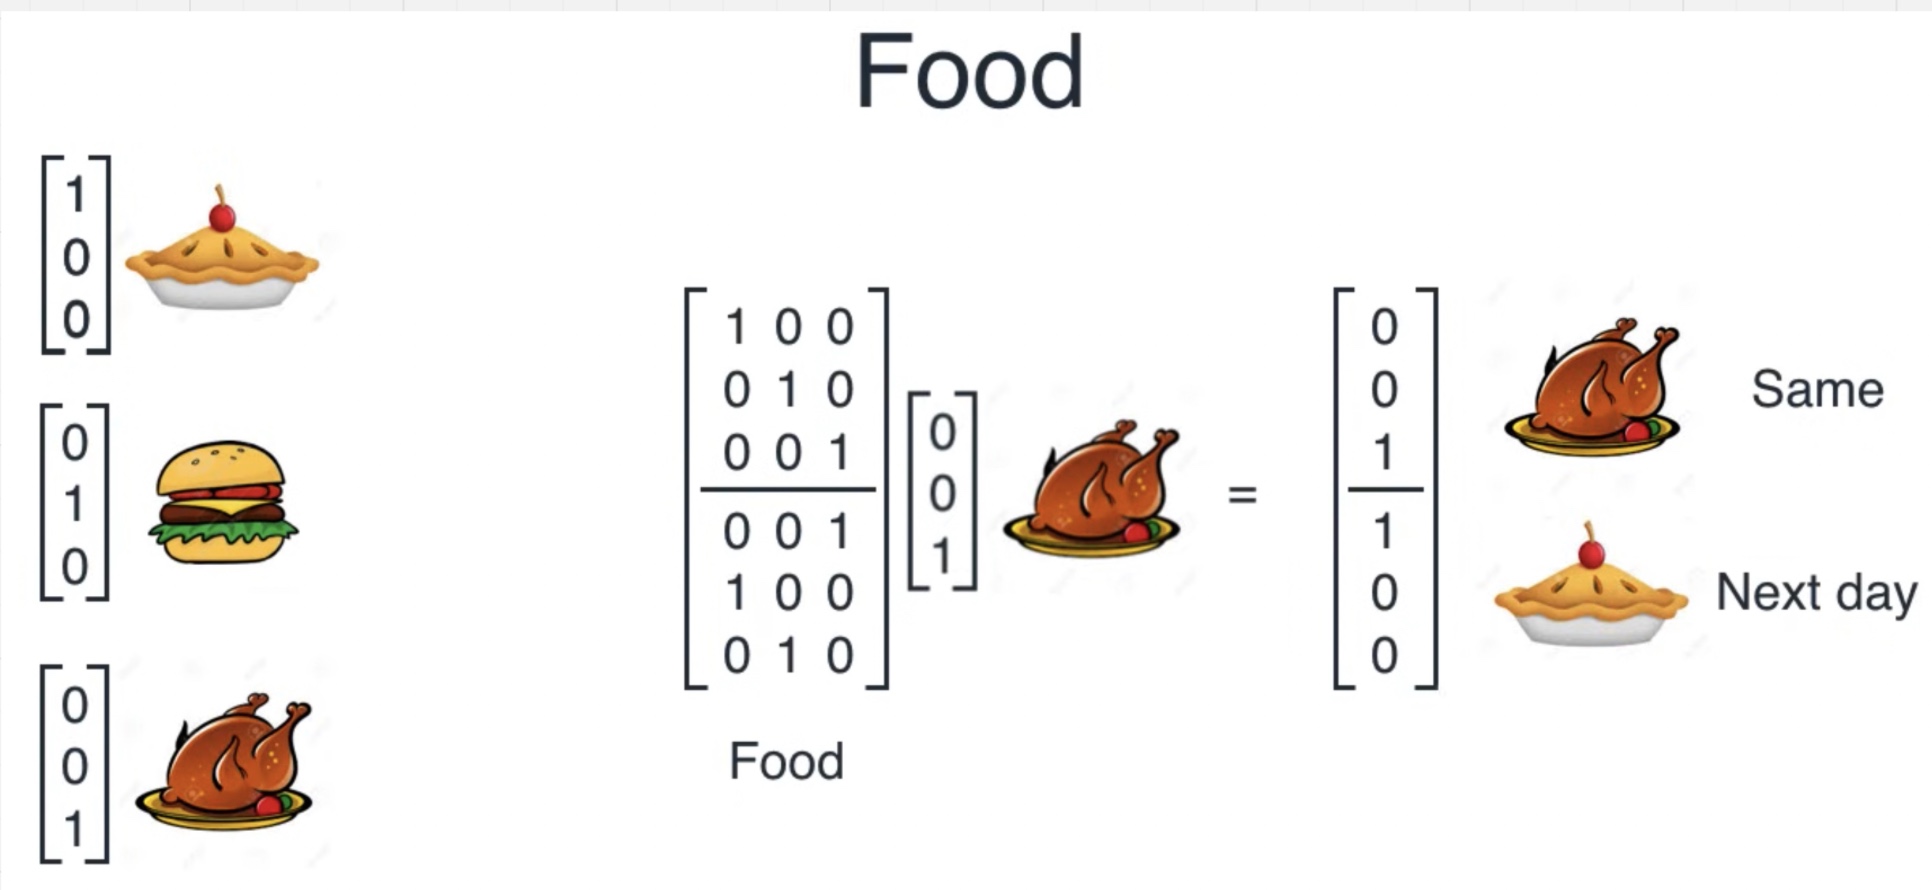
*截图 14|Food 的上半部分保留原菜,下半部分计算菜单中的下一道*
Food 矩阵的上三行是单位矩阵,因此原样保留食物;下三行是上一篇的循环矩阵 $P$,负责换下一道。
截图用鸡肉演示:上半部分得到鸡肉,下半部分得到苹果派。因此这里不是决定要吃两道菜,而是先同时准备两种方案,等待天气来选。
如果输入换成我们要追踪的苹果派,Food 就输出 $(1,0,0,\,0,1,0)^T$:上面候选是苹果派,下面候选是汉堡。
## Weather:给正确的那一组位置加分
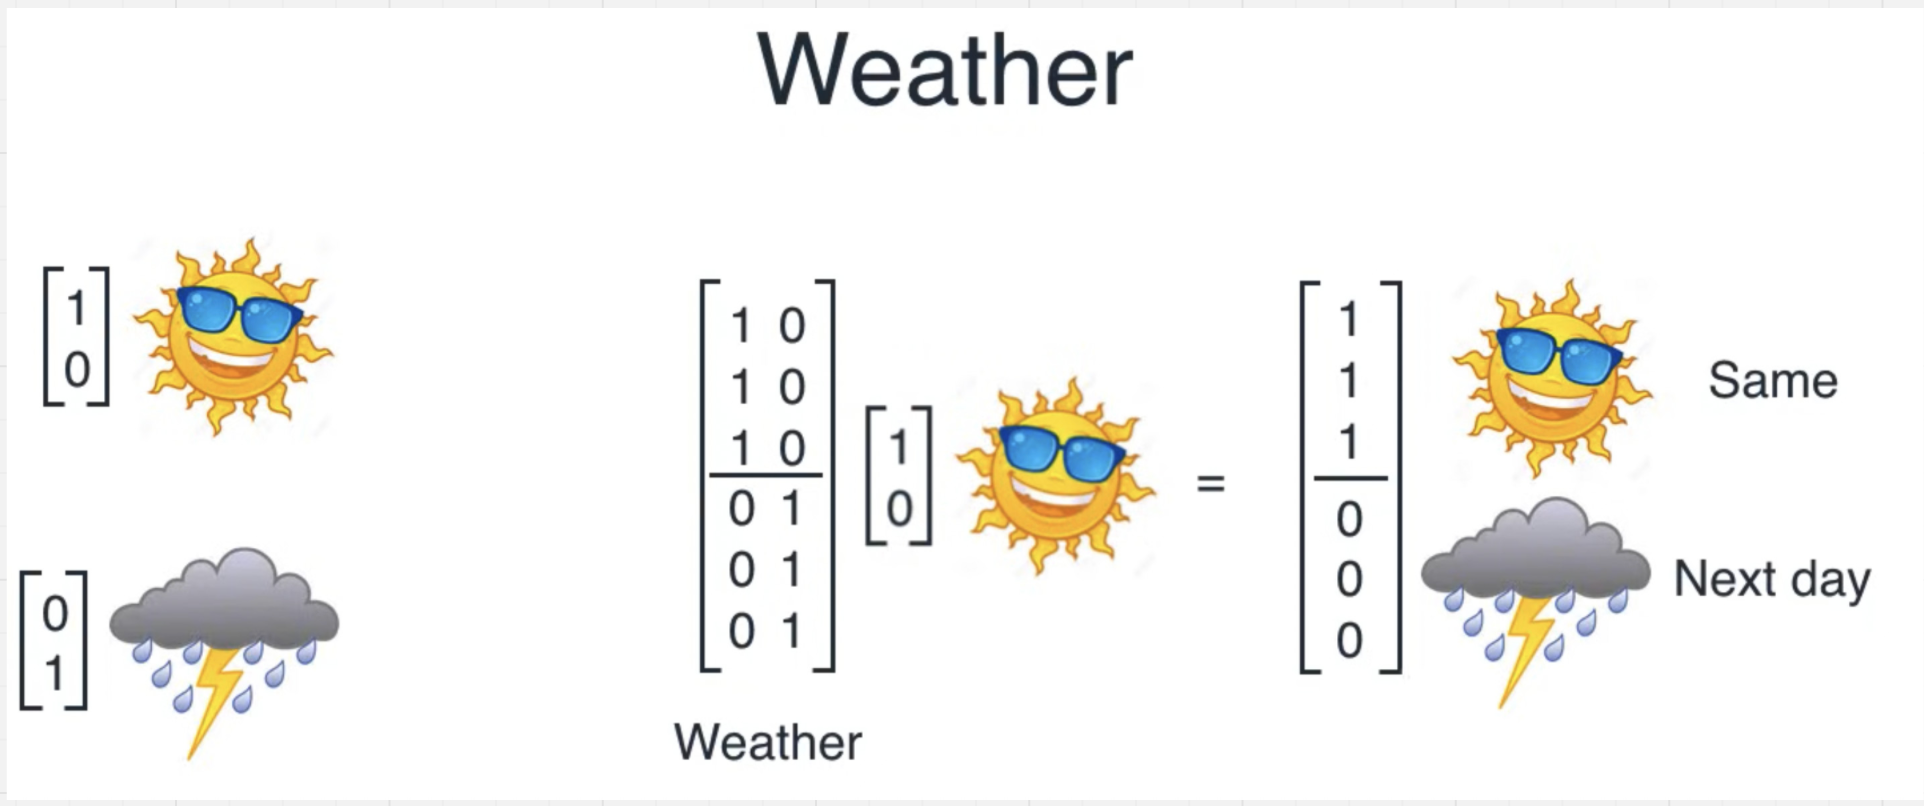
*截图 15|晴天给上组三个位置加 1,雨天给下组三个位置加 1*
晴天对应 $(1,0)^T$,经过 Weather 矩阵得到 $(1,1,1,\,0,0,0)^T$;雨天对应 $(0,1)^T$,得到 $(0,0,0,\,1,1,1)^T$。
天气没有直接决定苹果派或汉堡。它只表示“应该使用上面的保持方案”还是“下面的换菜方案”。正确的整组位置都得到 1 分,具体食物还要与 Food 的候选配合。
## Add:两路信息在同一个位置碰到一起
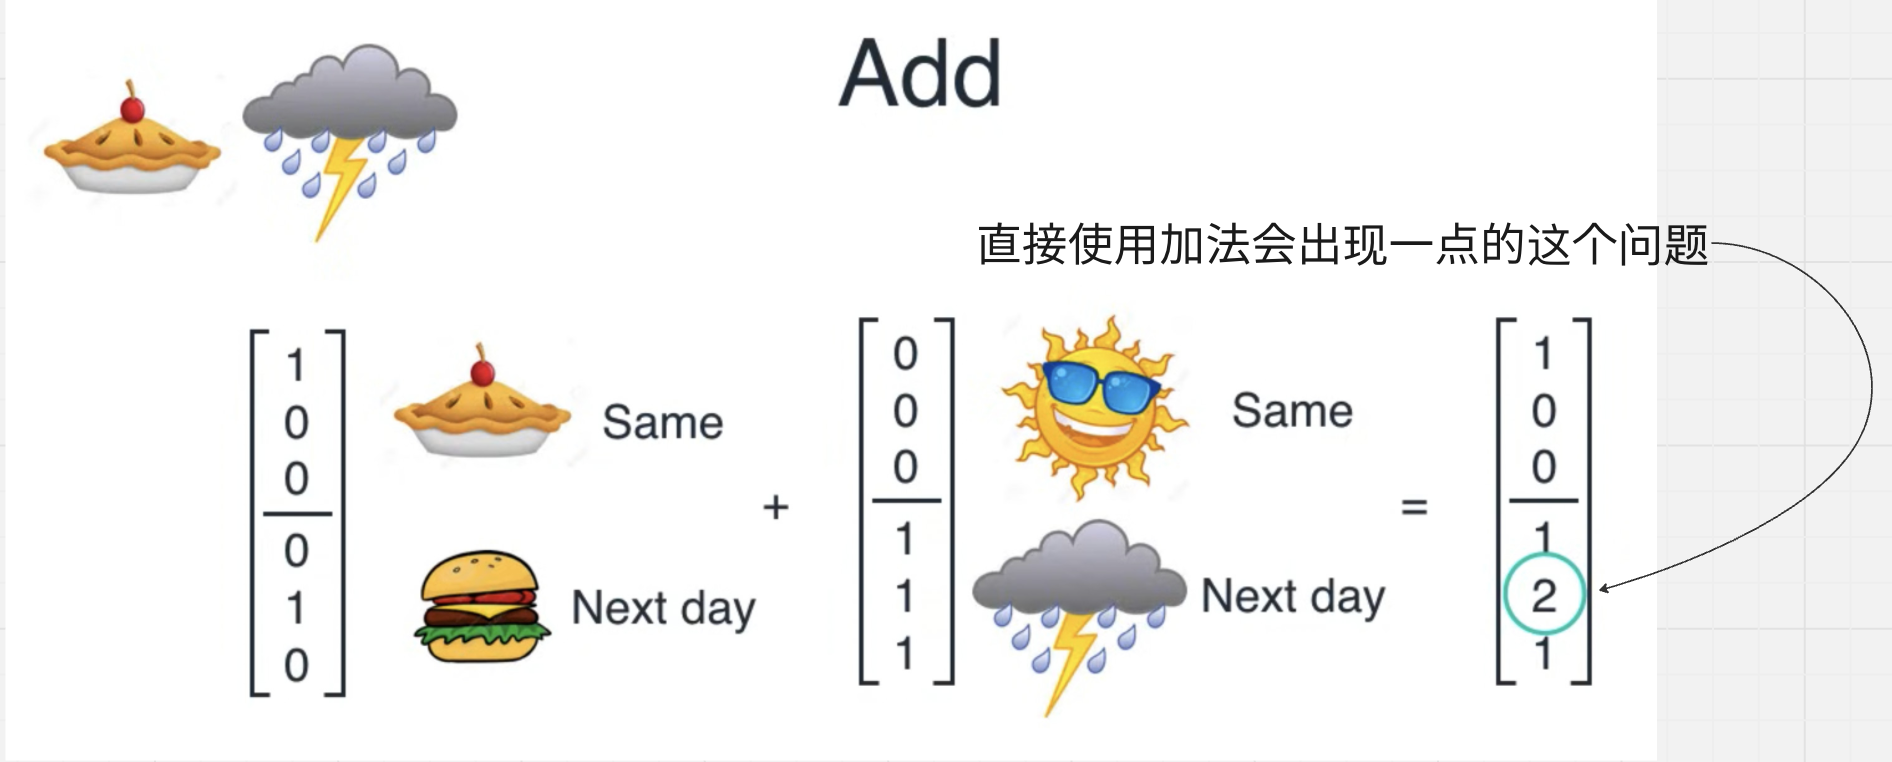
*截图 16|苹果派的候选与雨天分支相加,只有第五个位置得到 2 分*
上一次是苹果派,当前是雨天,所以把这两个六维向量逐项相加:
$$
\begin{bmatrix}1\\0\\0\\0\\1\\0\end{bmatrix}
+
\begin{bmatrix}0\\0\\0\\1\\1\\1\end{bmatrix}
=
\begin{bmatrix}1\\0\\0\\1\\2\\1\end{bmatrix}.
$$
第五项的 2 有明确含义:它既是“由苹果派换到的下一道菜”,又位于“雨天要求的下半组”。两条条件在这里同时满足,所以得到 2 分。其他位置最多只满足其中一条条件。
截图批注说“直接使用加法会出现一点问题”,可以理解为:相加以后我们拿到的仍然是候选分数,还不是最终的 one-hot 食物编码。加法本身没有算错,接下来还需要作出选择。
## non-linear:选出赢家,把它变成 1,其余变成 0
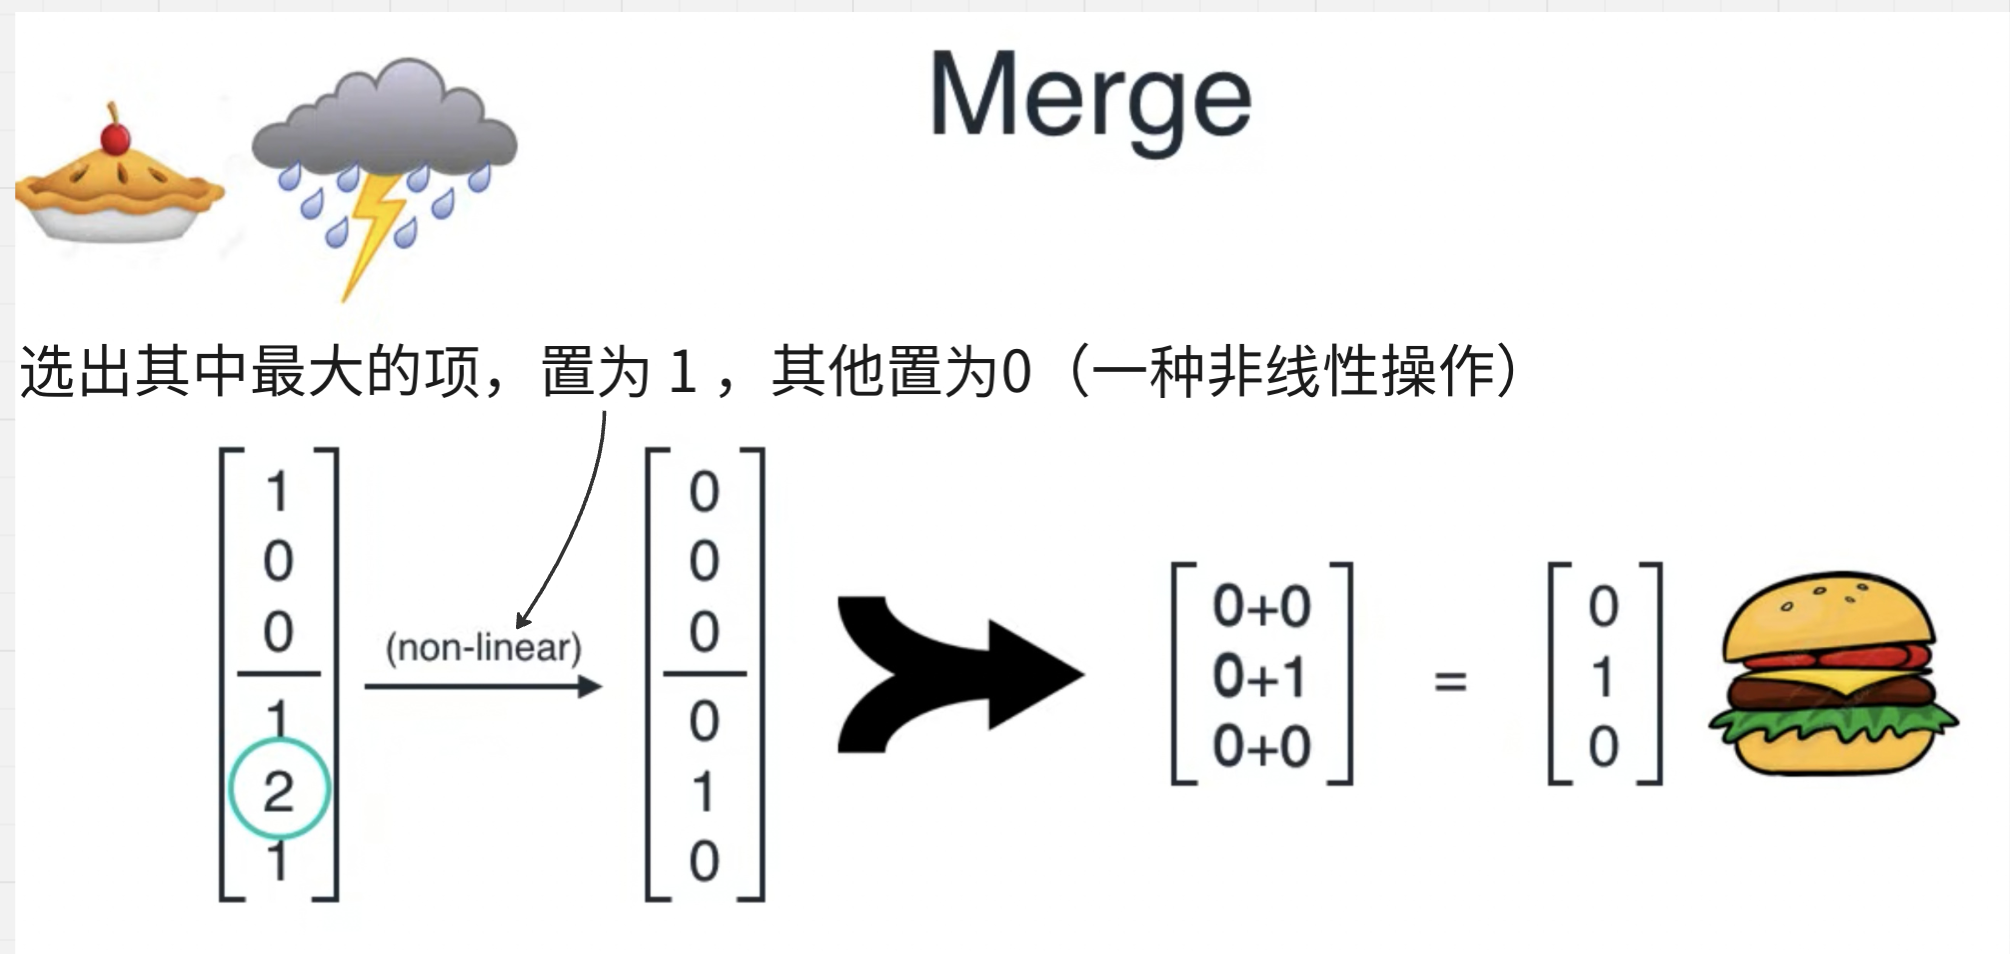
*截图 17|non-linear 保留第五项的位置,再由 Merge 得到汉堡向量*
non-linear 的中文是“非线性的”。这里具体采用的规则是:**找到整个六维向量中最大的项,把这个位置设为 1,其他位置设为 0。**
于是 $(1,0,0,\,1,2,1)^T$ 变成 $(0,0,0,\,0,1,0)^T$。留意:不是只把 2 改成 1、其余保持原状;原来的几个 1 也全部变成了 0。这个操作保留了赢家的位置。
为什么这不是线性变换?线性变换必须满足 $f(2v)=2f(v)$。如果把这里输入的六个数全部翻倍,最大值从 2 变成 4,赢家仍是第五项,输出仍然只有第五项是 1。而 $2f(v)$ 的第五项应当是 2,两者不同。因此“比较大小再选择”不是线性的。
这也不是把整个向量除以 2:除以 2 会得到若干个 0.5,并不会把其他候选清掉。常见的 ReLU 同样不会完成这件事,因为这些输入已经非负,ReLU 会原样保留它们。
在这个例子中,合法的 one-hot 食物和天气输入会产生唯一的 2,所以没有最大值并列的问题。如果把规则用于任意向量,就还得规定并列时如何处理。
## Merge:合并的是位置,不再作判断
选完以后,上面三个数是 $(0,0,0)^T$,下面三个数是 $(0,1,0)^T$。Merge 将两组对应位置相加,得到 $(0,1,0)^T$,也就是汉堡。
它相当于使用矩阵 $[I\ I]$,其中 $I$ 是三阶单位矩阵。Merge 的对应相加是线性的;前面的“选赢家”才是非线性操作。不要因为它们都出现在这一页上,就把整页的每个箭头都称作非线性。
回头看最前面的总图,现在可以从左到右完整读出每层数值的意义。再试一次:若上一轮仍是苹果派,但这次是晴天,两路相加会变成 $(2,1,1,\,0,1,0)^T$,赢家变为第一项,Merge 后便仍是苹果派。
## 把这次结果带到下一步,才形成随时间运行的网络
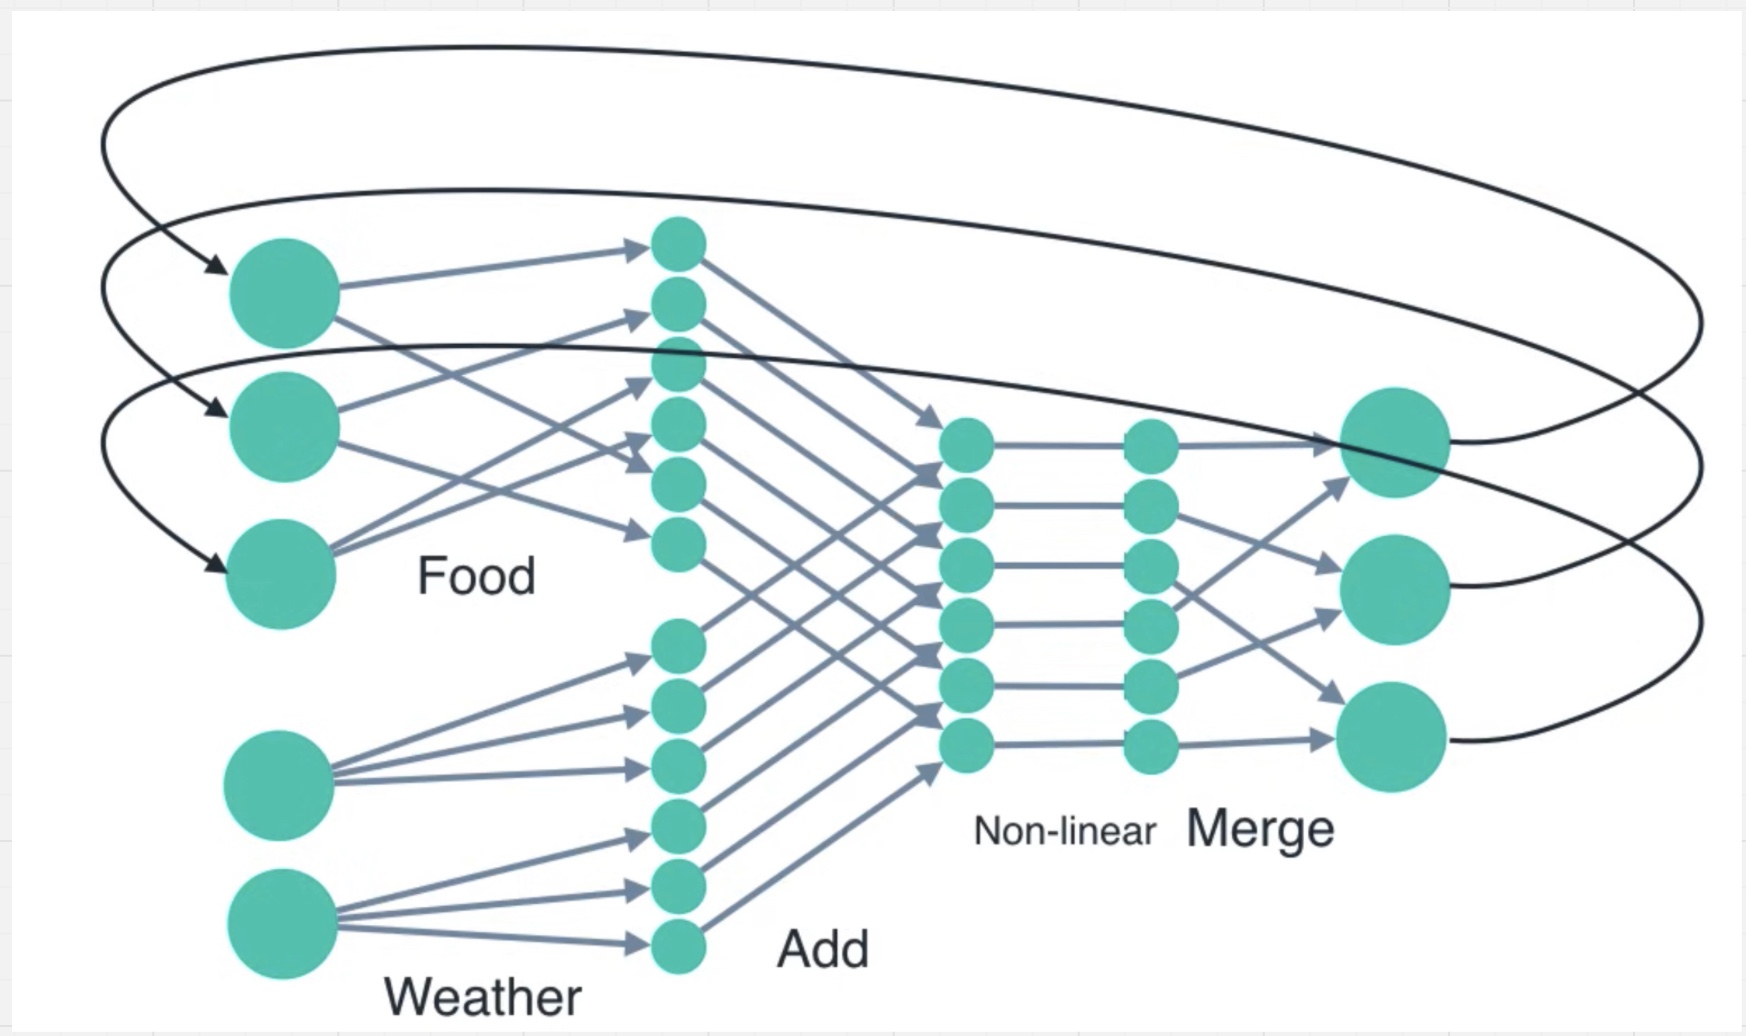
*截图 19|输出回到下一时间步的 Food 输入,天气一路则继续接收新的输入*
长回线表达的是时间上的重复:这次得到汉堡,下次就把汉堡作为旧状态,同时再接入下次的天气。Food 与 Weather 等环节的权重保持共享。
视频是把已知的规则手工搭成一个小网络,主要展示信息如何传递。这一步并没有展示网络如何从数据中学出权重,也没有讲反向传播。最大项置 1 的硬选择通常称为 argmax 后做 one-hot;这种硬选择不适合直接充当常规梯度训练中的可微激活。实际模型常使用 tanh、sigmoid 等函数更新隐藏状态,并在需要输出类别时另作选择。
所以这里要分清两件事:non-linear 是一大类函数的性质,“最大项置 1”只是本视频为解释选择过程使用的一个具体例子。
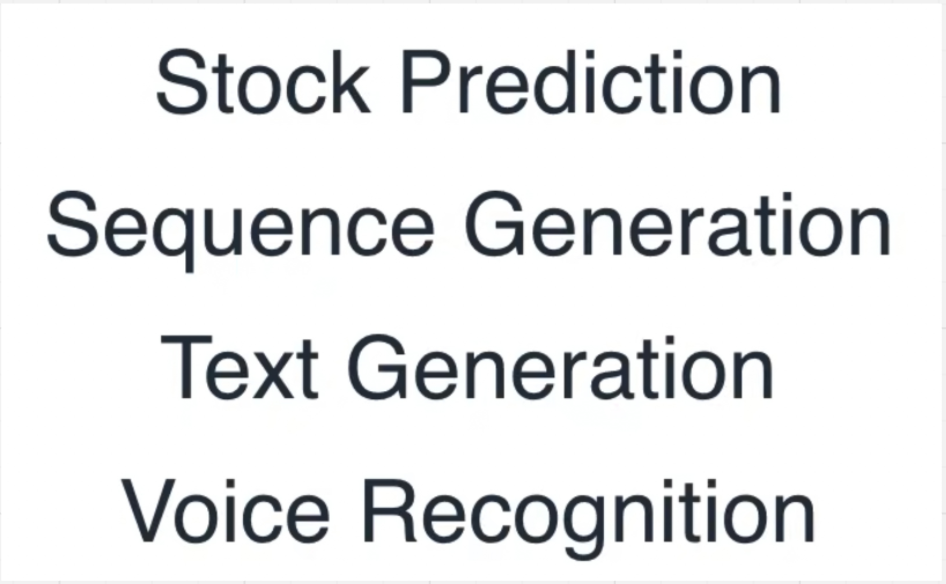
*截图 20|序列预测、序列生成、文本生成与语音识别,都需要利用前后关联*
做饭例子的共同结构可以迁移到更一般的序列任务:输入一个新元素时,结合从前面传来的状态,再更新状态或产生输出。
文本生成利用已生成的上下文继续选择后续内容;语音识别需要利用连续声音片段之间的联系。截图也列出了股票预测,但能建模时间相关性不等于能可靠预测市场收益;这里列的是任务方向,不是效果保证。
读完这组截图,应当能回答三个问题:过去的信息从哪条线来,当前信息从哪条线来,为什么仅仅相加还需要下一步选择。能够亲手算出“苹果派加雨天得到汉堡”,就已经抓住了这个入门例子的核心。