线程层级:thread、block、grid · znzryb
## 先看全貌:grid、block、thread 和下标
一次 kernel 启动(launch)的线程不是一大锅乱炖,而是分了两层:
- **thread(线程)**:最小单位,跑一份 kernel 代码;
- **block(线程块)**:一组线程,例如上图每个 block 8 个线程;
- **grid(网格)**:一组 block,一次 launch 就生成一个 grid。
每个线程能读到几个**内置变量**来知道「我是谁」:
| 变量 | 意思 | 上图里 |
|---|---|---|
| `threadIdx` | 我在本 block 里是第几个 | 0 … 7 |
| `blockIdx` | 我所在的 block 是第几个 | 0 … 3 |
| `blockDim` | 每个 block 有几个线程 | 8 |
`threadIdx` 只在本 block 里不重复,于是线程在整个 grid 里的编号要这样拼:
```cpp
int idx = blockIdx.x * blockDim.x + threadIdx.x; // 2 * 8 + 5 = 21
```
图里黄色那个线程就是这样算出 21 的。这三个变量都是**三维**的(有 `.x` `.y` `.z`),处理向量用一维,处理矩阵、图像用二维,处理体数据用三维,下一篇的矩阵加法就是二维的。
## 一次 launch 生成一个 grid
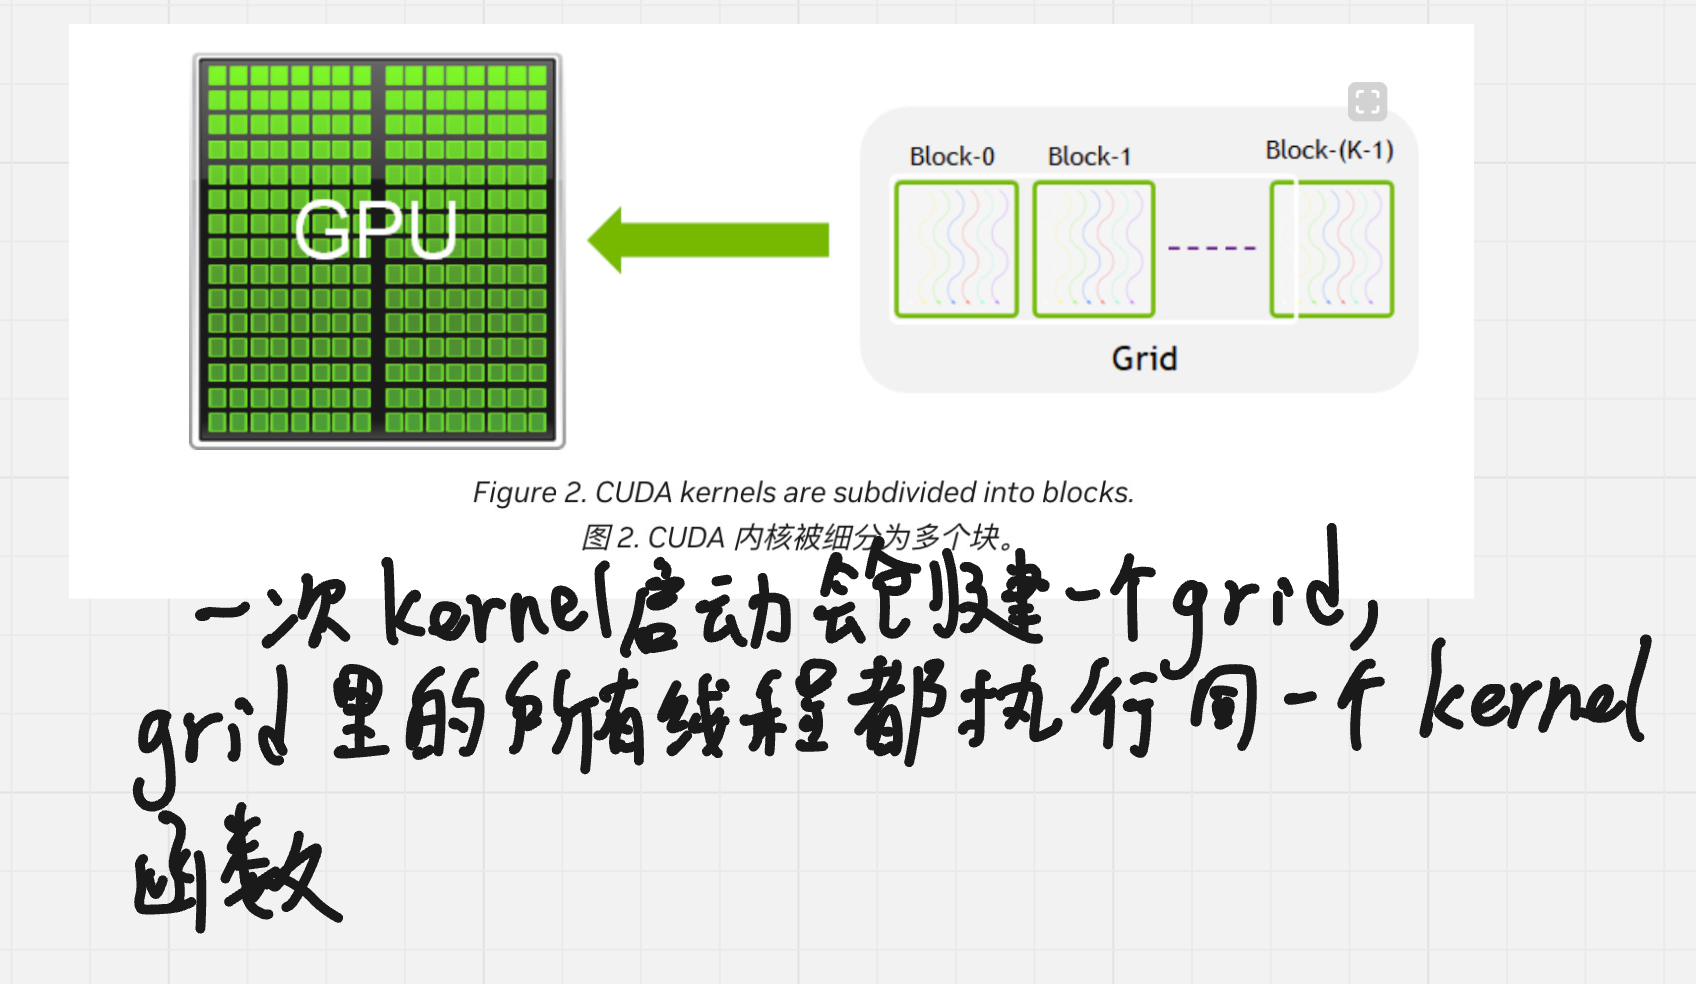
原文 Figure 2 把这层关系画成:右边一个 grid,里面是 Block-0 … Block-(K−1),整个交给左边的 GPU 去跑。我在截图下面写的那句就是要点:**一次 kernel 启动会创建一个 grid,grid 里的所有线程都执行同一个 kernel 函数**。
## 软件的层级怎么落到硬件上
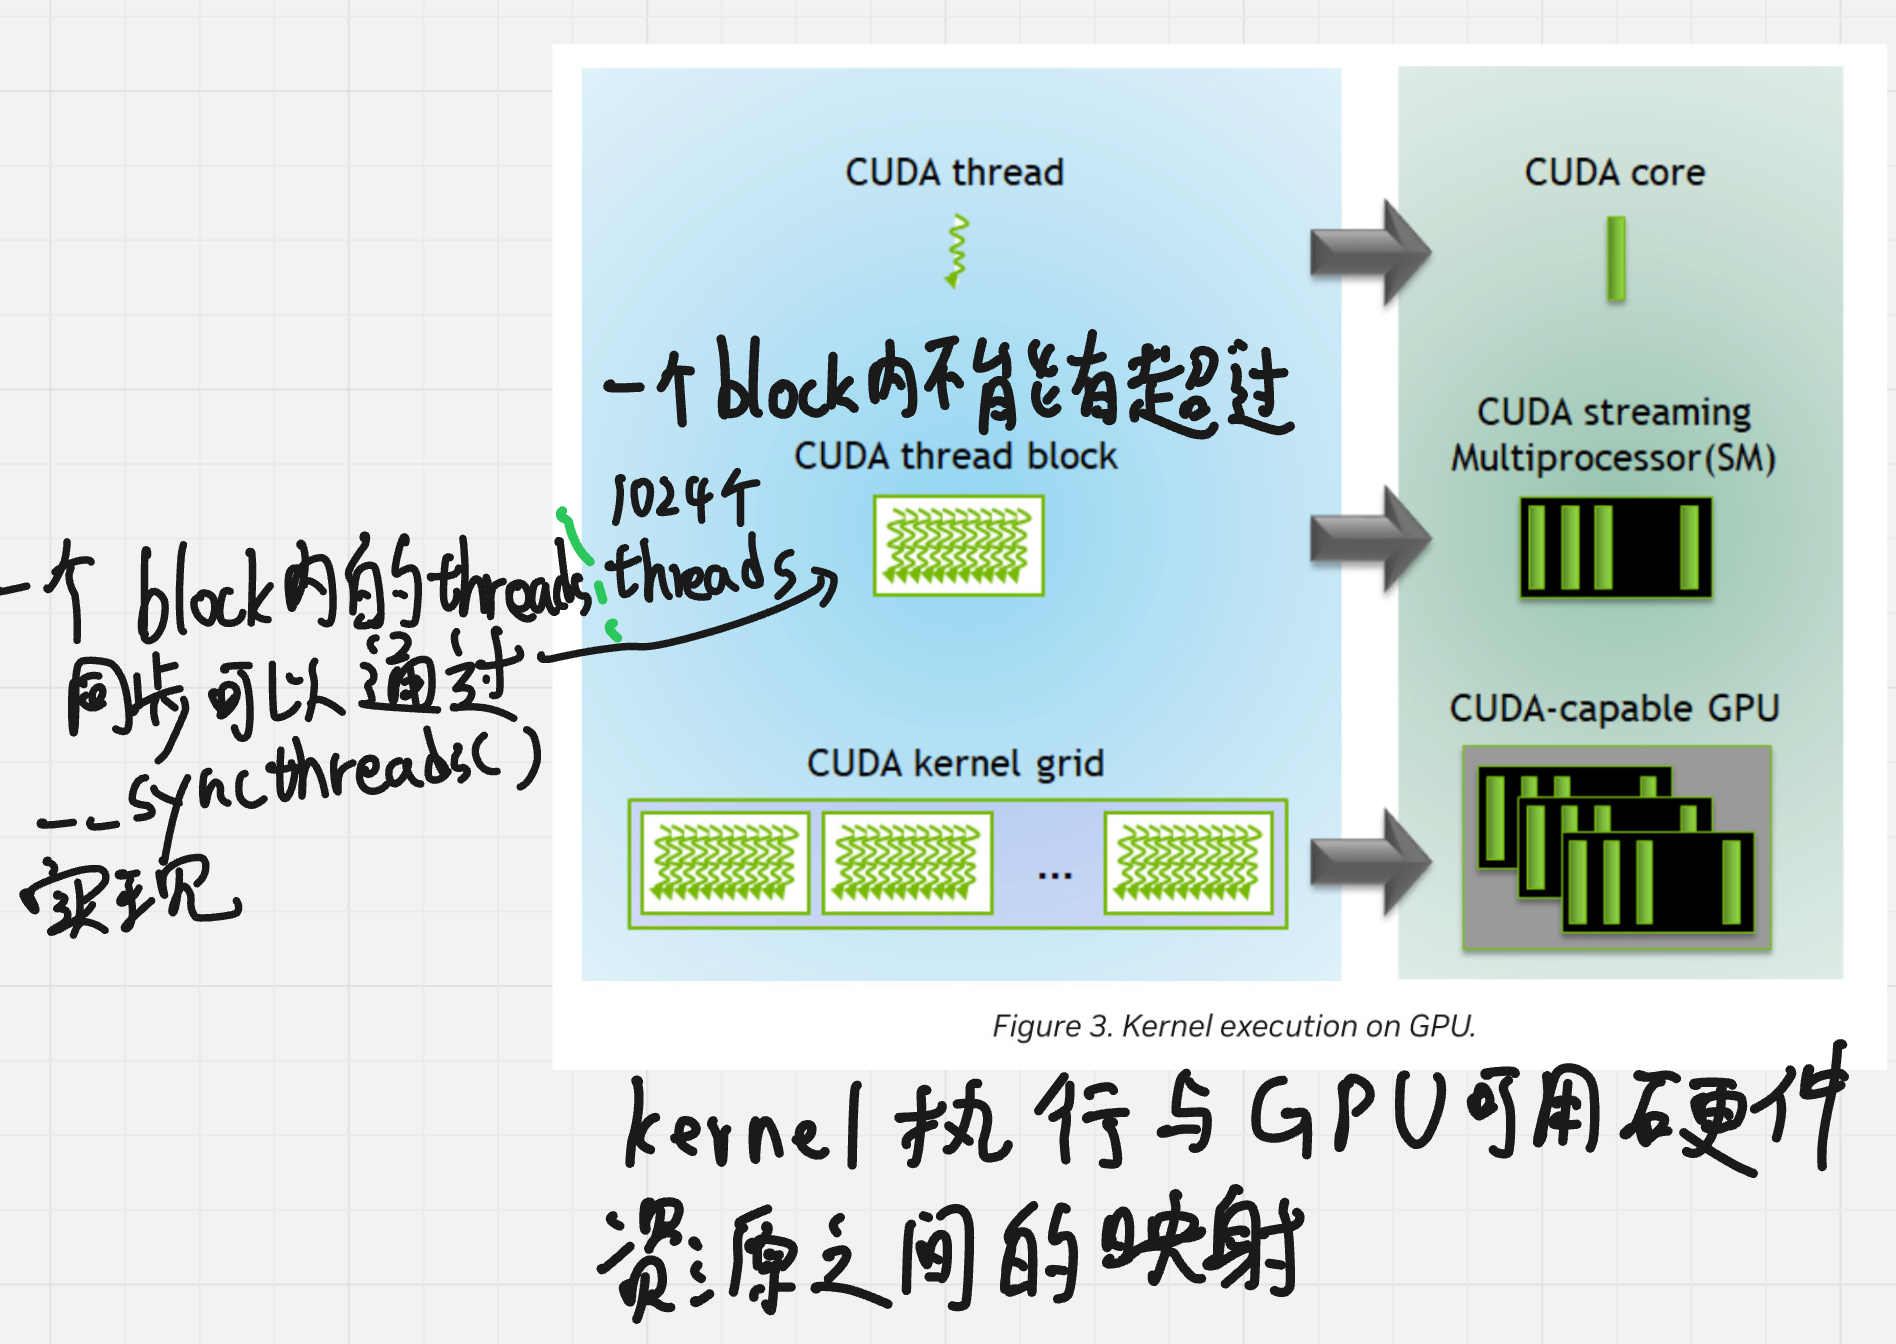
Figure 3 左边是软件概念,右边是硬件,一一对应:
- 一个 **thread** 跑在一个 **CUDA core** 上;
- 一个 **thread block** 交给一个 **SM**(Streaming Multiprocessor,流式多处理器);
- 一个 **kernel grid** 铺满整块 **GPU**。
截图左边的两条手写批注,正好是 block 这一层的两条规矩:
1. **一个 block 里最多 1024 个线程**;
2. **同一个 block 里的线程可以用 `__syncthreads()` 同步**:所有线程跑到这一行都要停下,等本 block 里的线程全到齐了再一起往下走。不同 block 之间没有这种同步手段。
## 为什么要有 block 这一层
原文说:一个 block 由一个 SM 执行,**除了抢占、调试、动态并行这几种情况,不会迁移到别的 SM 上**;一个 SM 上可以同时驻留多个 block,具体几个取决于它们占多少资源;同一块 GPU 上还可以同时跑多个 kernel。
block 之间互不依赖、也不能互相同步,换来的好处就是上图这样:**同一份代码**,放到只有 2 个 SM 的小卡上,每个 SM 排着跑 4 个 block;放到有 4 个 SM 的大卡上,每个 SM 只要跑 2 个,自动快一倍。程序员只管把活切成 block,分到哪个 SM 由硬件调度。