矩阵加法与异步 launch · znzryb
## 先看全貌:16×16 的 block 怎么铺满一个矩阵
这一篇用原文的例子 `C = A + B`(两个 N×N 矩阵相加)把前两篇串起来。思路很直接:**一个线程负责 C 的一个格子**。
上图取 N = 40:
- 每个 block 是 16×16 = 256 个线程(绿框);
- 一个方向要几个 block?40 ÷ 16 = 2.5,**向上取整**成 3,所以 grid 是 3×3 个 block;
- 一共 48×48 = 2304 个线程,比 40×40 = 1600 个格子多出 704 个,落在暗红区域。
## 代码
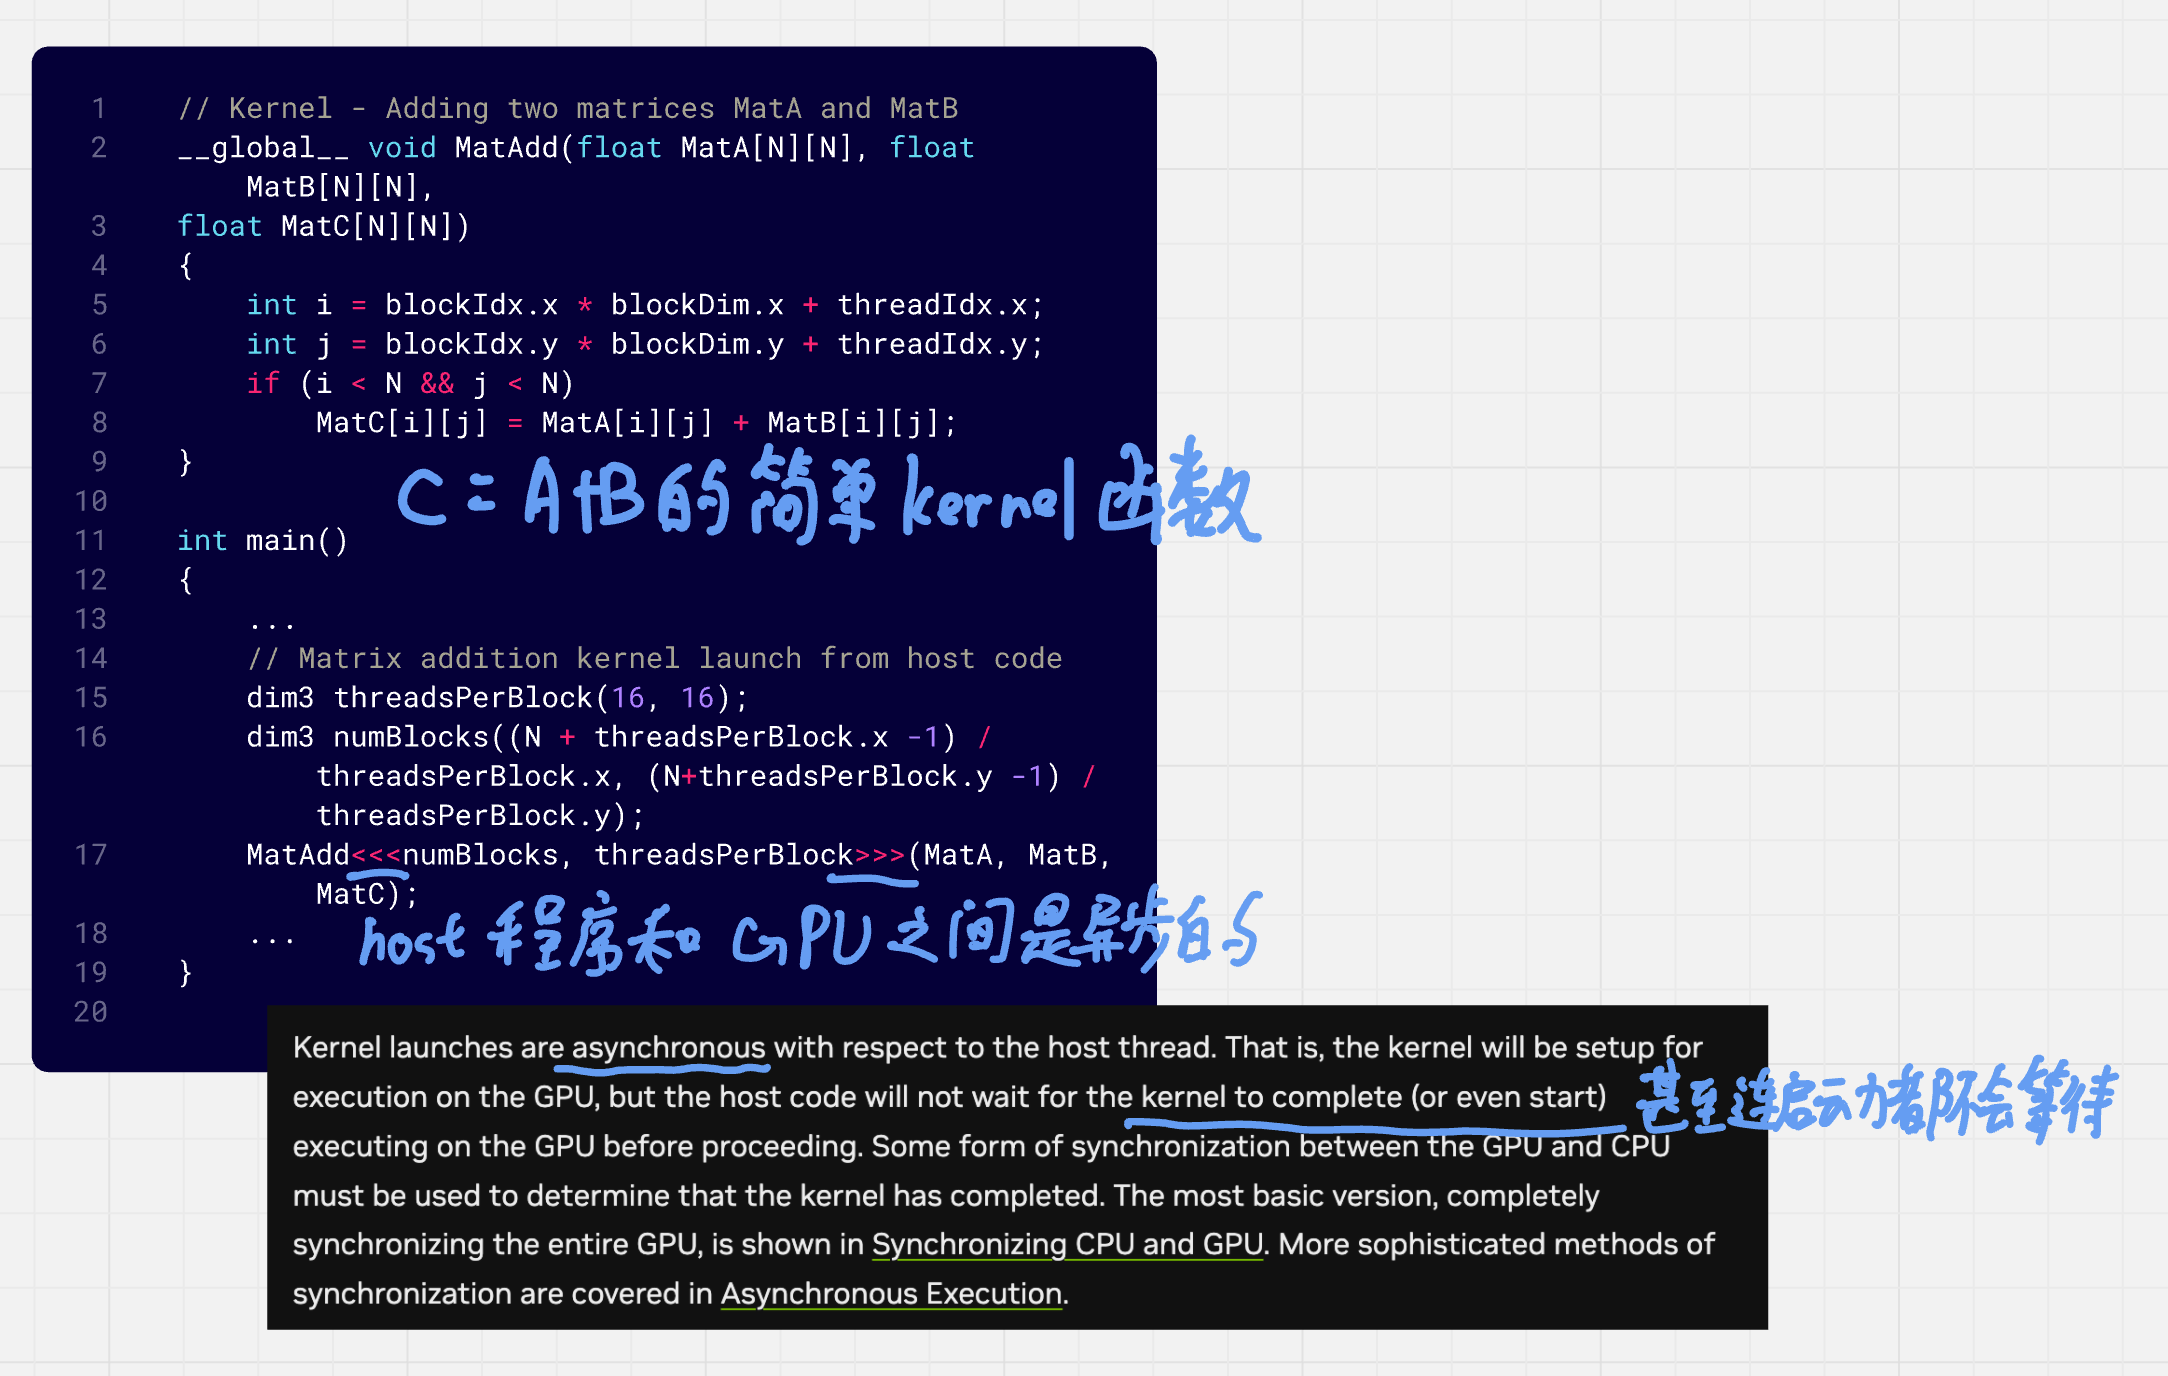
对照截图里的代码看(截图里的蓝字是我的批注):
**kernel 部分(第 2–9 行)**
```cpp
__global__ void MatAdd(float MatA[N][N], float MatB[N][N], float MatC[N][N])
{
int i = blockIdx.x * blockDim.x + threadIdx.x;
int j = blockIdx.y * blockDim.y + threadIdx.y;
if (i < N && j < N)
MatC[i][j] = MatA[i][j] + MatB[i][j];
}
```
- 第 5、6 行就是上一篇的下标公式,x、y 两个方向各算一次。全貌图里的黄点:`blockIdx = (1,2)`、`threadIdx = (5,3)`,算出 `i = 1×16+5 = 21`、`j = 2×16+3 = 35`,它负责 `C[21][35]`;
- 第 7 行的 `if` **不能省**:全貌图里的红点算出 `i = 44`,超出了矩阵。因为向上取整多开了线程,这些线程必须什么都不做,否则就写到数组外面去了。
**主机部分(第 15–17 行)**
```cpp
dim3 threadsPerBlock(16, 16);
dim3 numBlocks((N + threadsPerBlock.x - 1) / threadsPerBlock.x,
(N + threadsPerBlock.y - 1) / threadsPerBlock.y);
MatAdd<<<numBlocks, threadsPerBlock>>>(MatA, MatB, MatC);
```
- `dim3` 是三维尺寸,没写的维度默认是 1;
- `(N + 16 - 1) / 16` 是整数除法里**向上取整**的老写法:N = 40 时得 3;
- `<<<numBlocks, threadsPerBlock>>>` 是 CUDA 专门的启动语法:尖括号里第一个是 grid 有几个 block,第二个是每个 block 有几个线程,两个参数都可以是 `int` 或 `dim3`。
## launch 是异步的
截图下半部分那段英文是 CUDA 编程指南里的原话,我的批注是「host 程序和 GPU 之间是异步的」「甚至连启动都不会等待」:
- 第 17 行执行时,主机只是把这个 kernel **排进 GPU 的任务队列**,马上就返回,接着跑下一行;
- 这时 GPU 上的 kernel **可能还没算完,甚至还没开始**;
- 所以主机想用结果之前,必须先做一次**同步**。最简单粗暴的办法是 `cudaDeviceSynchronize()`,等整块 GPU 上的活全部干完。更精细的办法(stream、event)属于异步执行的话题,这里先不展开。
上图里红色那一段就是主机在等;没有它就去读结果,读到的很可能是还没算完的数据。