主机、设备与 kernel · znzryb
> 这个专栏是读 NVIDIA 官方博客 [CUDA Refresher: The CUDA Programming Model](https://developer.nvidia.com/blog/cuda-refresher-cuda-programming-model/) 的笔记,文中的截图带着我读的时候写的手写批注。
## 先看全貌:一个 CUDA 程序在干什么
CUDA 里有两个角色:
- **主机(host)**:就是 CPU,加上它旁边的内存(主机内存)。`main()` 跑在这里。
- **设备(device)**:就是 GPU,加上它自己的显存(设备内存)。
两块内存是**分开的**,中间隔着一条 PCIe 总线。所以几乎每个 CUDA 程序都是上图那三步:
1. **拷进去**:把输入数据从主机内存拷到显存;
2. **在 GPU 上算**:主机下令启动一个 GPU 函数,GPU 读显存、计算、把结果写回显存;
3. **拷回来**:把结果从显存拷回主机内存。
第 2 步里那个「GPU 函数」,就是 CUDA 的核心概念:**kernel**。
## kernel:一个函数,被很多线程各跑一次
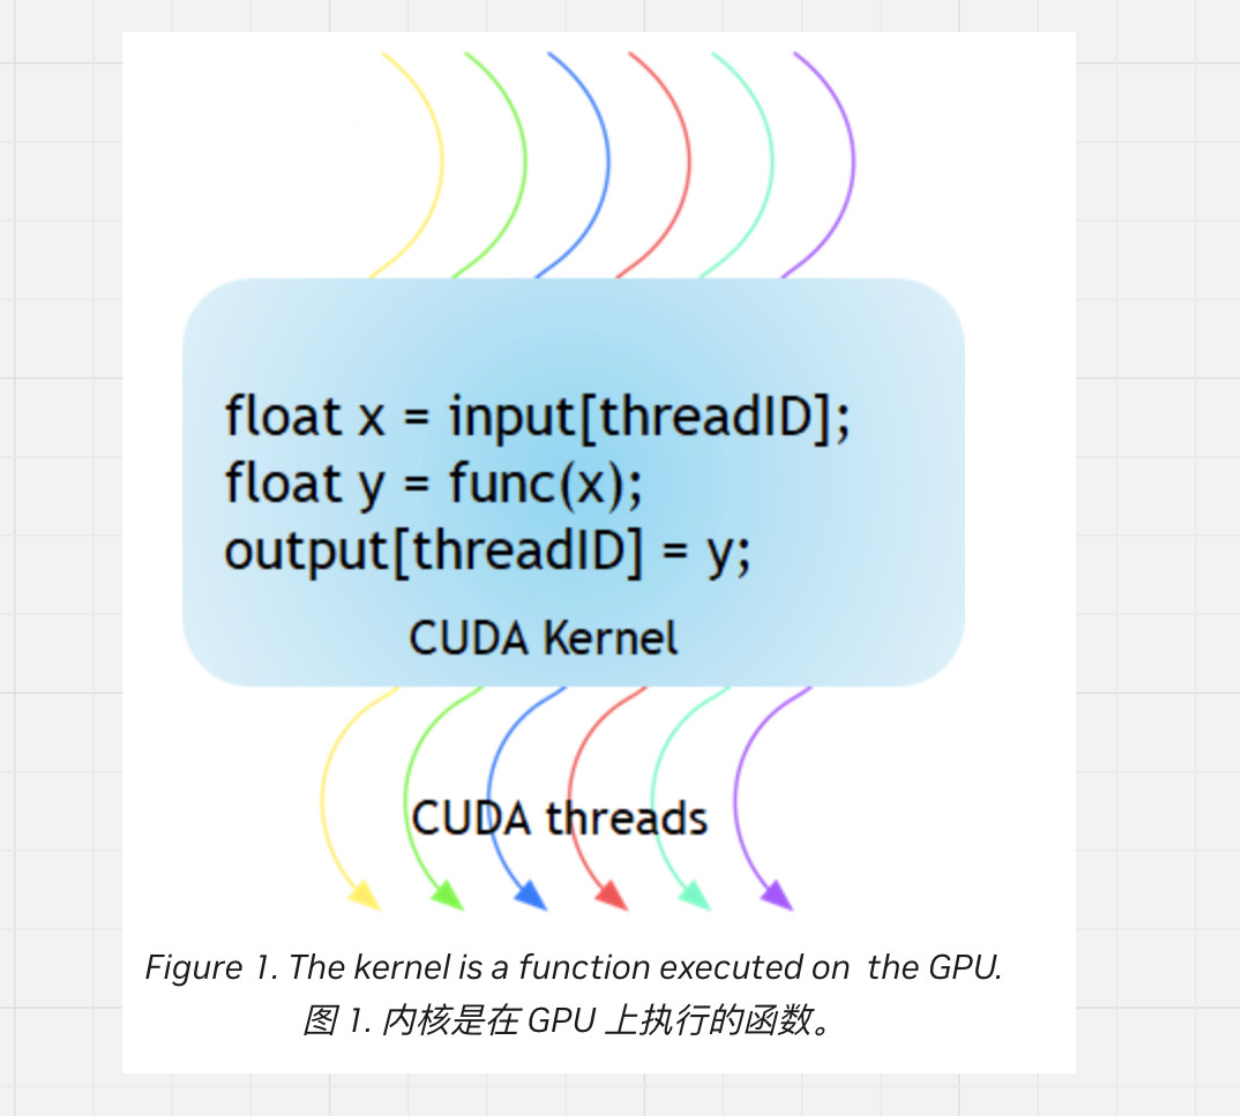
kernel 是**在 GPU 上执行的函数**,写法是在函数前面加 `__global__`。它和普通 C++ 函数最大的区别是**跑几次**:
- 普通函数调用一次就执行一次;
- kernel 启动一次,会被 **K 个 CUDA 线程各执行一次**。
上面截图里 kernel 的函数体只有三行:每个线程用自己的 `threadID` 取出一个输入,算一下,再写回对应的位置。六根彩色的线就是六个线程,它们跑的是**同一份代码**,只是手里的编号不同,所以处理的数据也不同。
## 和 for 循环对比一下
同样是「给 8 个数各做一次 `func`」:
- 左边的 CPU 写法:**一个线程**,`for` 循环转 8 圈,一圈处理一个;
- 右边的 kernel 写法:**8 个线程**,每个线程只处理 `in[threadID]` 这一个,大家同时开跑。
所以写 kernel 的思路是:**把循环体拿出来,让「循环变量」变成「线程编号」**。至于线程编号怎么来、几千几万个线程怎么组织,就是下一篇要讲的线程层级。