内存层次与计算能力 · znzryb
## 先看全貌:每层内存谁看得见
线程有层级,内存也有层级,而且两者是对上的:**越私有的内存离线程越近、越快**。
| 内存 | 谁能访问 | 在哪 |
|---|---|---|
| 寄存器 | 只有这一个线程 | SM 里 |
| L1 / 共享内存(SMEM) | 同一个 block 的线程(共享内存部分) | SM 里,片上 |
| 只读内存(常量、纹理等) | 所有线程只读 | 每个 SM 都有 |
| L2 缓存 | 所有 SM 共用 | 片上 |
| 全局内存(显存) | 所有线程读写,主机也在这儿拷进拷出 | 板上 DRAM |
## 原文的内存层次图
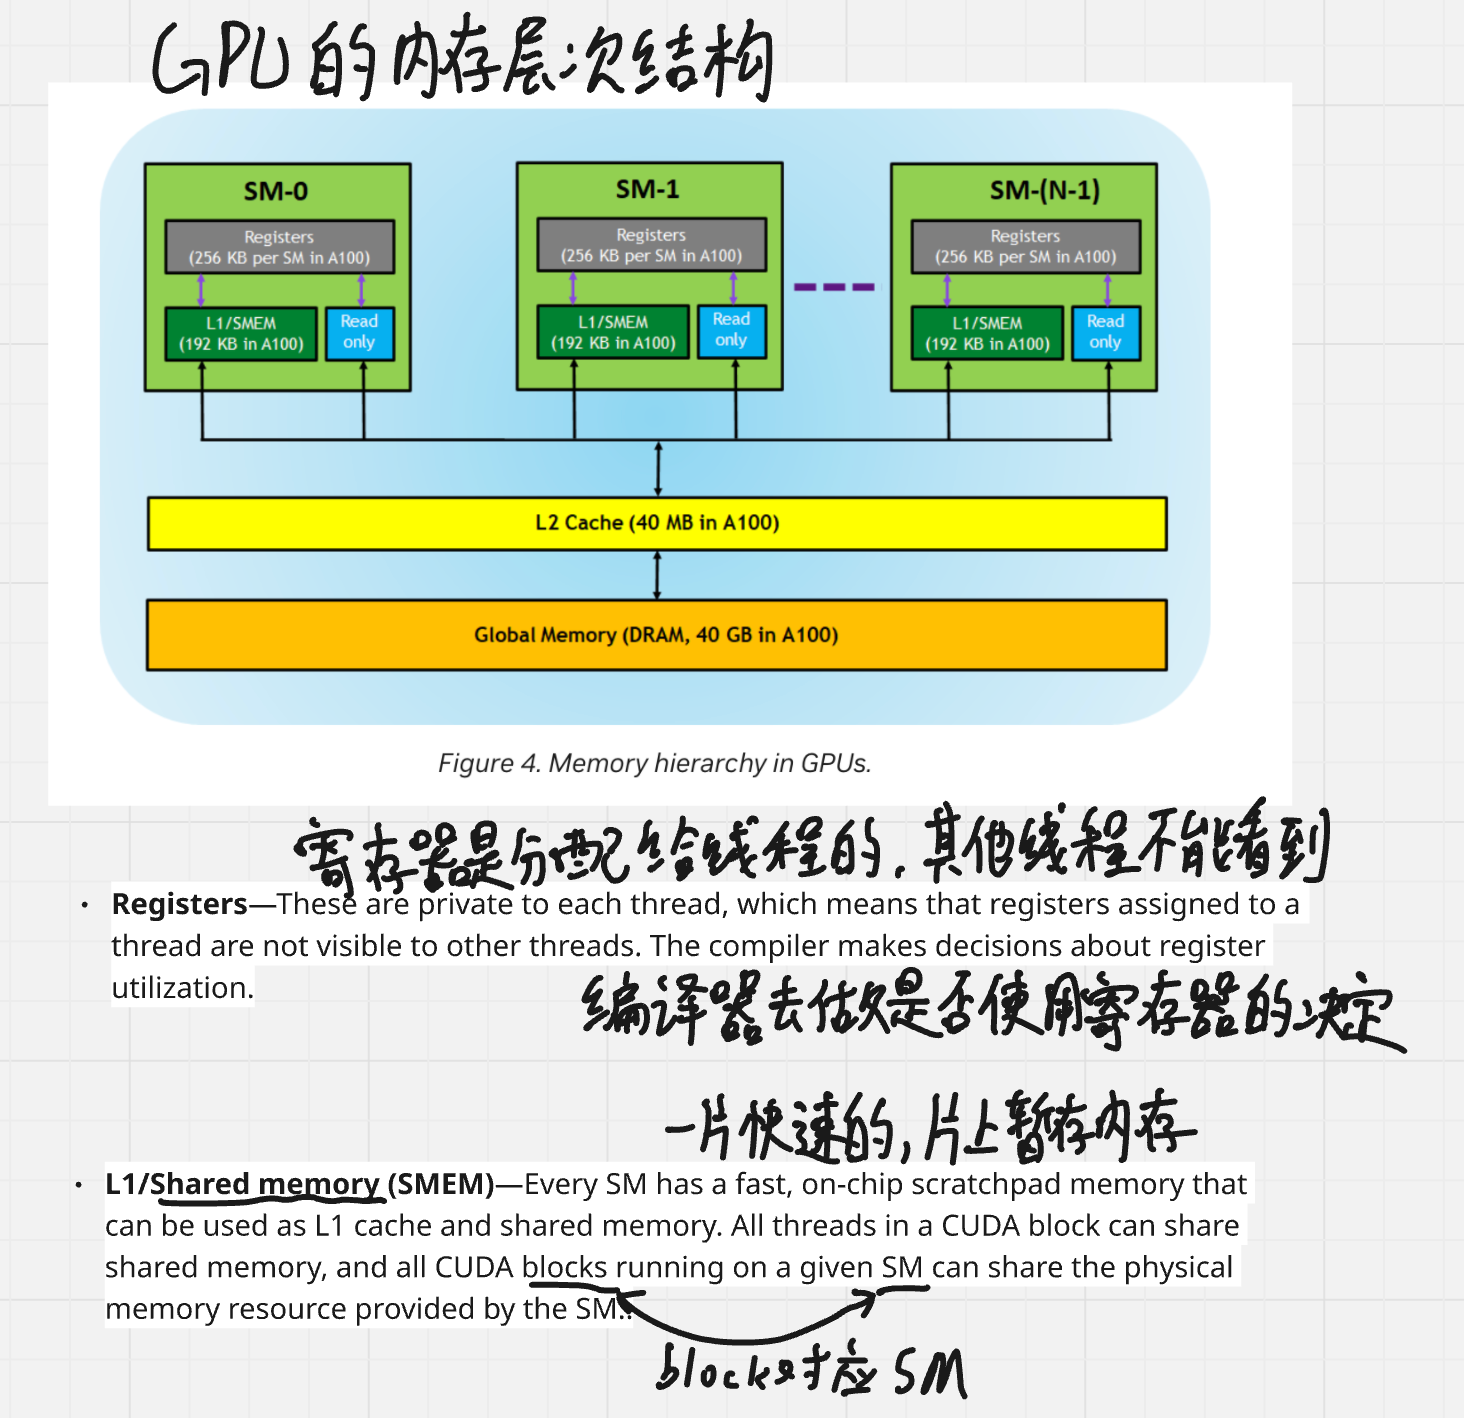
Figure 4 以 A100 为例把每层画出来,截图里的批注逐条对应:
- **寄存器**:每个 SM 有 256 KB。寄存器是**分配给线程的,别的线程看不到**;用多少寄存器、哪个变量放进寄存器,**由编译器决定**。
- **L1 / 共享内存**:每个 SM 有 192 KB,是**一片快速的片上暂存内存**,可以一部分当 L1 缓存用、一部分当共享内存用。一个 block 里的所有线程共享这块共享内存,**跑在同一个 SM 上的所有 block** 共同分这个 SM 的物理资源。批注里那个「block 对应 SM」的箭头就是这层关系:上一篇说过一个 block 只在一个 SM 上跑,所以它能用的共享内存就是那个 SM 上的。
- **只读内存**:每个 SM 都有指令缓存、常量内存、纹理内存和只读缓存,kernel 只能读不能写。
- **L2 缓存**:所有 SM 共用。A100 把 L2 加到了 40 MB,上一代 V100 只有 6 MB。
- **全局内存**:就是显卡上的 DRAM(显存),A100 有 40 GB。第一篇里「拷进去、拷回来」搬的就是这一层。
## 容量差多少
横轴按对数画,即便这样,从寄存器到显存也差了好几格:寄存器和共享内存按 **KB** 算(而且是每个 SM 才这么点),L2 按 **MB**,显存按 **GB**。
原文的结论是:大多数时候编译器会把内存用得不错,但**懂行的开发者可以手动把这套层次用得更好**,比如把一个 block 反复要读的数据先从显存搬进共享内存,后面就只读共享内存。这也是 CUDA 性能优化里最常见的一招。
## 计算能力(Compute Capability)
每块 GPU 都有一个计算能力版本号 **X.Y**:
- **X 是主版本**,对应一代架构;
- **Y 是次版本**,是同一代里的渐进改进,可能带来新特性。
程序可以在运行时读到这个版本号,据此判断当前 GPU 支持哪些硬件特性和指令。想看自己显卡的计算能力和各项参数,跑一下 CUDA 示例程序 `deviceQuery` 就行。
## 小结
把四篇连起来:
1. CUDA 是**异构**编程:C/C++ 主程序跑在 CPU 上,kernel 跑在 GPU 上,两边内存分开,数据经 PCIe 拷来拷去;
2. 一次 launch 生成一个 **grid**,grid 由 **block** 组成,block 由 **thread** 组成,线程靠 `blockIdx × blockDim + threadIdx` 找到自己的数据;
3. block 落在 SM 上,线程落在 CUDA core 上;launch 对主机是**异步**的,用结果前要同步;
4. 内存从寄存器到显存层层变大变慢,用好它是优化的关键。