从逐词解码到训练损失 · znzryb
> 本篇主要参考 Jay Alammar 的 [The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/),结合学习截图与批注整理。原文图示及相应中文改编沿用 [CC BY-NC-SA 4.0](https://creativecommons.org/licenses/by-nc-sa/4.0/)。以下继续讨论用于翻译的原始 Encoder–Decoder Transformer。
## 先把一句话的生成过程摊开
编码器先读完整个源句子,得到一组固定的编码表示。解码时,模型反复读取已知的目标前缀,每次预测下一个 token,把选出的 token 接回前缀,直到生成结束标记或触及长度上限。
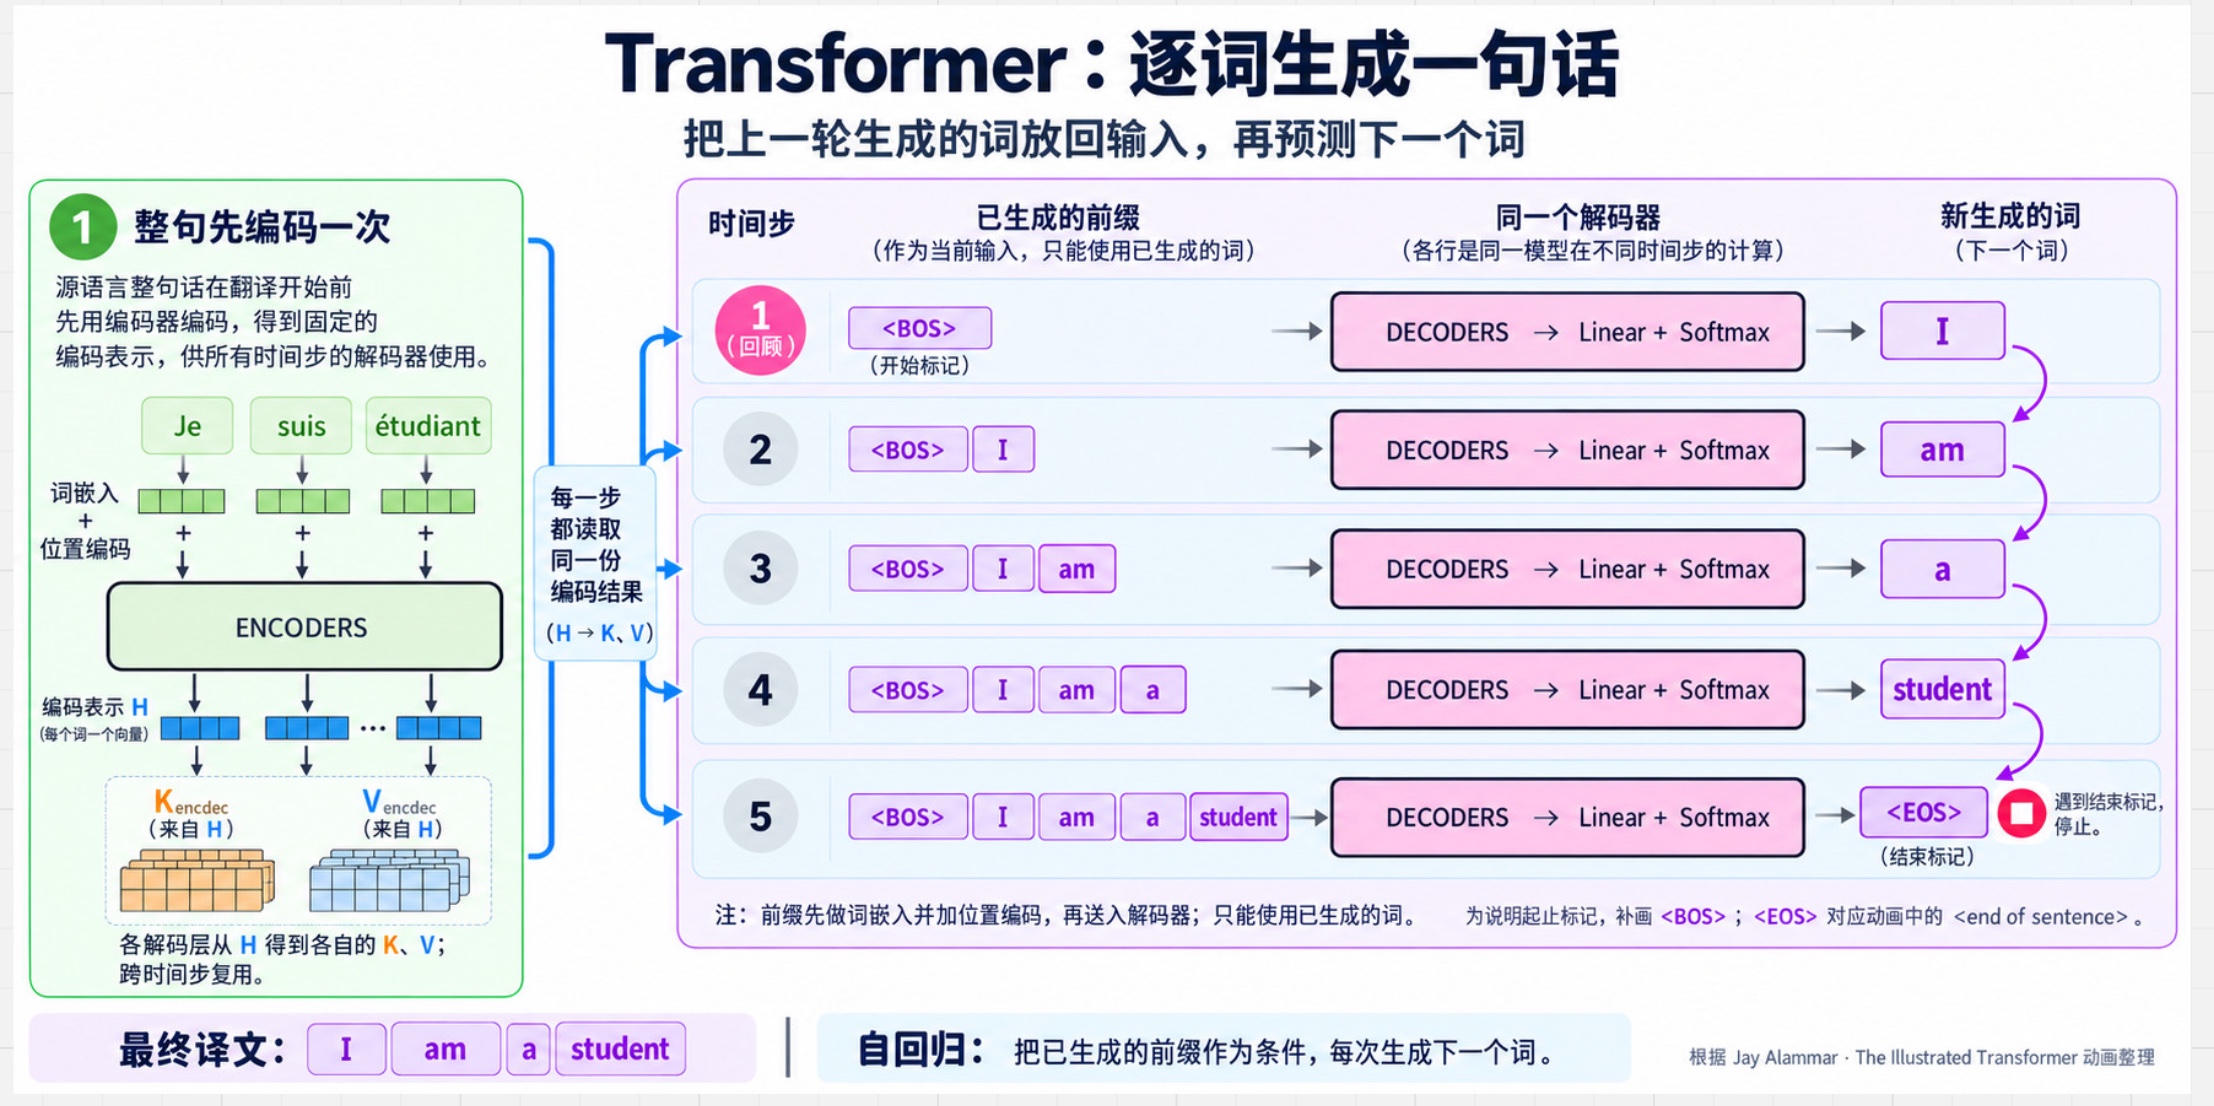
*图 29:从开始标记到 I am a student,再到结束标记的完整流程。原始截图与手写批注。*
图中每一行都是**同一个解码器在不同时间步的计算**,不是五套参数不同的解码器,也不是把五个时间步当成五层网络。第一轮还没有译文,所以先给一个开始标记;之后每轮多知道一个目标 token。
这里“编码一次”说的是翻译时源句子不变,编码结果可以复用。不同解码层仍有各自的交叉注意力投影,不能把“共享同一份编码结果”误读成“所有解码层共享同一份投影参数”。
## 看清第一步:Q 来自哪边,K/V 来自哪边
源句的最终表示记作 $H$。每个解码层的交叉注意力,都从 $H$ 投影得到该层使用的 K/V;Q 则来自解码侧经过带遮罩自注意力等处理后的表示。
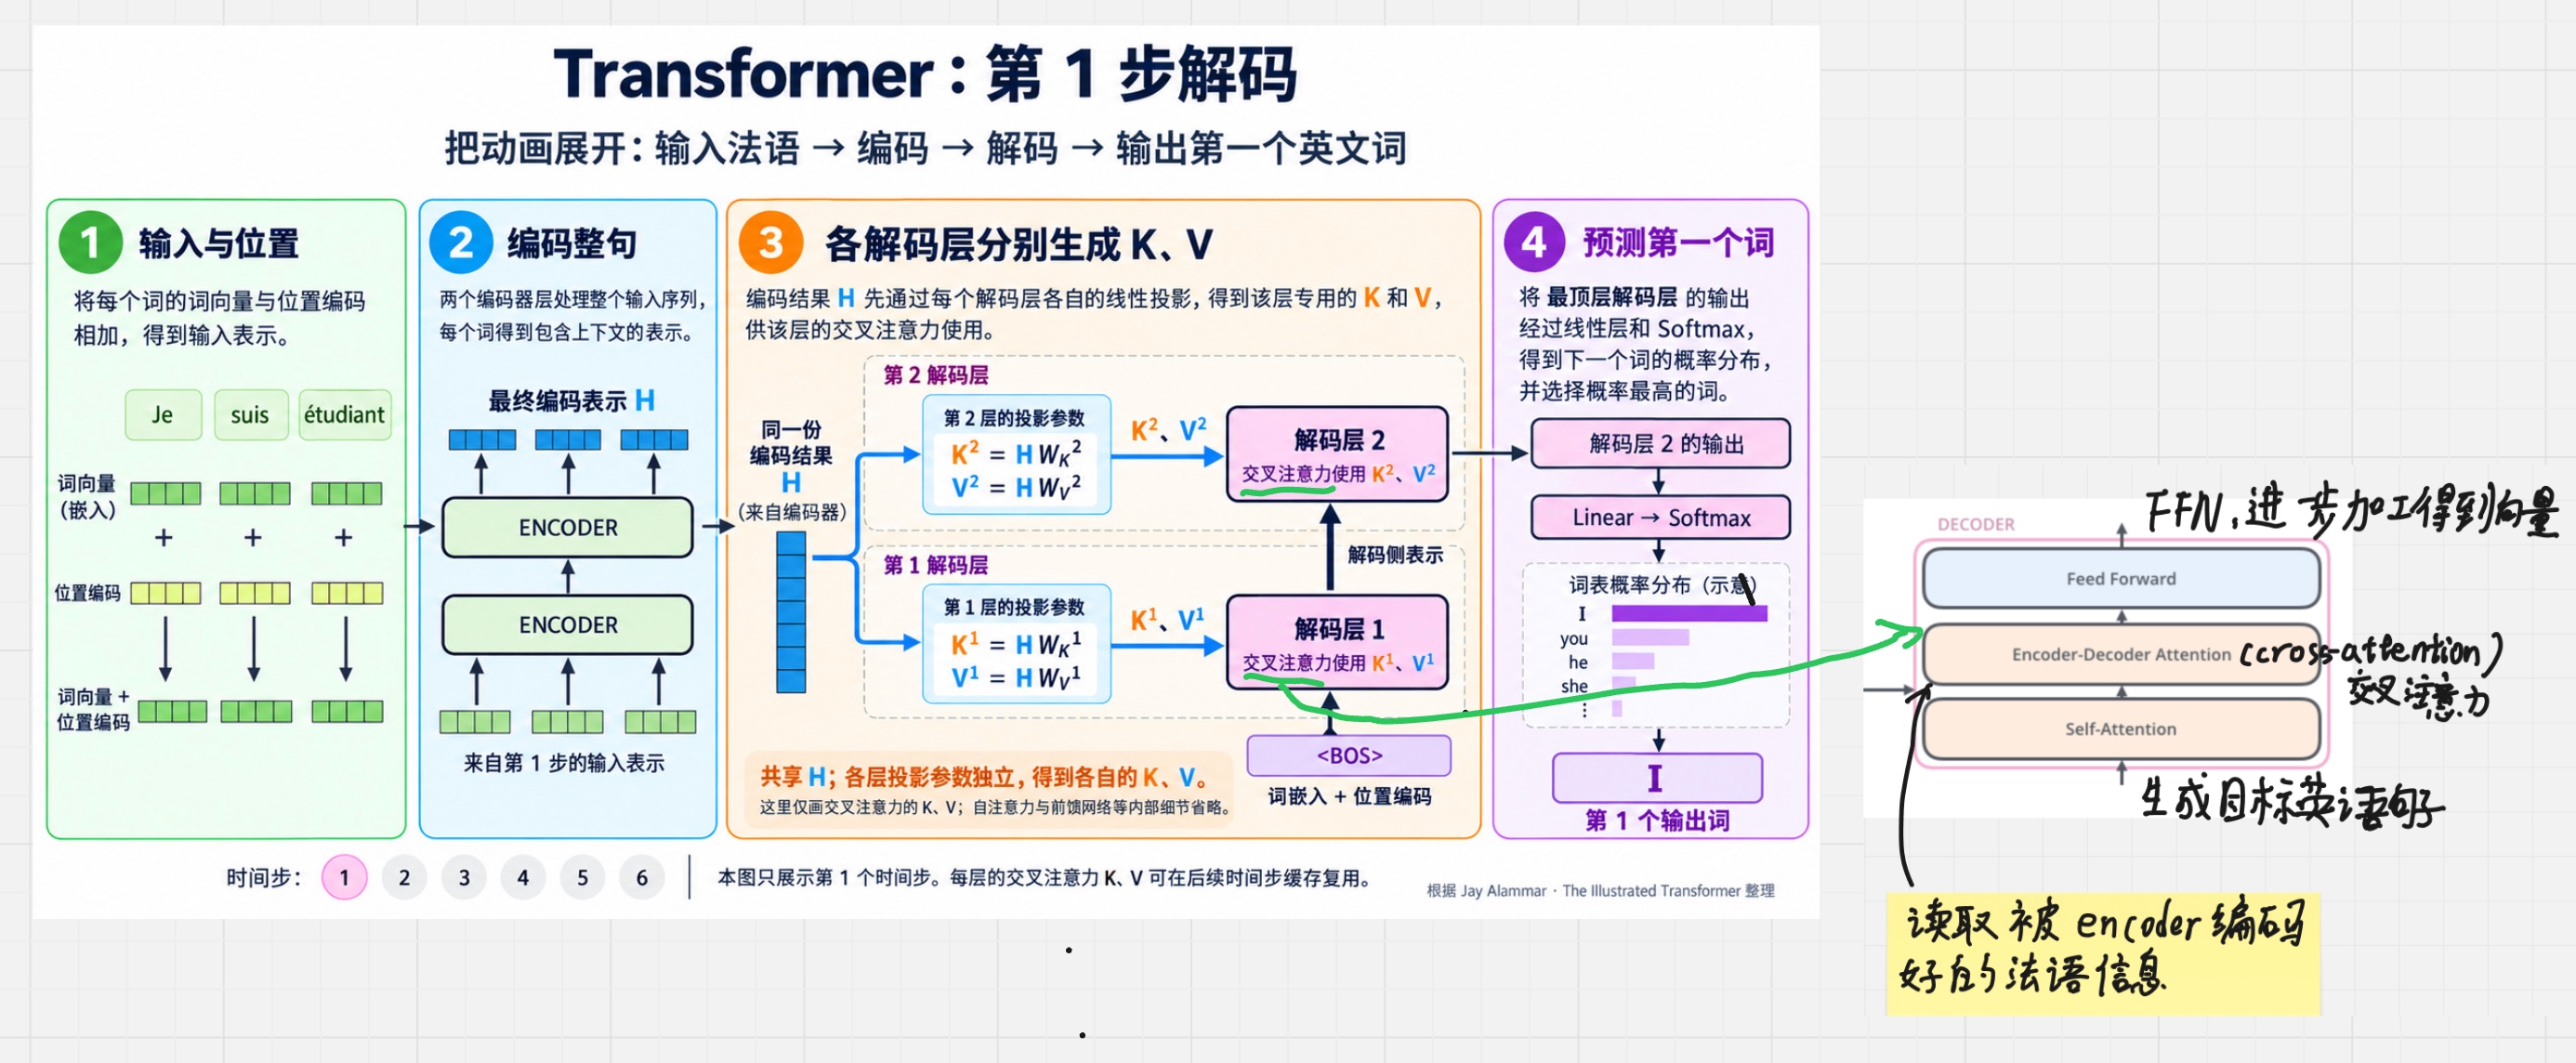
*图 30:第一个时间步里,各解码层分别读取编码结果并产生首个输出。原始截图与手写批注。*
这正是 cross-attention 和 self-attention 的关键区别。它们都在“用 Q 与 K 匹配,再按权重汇总 V”,但交叉注意力的两边来自不同序列:目标侧发起查询,源侧提供可检索的内容。各解码层的 K/V 在源句不变时也可以缓存复用。
假设源句有 $n$ 个 token、当前目标前缀有 $m$ 个 token,交叉注意力的分数矩阵就是 $m\times n$。每个目标查询都对源句的各位置分配权重;它不要求源句和目标句等长。
## 为什么解码器不能偷看后面的答案
生成 `am` 时,我们已知前面的 `I`,但还没生成后面的 `a student`。解码器的自注意力必须遵守这个信息边界。做法是在 softmax 之前,把未来位置的分数设成负无穷,让那些位置的权重变为 0。
更准确地说,解码器输入位置 $i$ 可以读取它自己和更早的输入位置。训练时输入与标签错开一位:用开始标记预测 `I`,用 `I` 预测 `am`,所以“允许看当前位置的输入”仍然没有泄漏当前要预测的标签。
这种遮罩通常叫 causal mask。它用于目标侧自注意力;源句在翻译前已经完整给出,交叉注意力通常可以读取整句源文本,另用 padding mask 排除填充位置。
## 最后一个向量怎样变成一个词
顶层解码器给出的是向量,还不是 token。输出线性层把它投影成词表里每个候选 token 的分数,称为 logits;接着 softmax 将这些分数转换成概率分布。
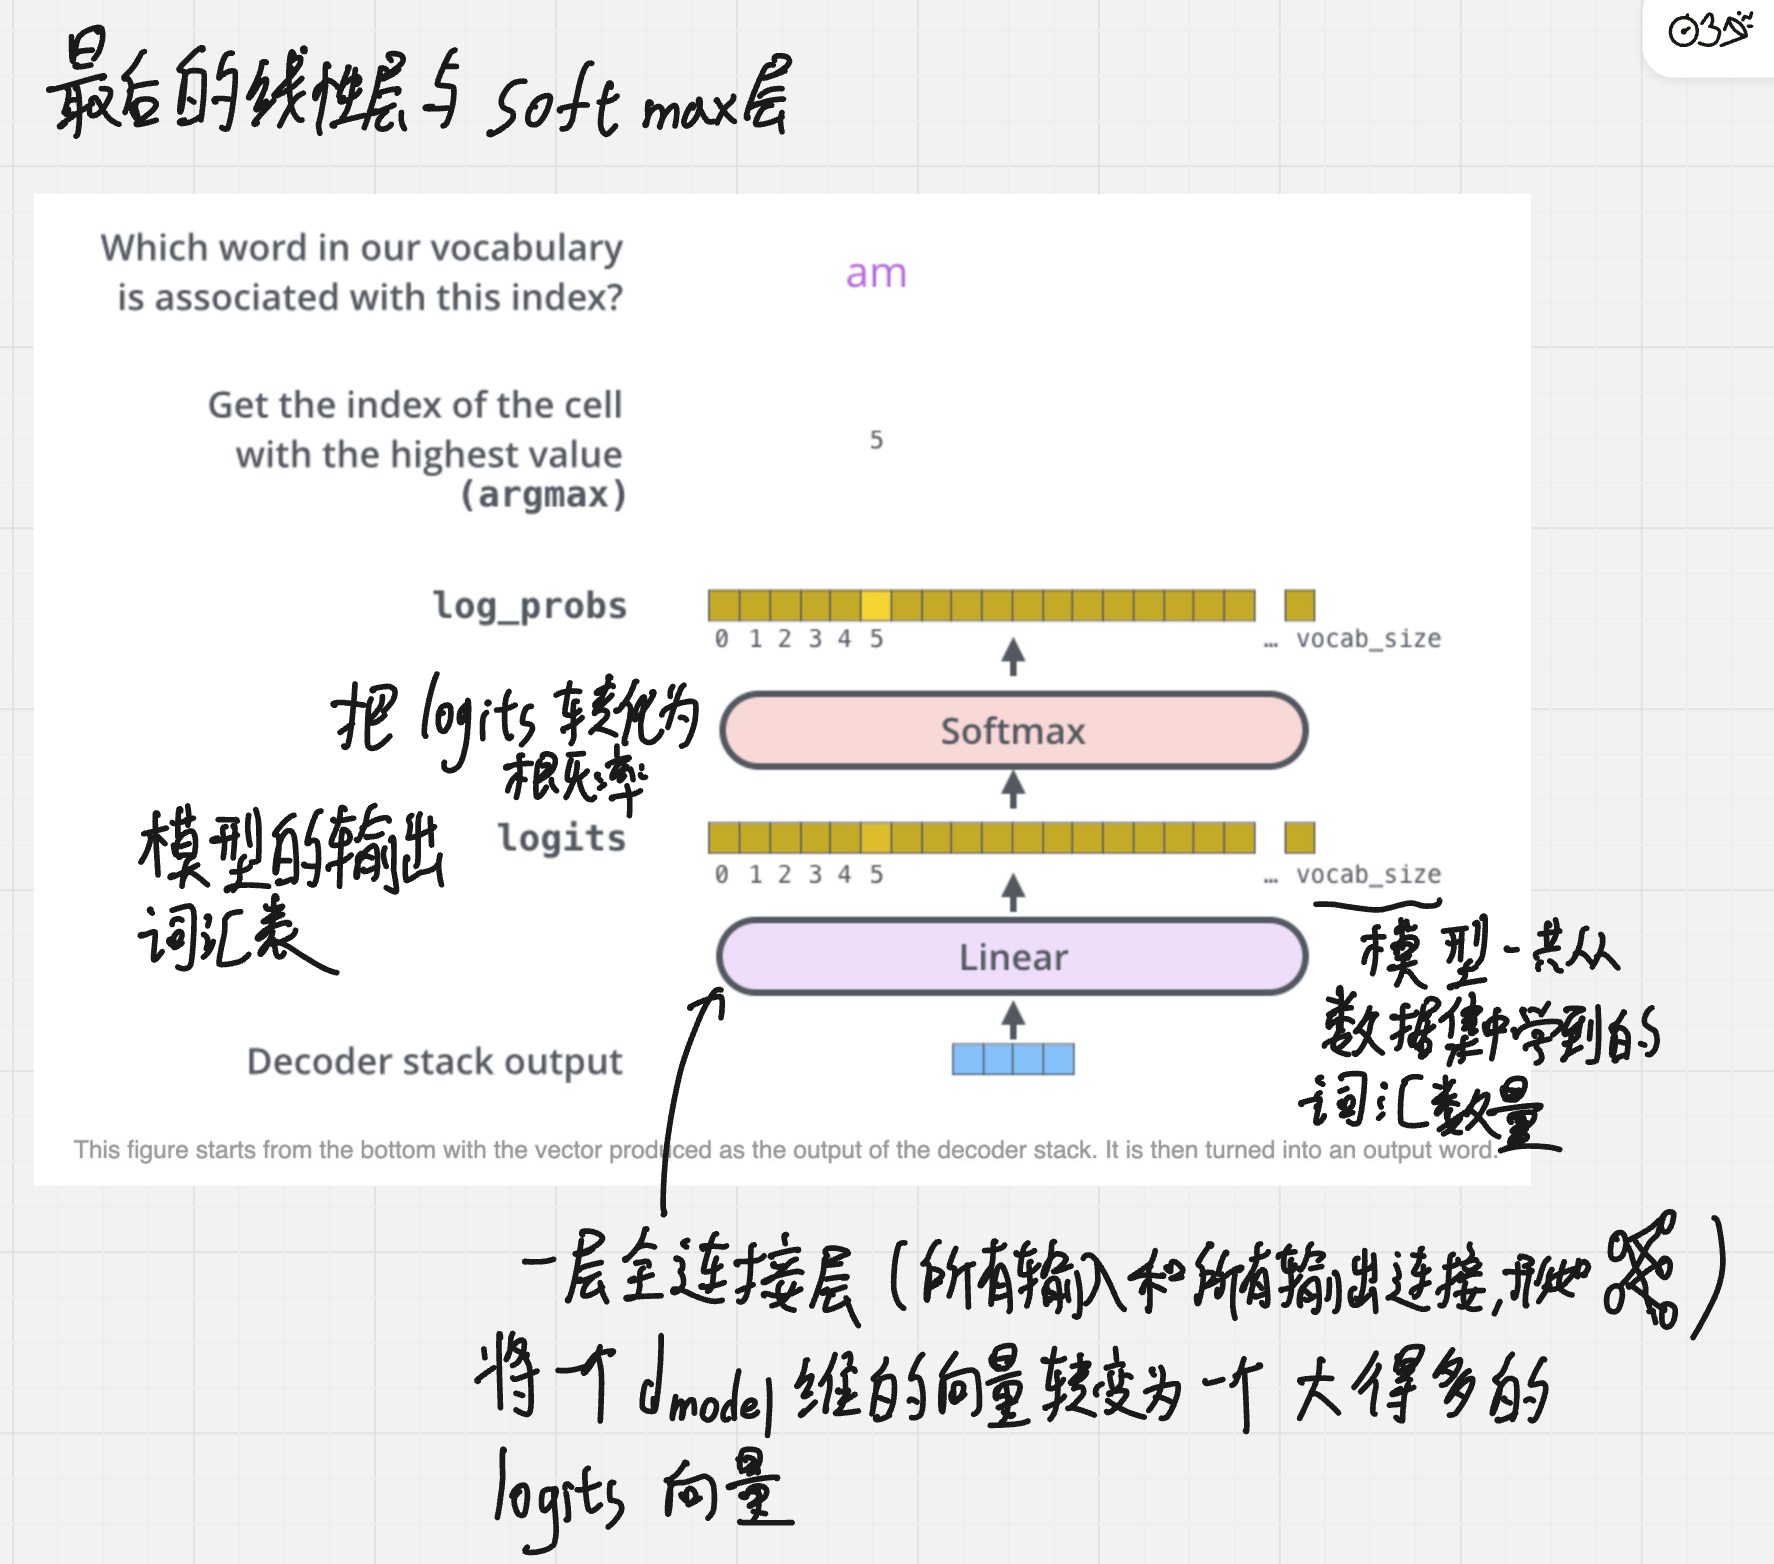
*图 31:解码器输出经过 Linear 与 Softmax,得到词表概率。原始截图与手写批注。*
如果隐藏表示是 512 维,词表有 10000 项,这一层就把 512 维映射到 10000 个分数。第几个分数对应哪个 token,由词表的编号决定。这里的 softmax 沿**词表方向**归一化;上一篇注意力中的 softmax 则沿**被参考位置方向**归一化,二者用途不同。
有了分布,还需要选择策略。每次取最大概率 token 是贪心解码;也可以保留多个候选前缀,用 beam search 比较累计分数。后者不是预先知道正确译文后比较“谁错得少”,而是按照模型给出的序列分数搜索,也不保证一定找到全局最优序列。
## 训练时,答案不是一个英语字符串就结束了
训练数据给出了源句与正确译文,模型需要把每个位置的正确 token 概率提高。先看截图中的玩具词表:每个候选有固定编号,其中还包括结束标记。
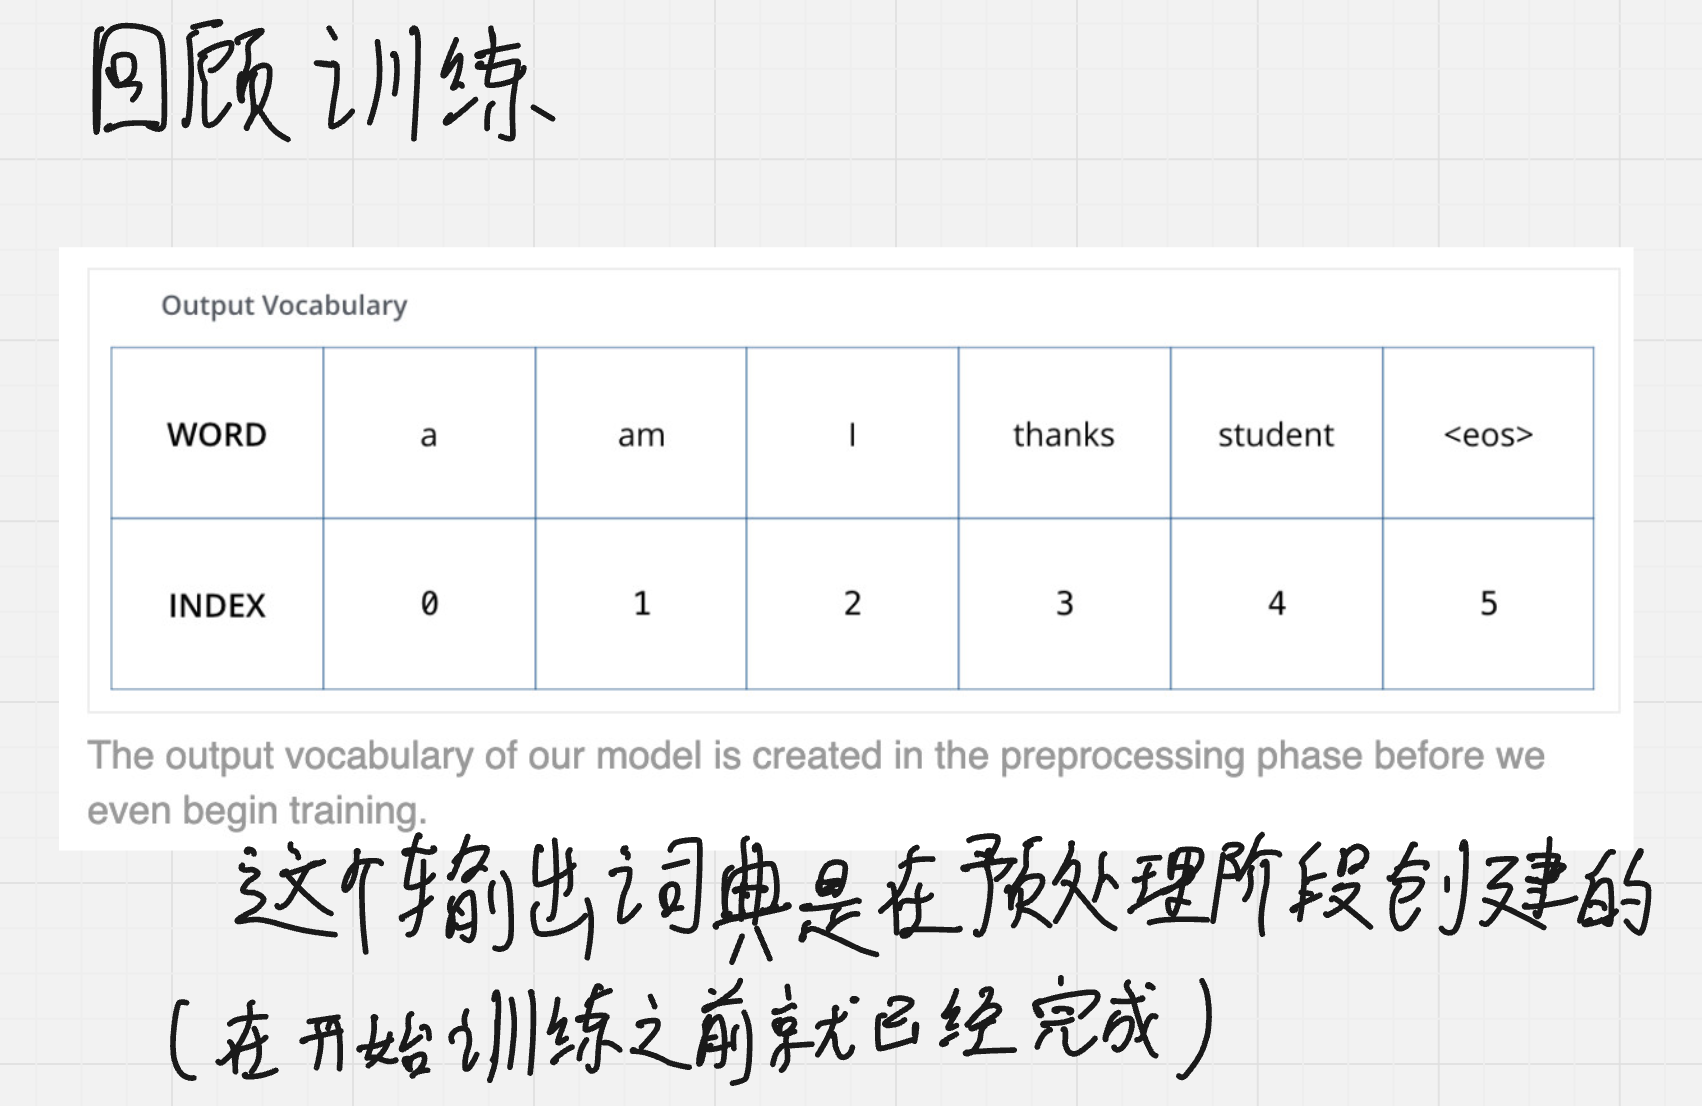
*图 32:包含 a、am、i、thanks、student 和结束标记的玩具词表。原始截图与手写批注。*
这里用小写 `i`,前面的示意译文用大写 `I`,它们服务于不同示例;真正实现时大小写与 token ID 的映射必须由同一个分词器和词表保持一致。词表在训练前确定,但词嵌入及其他模型参数会在训练中继续更新。
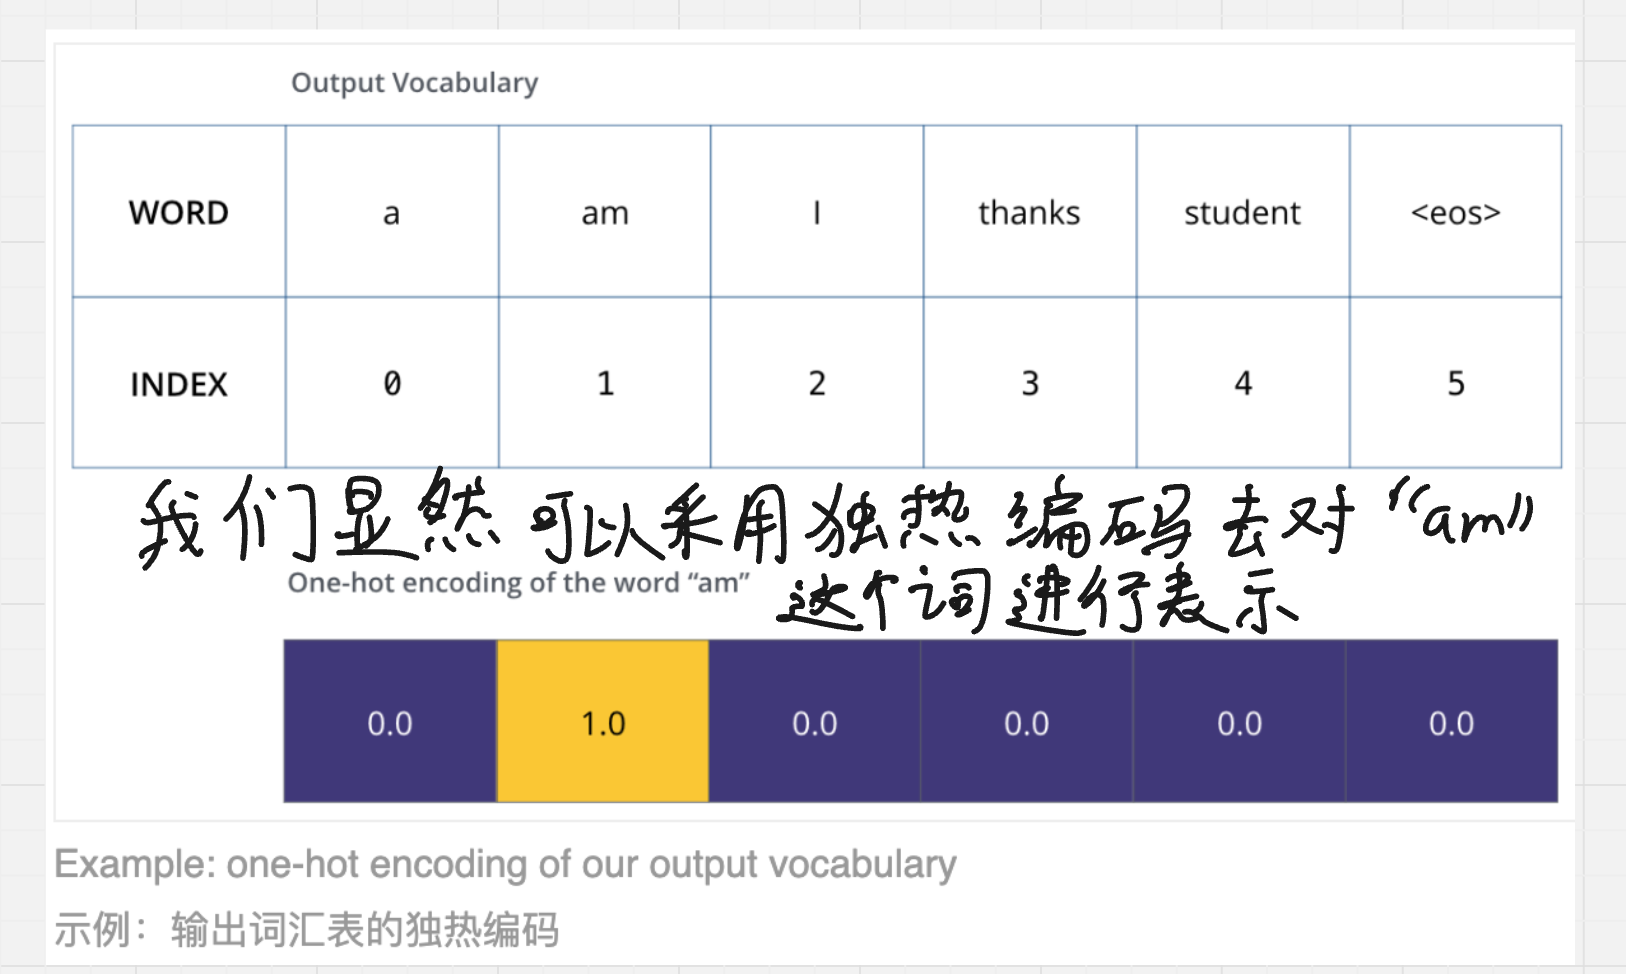
*图 33:将 am 的目标表示为 one-hot 向量。原始截图与手写批注。*
one-hot 向量只在正确 token 的编号处放 1,其他位置放 0。例如 `am` 的 ID 是 1,目标向量第二项就是 1。它表达“这次应该预测哪一个类别”,不是把模型输入的词嵌入也强制成 one-hot。实际训练通常直接存正确 token 的整数 ID,不必显式构造完整 one-hot 向量。
## 模型猜错以后,损失怎样衡量
假设这一步正确答案是 `thanks`,模型却把概率分散给了其他 token。我们希望一个损失值能体现:正确答案得到的概率越小,惩罚越大。
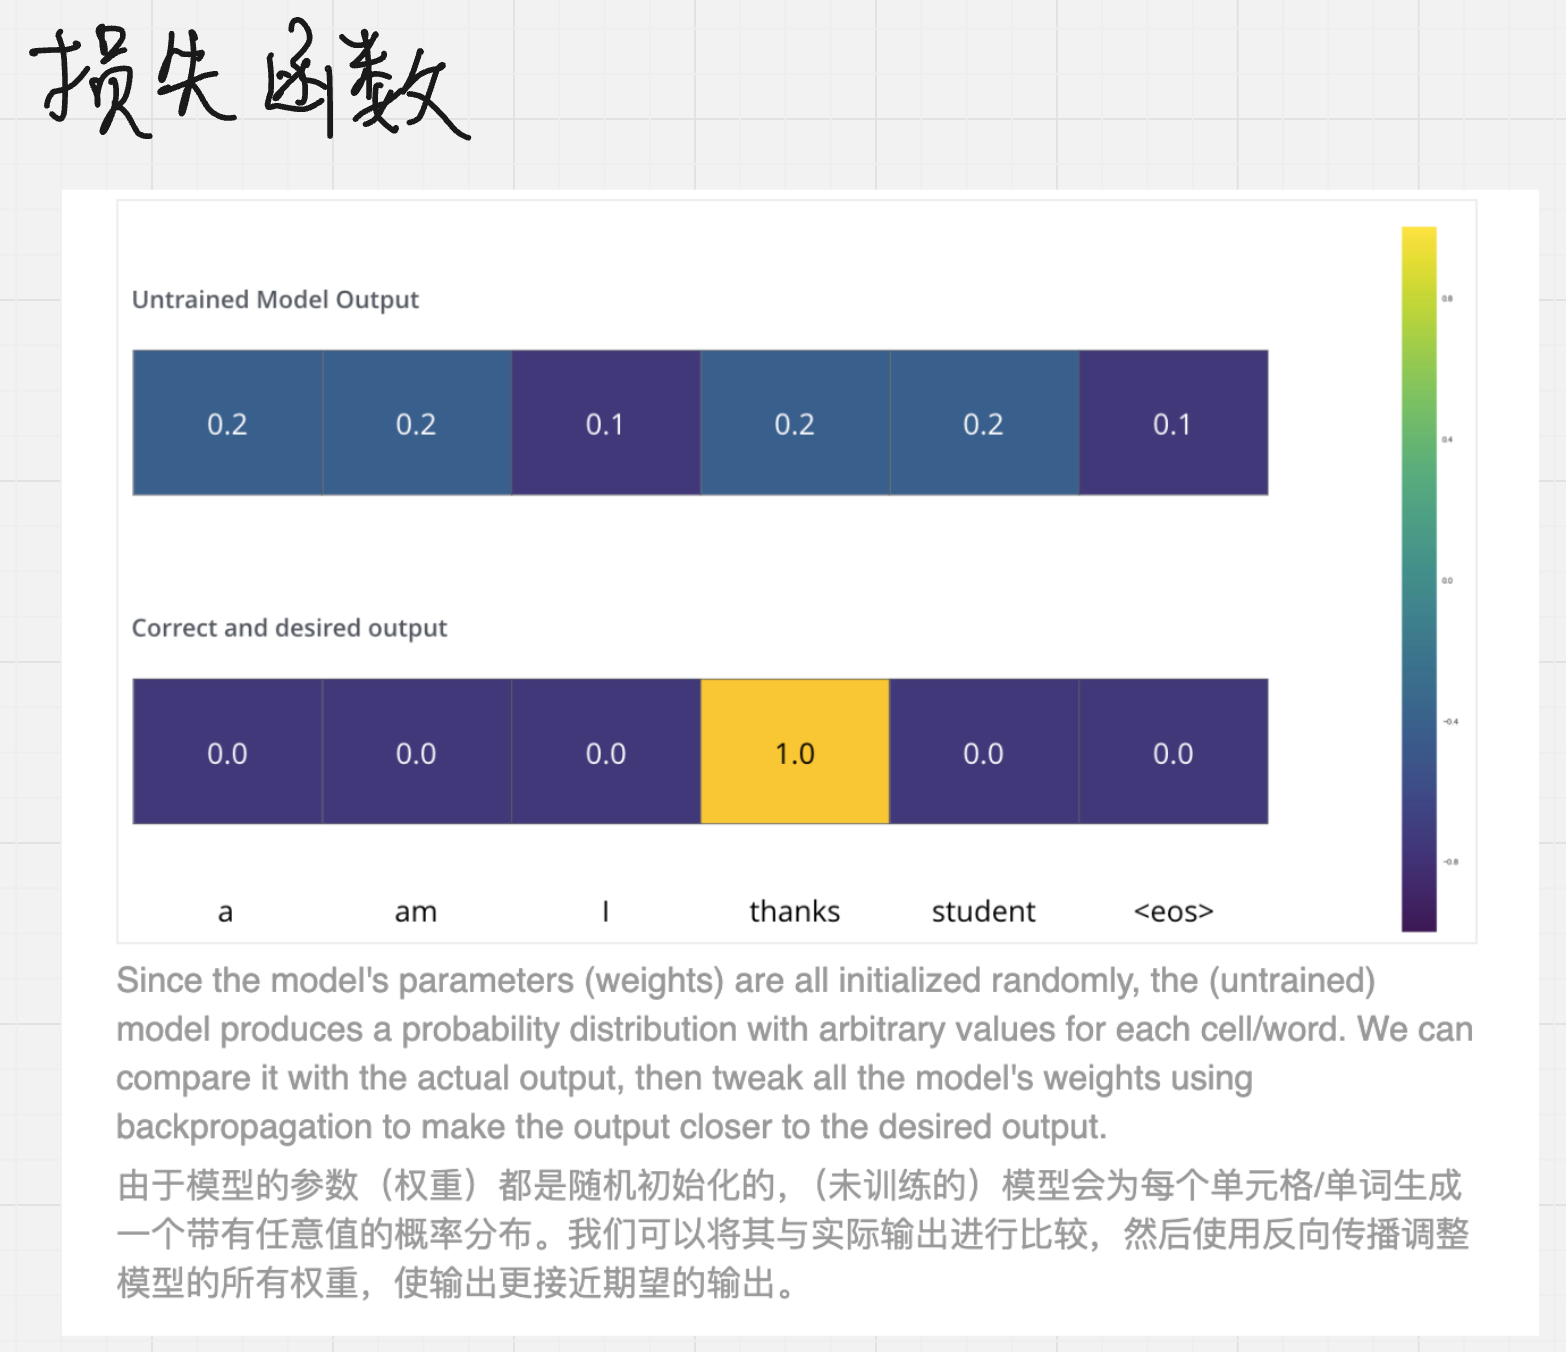
*图 34:模型预测分布与目标分布的对照。原始截图与手写批注。*
对普通 one-hot 标签,交叉熵会选出正确 token 对应的概率,取它的负对数。若该概率叫 $p_{correct}$,单步损失就是:
$$
L=-\log p_{correct}
$$
例如正确概率是 0.1 时,损失约为 2.303;提高到 0.8 时,损失降到约 0.223。整句话通常汇总各个非 padding 目标位置的损失,再通过反向传播更新模型参数。
截图原文把比较两个分布简化成“相减”,这里需要分清:**交叉熵的数值不是两个分布直接相减**。对 softmax 与交叉熵的组合,损失对 logits 的梯度会出现“预测概率减目标概率”的形式;那是求导的结果,不是损失本身的定义。原论文训练还使用了 label smoothing,因此实际监督目标也不总是严格的 one-hot。
## 有完整答案,训练能不能一次算多个位置
可以。训练时知道正确目标序列,把它向右移动一位作为解码器输入,这通常称为 teacher forcing。对应图中 `i am a student` 的玩具例子:
| 解码器输入当前位置的 token | 要预测的目标 token |
|---|---|
| 开始标记 | i |
| i | am |
| am | a |
| a | student |
| student | 结束标记 |
有了因果遮罩,即使这些位置一起计算,每个位置仍只能使用相应的正确前缀,不会看到后面的答案。因此训练可以并行计算多个目标位置;推理时下一 token 还没确定,必须逐步生成。两者的差别是前缀来自正确答案还是先前生成的结果。
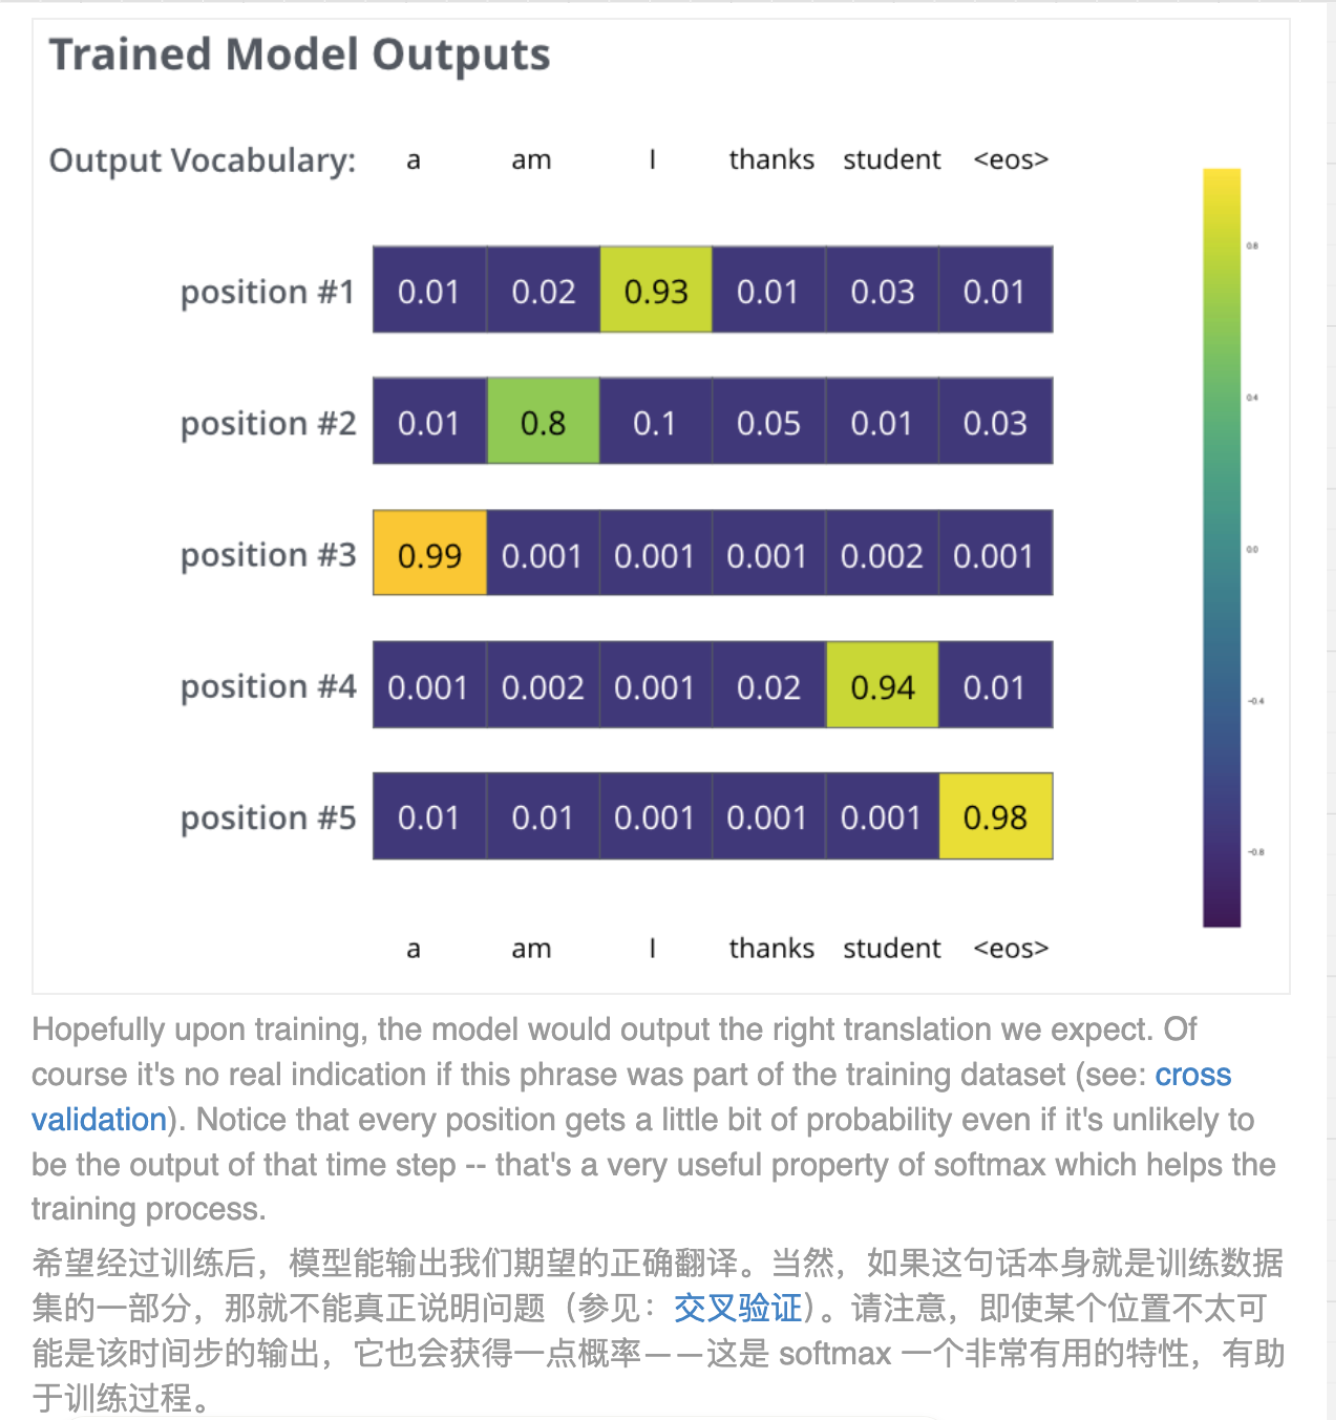
*图 35:训练后,各目标位置分别输出一份词表概率分布。原始截图与手写批注。*
这张图每一行对应一个目标位置,每一列对应词表中的一个 token。它和注意力热力图外形相似,含义却不同:注意力图回答“参考哪个位置”,这里回答“下一个 token 是词表里的哪一项”。输出高概率的目标序列还不足以证明模型能泛化,要在没有参与训练的样本上检验。
## 把三篇笔记接起来
现在可以沿着一句话完整走一遍:词嵌入与位置编码提供输入表示,编码器用自注意力交换信息,用 FFN 加工各位置;解码器在因果限制下处理目标前缀,再通过交叉注意力读取源句,最后输出下一 token 的概率。生成时选择一个 token 接回前缀;训练时用正确 token 计算损失,反向传播修改参数。
读图时始终问两个问题就不容易迷路:**这个向量现在属于哪个位置?这次 softmax 是在给位置分配权重,还是在给词表分配概率?** 这两个问题能把结构图、注意力公式和训练目标真正接起来。
主要参考:[Jay Alammar — The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/)。原始架构、训练细节与标签平滑可对照 [Attention Is All You Need](https://arxiv.org/abs/1706.03762)。