手算自注意力:Q、K、V 与多头矩阵计算 · znzryb
> 本篇结合手写批注,重新讲解 Jay Alammar 的 [The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/) 中的注意力部分。原文图示及本篇相应改编沿用 [CC BY-NC-SA 4.0](https://creativecommons.org/licenses/by-nc-sa/4.0/)。截图完整保留,公式与易误解之处在正文说明。
## 先看总图:打分、分配权重、提取内容
自注意力的输出仍是一组向量。它为每个位置分别计算:应该从当前序列的各个位置取来多少信息?下面的总图把完整矩阵计算串在一起,先看箭头,稍后再看下标。
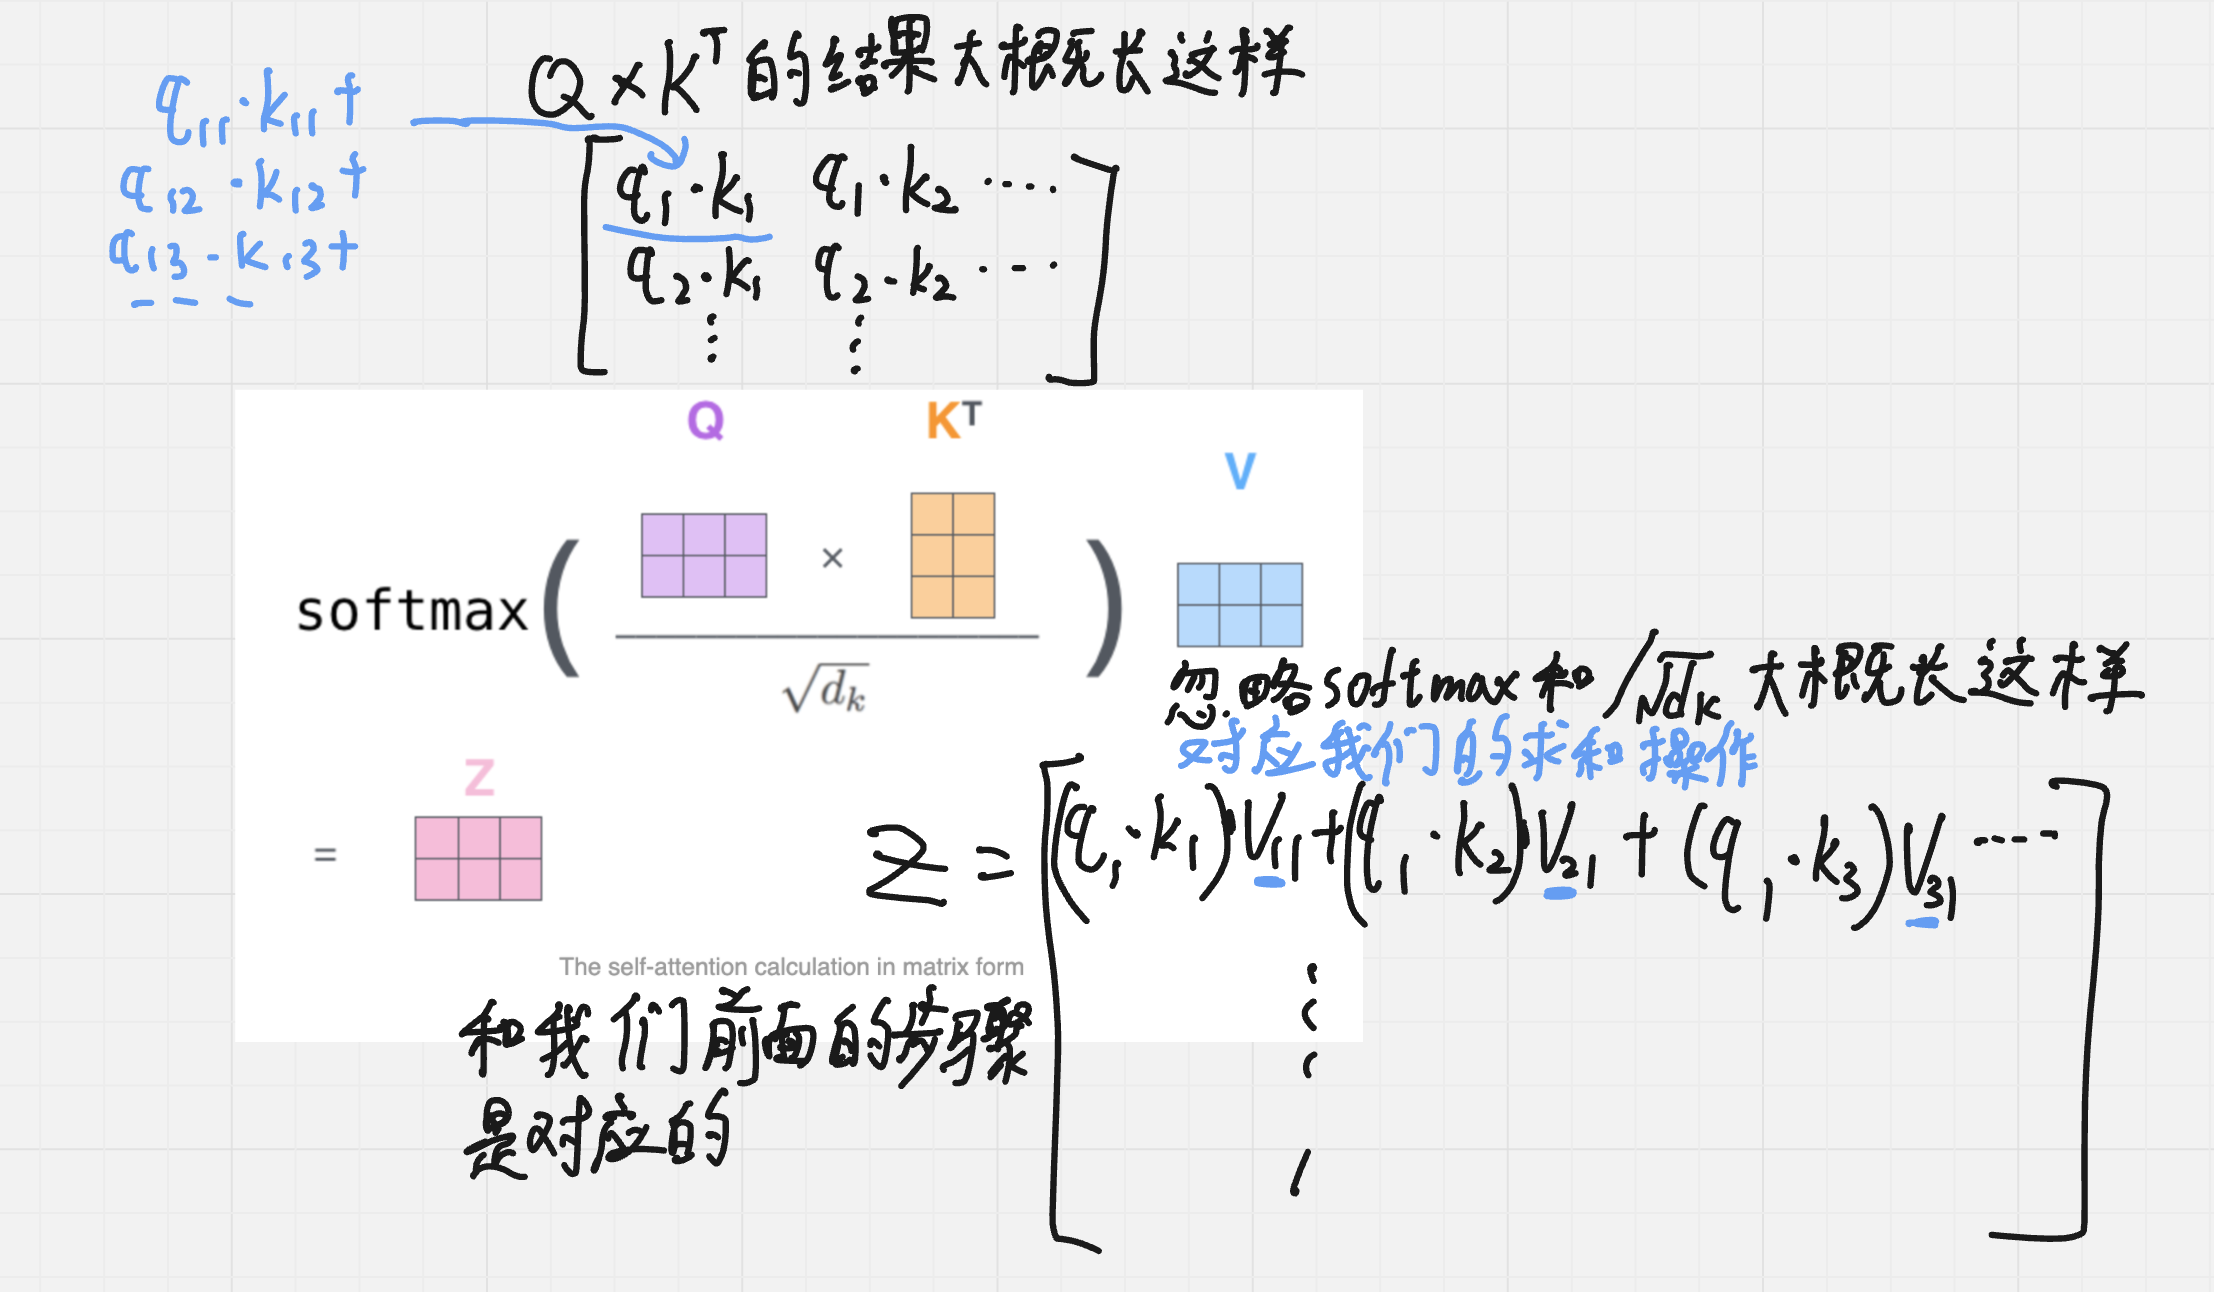
*图 16:QK 转置得到分数,再用注意力权重汇总 V。原始截图与手写批注。*
这里有两类矩阵,不能混为一谈:$QK^T$ 产生的是位置与位置之间的分数;最后的输出则是每个位置更新后的特征向量。注意力图里的一个格子,通常表示“某个查询位置看某个被参考位置的权重”。
## 为什么一个词的表示需要看其他词
截图里的英文句子说:动物因为太累而没有过街。单看 `it` 的词嵌入,不能知道它在这句话里指谁;结合上下文,它才可能把动物的信息带进来。
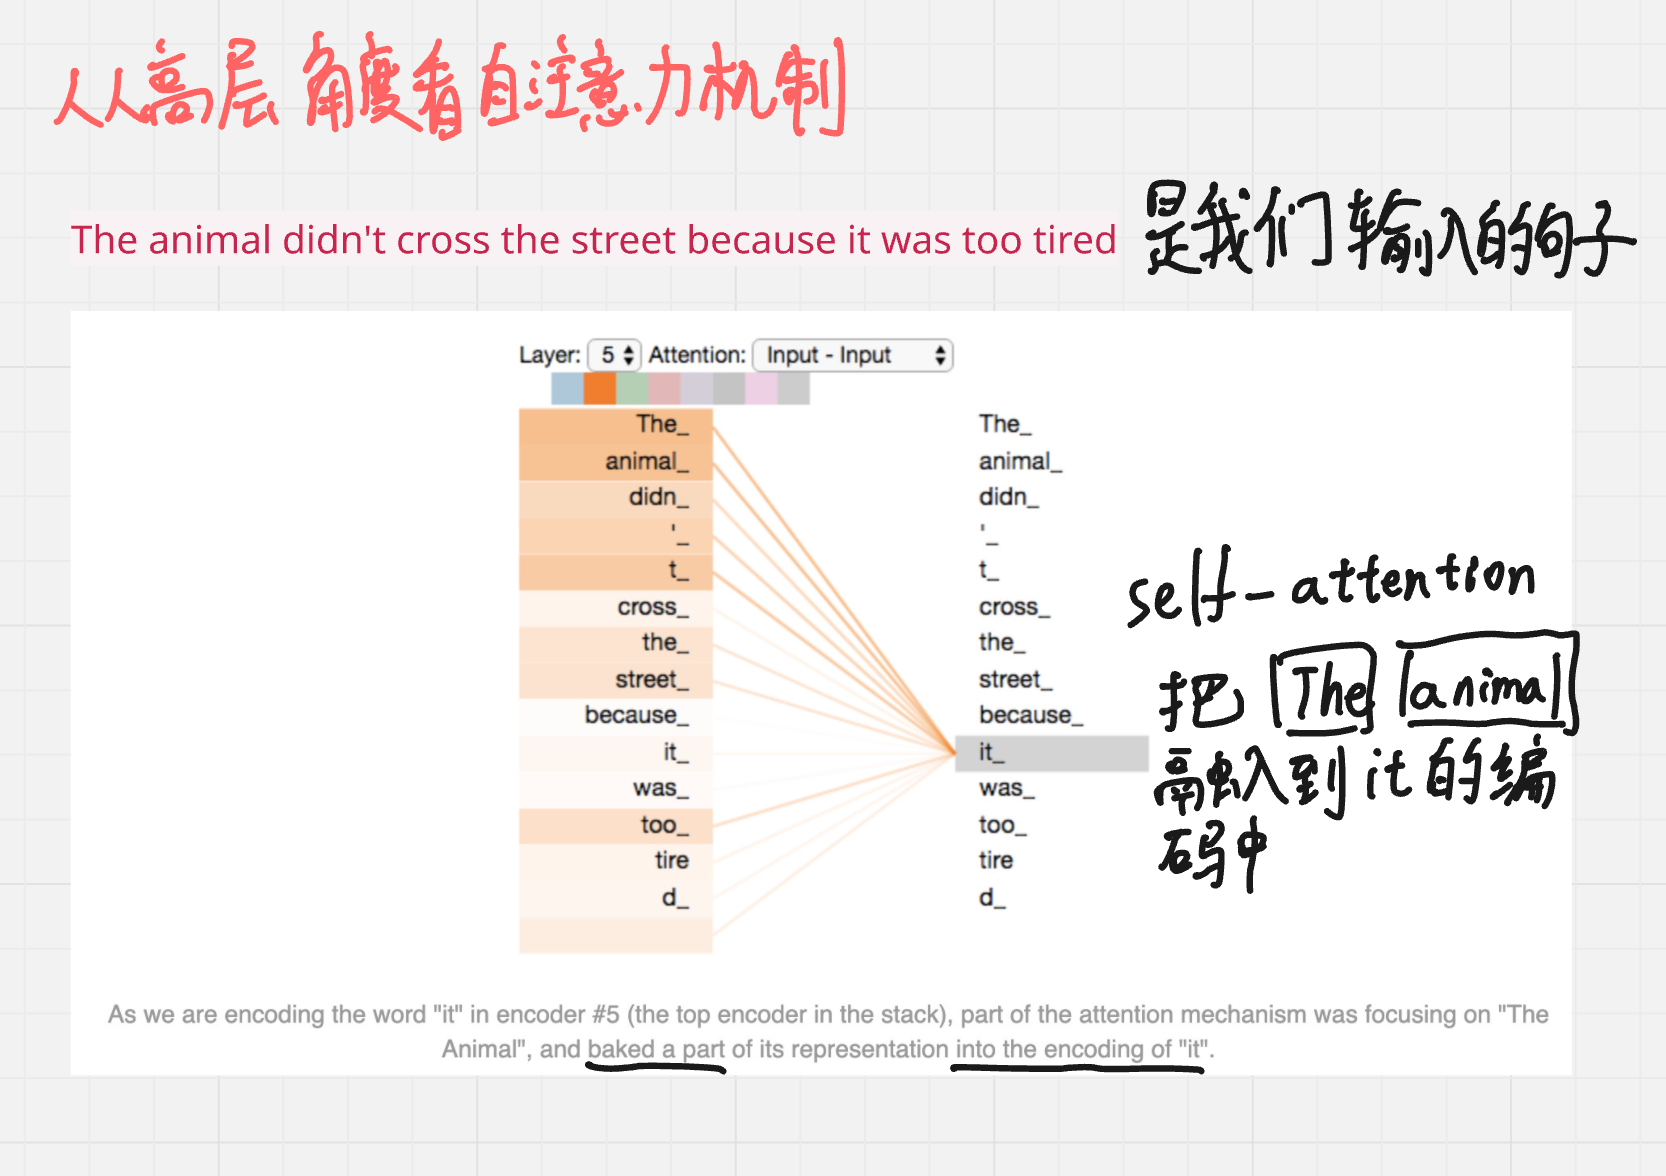
*图 17:处理 it 时,对 animal 等位置分配注意力。原始截图与手写批注。*
自注意力允许当前 token 与整句中其他 token 直接建立联系。这里的“self”说的是 Q、K、V 来自同一组输入表示;并不是“只能关注自己”。也没有规则保证自己的权重一定最大。
## 同一个输入,为什么要分成 Q、K、V
对当前层的每个位置向量,做三次不同的可学习线性变换,得到三种角色:Query 用于发起匹配,Key 用于参与匹配,Value 提供真正被汇总的内容。
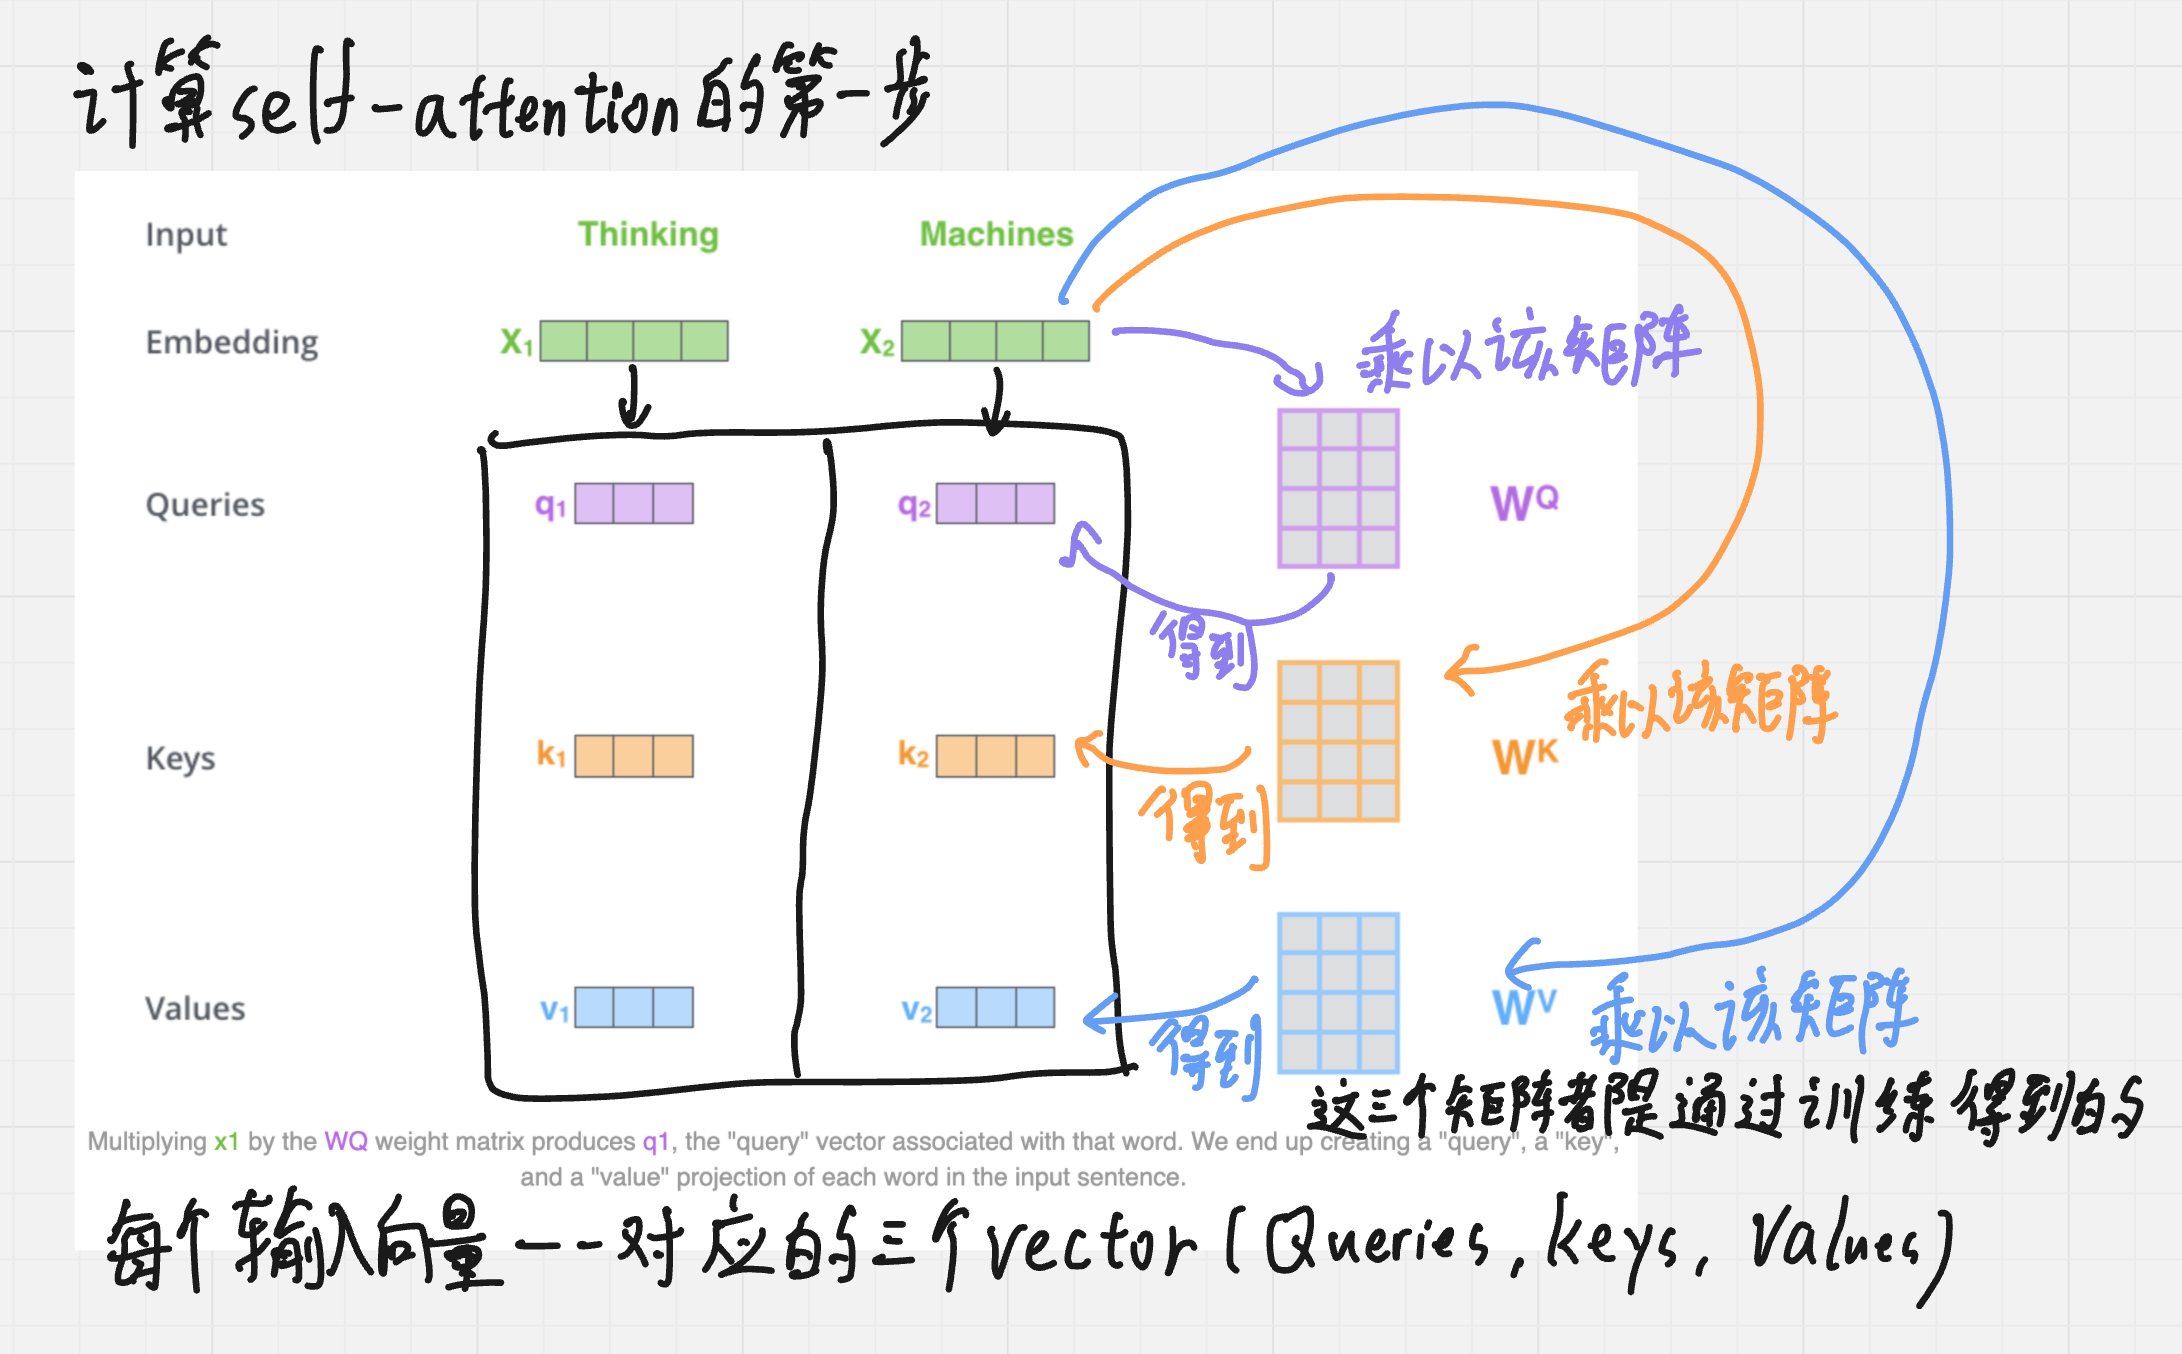
*图 18:每个输入向量分别投影成 Q、K、V。原始截图与手写批注。*
这三组投影权重是训练参数,同一层、同一头内跨位置共享。不是每个单词额外训练自己的一套投影矩阵;变的是位置上的输入,所以各位置投影后的 Q/K/V 也会不同。
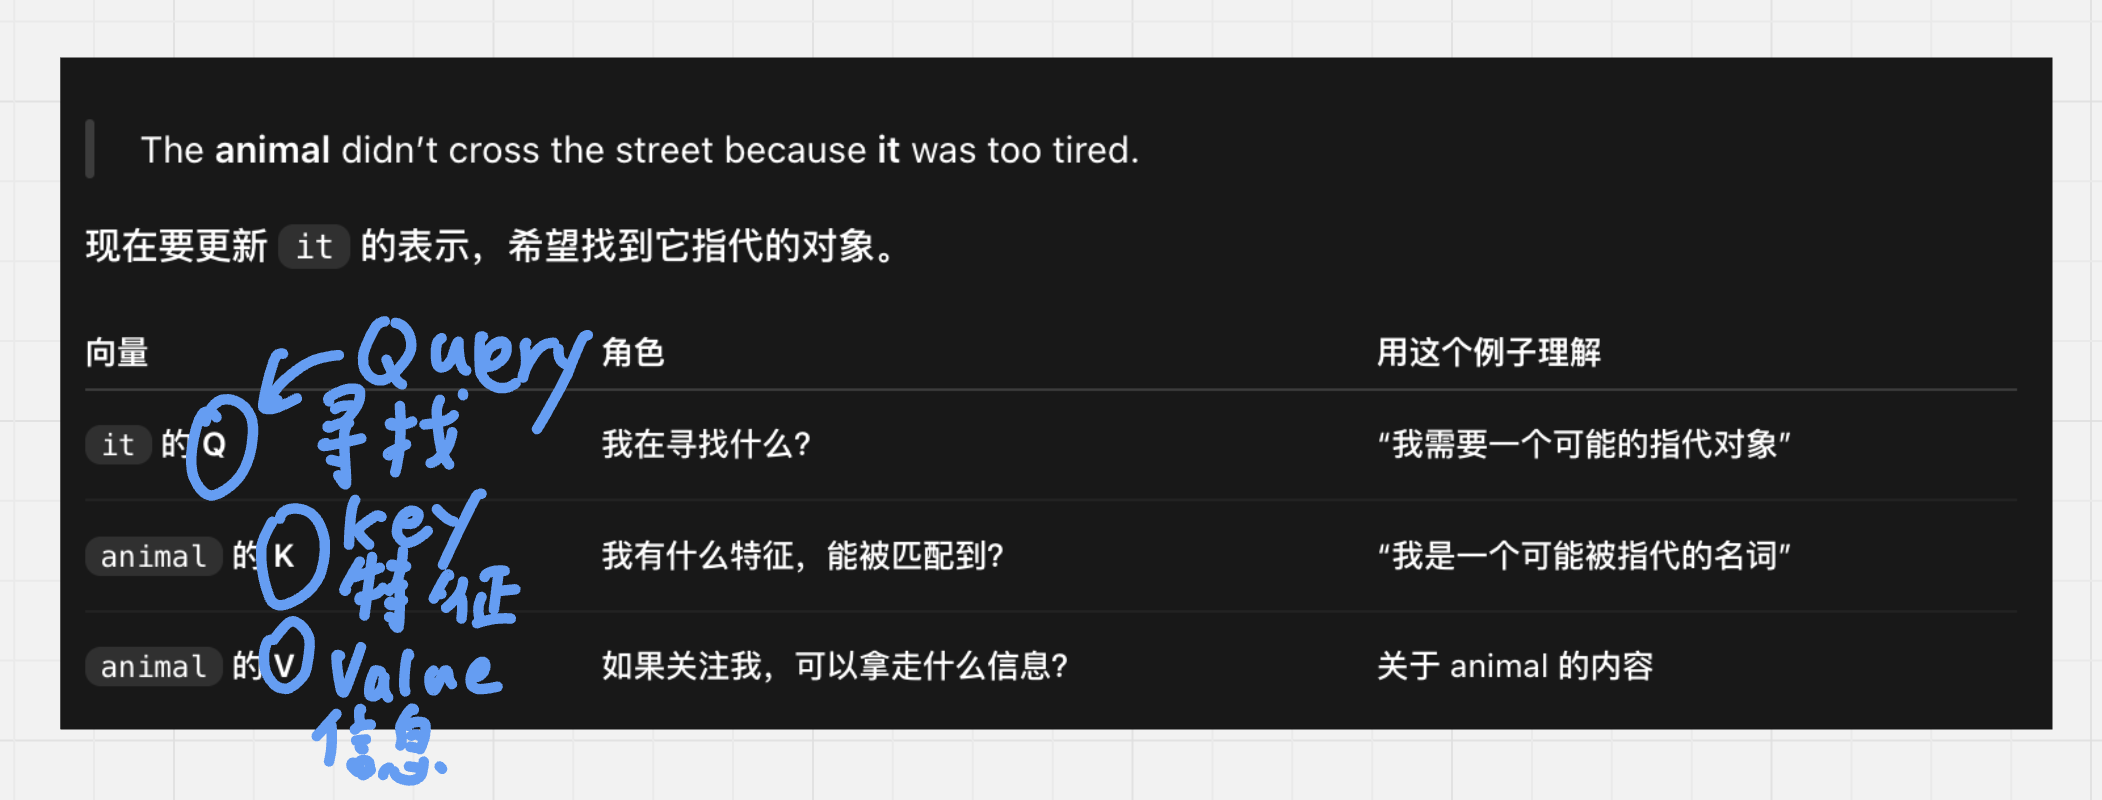
*图 19:用寻找指代对象的例子区分 Query、Key、Value。原始截图与手写批注。*
截图中的比喻很适合入门:Q 像“我正在找什么”,K 像“我有什么可匹配的特征”,V 像“关注我以后可以取走什么”。但这些并不是人工写进模型的自然语言标签。网络学到的是连续向量,某个头也不保证专门负责语法或指代。
## 固定一个查询位置,先和所有 Key 比较
现在跟着 `Thinking Machines` 这个两位置例子算一遍。要更新第一个位置,固定它的 $q_1$,分别与 $k_1$、$k_2$ 做点积。
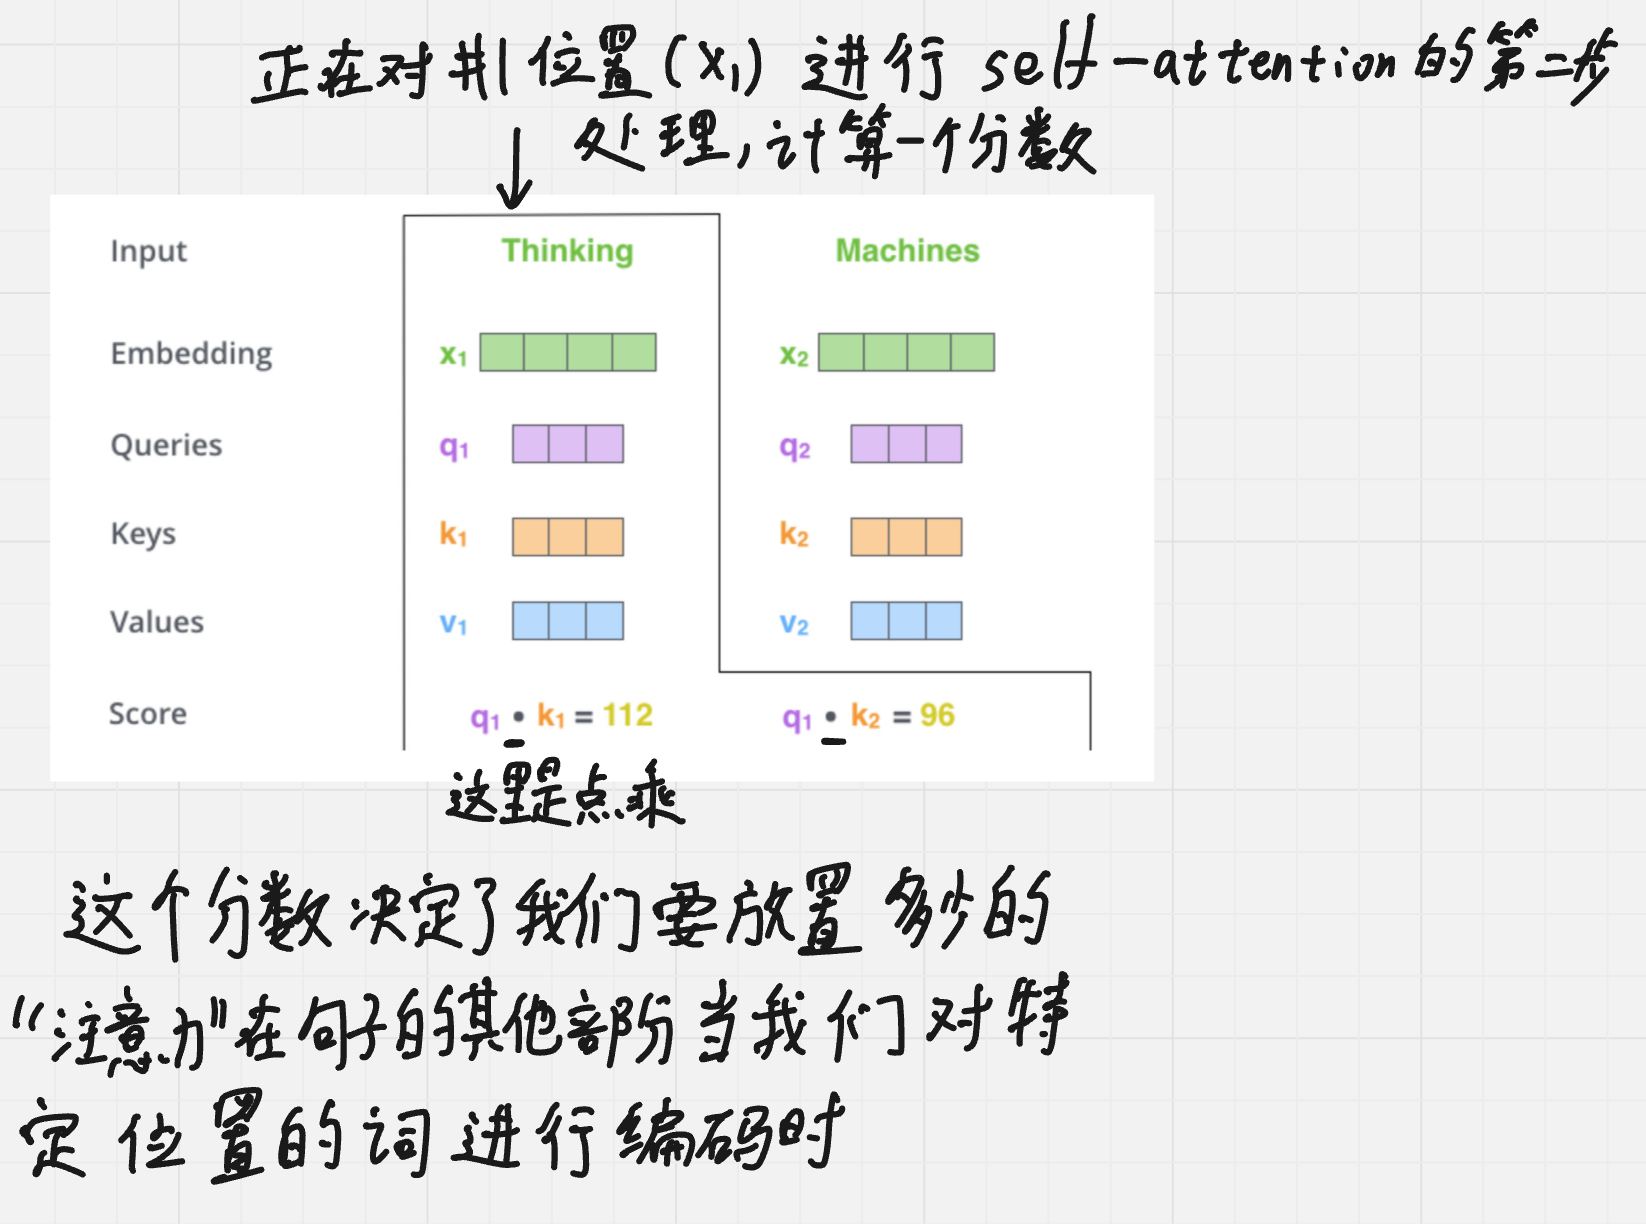
*图 20:固定 q1,分别和两个位置的 Key 计算匹配分数。原始截图与手写批注。*
一次点积得到一个数,作为匹配分数。这不是直接把两个原始词向量比较,也不是把 Q 和 V 相乘。Q、K 已经分别通过了各自的可学习投影。
## 为什么分数先除以 8,再做 softmax
示例中两个点积是 112 和 96。它们还不是“88% 和 12%”,更不是概率;需要先缩放,再把它们转成总和为 1 的权重。
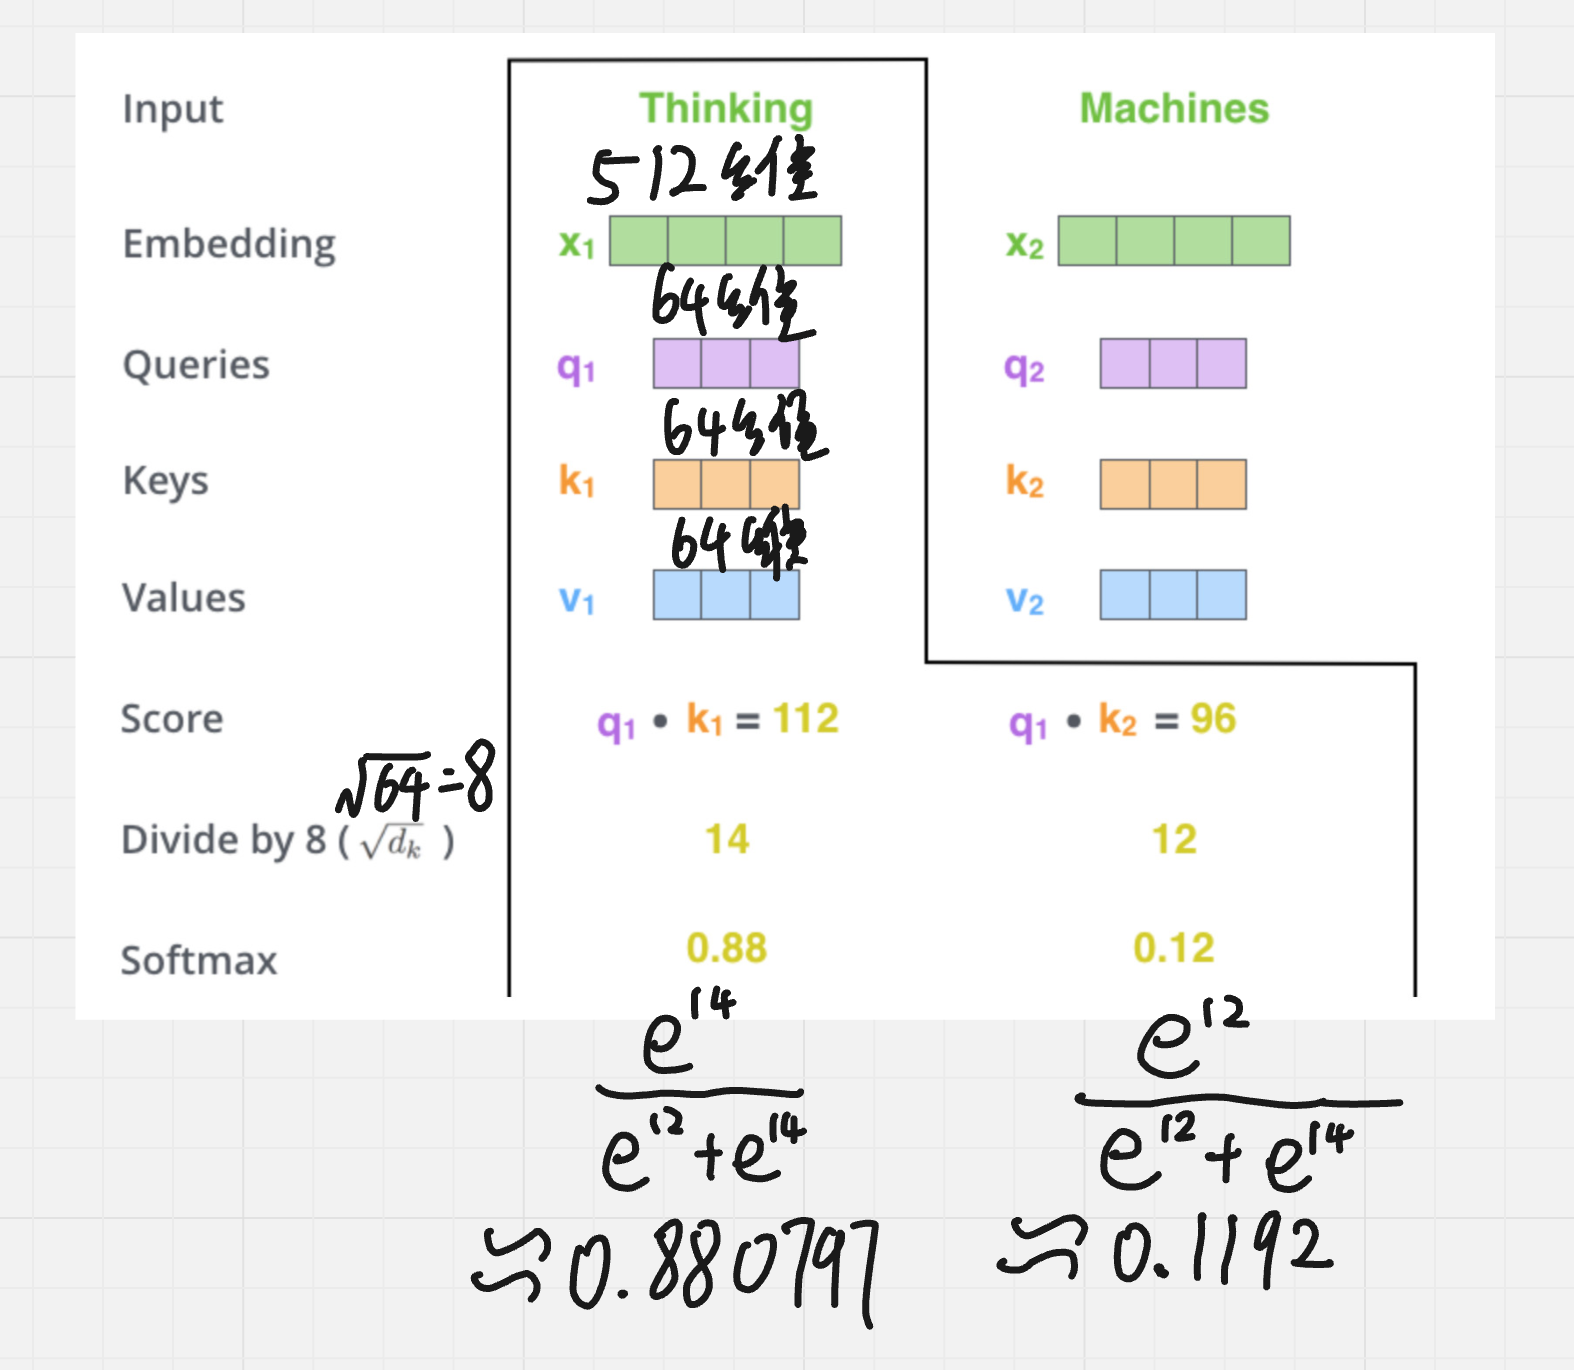
*图 21:112、96 经缩放与 softmax 变成约 0.88、0.12。原始截图与手写批注。*
这里单头的 Key 维数是 64,所以缩放因子是 $\sqrt{64}=8$。除完以后得到 14 和 12,再对这两个数做 softmax。计算第一个权重,就是把 $e^{14}$ 除以两项指数的总和:
$$
\alpha_{11}=\frac{e^{14}}{e^{14}+e^{12}}\approx0.8808,
\qquad
\alpha_{12}\approx0.1192
$$
为什么要缩放?维度增大时,点积的数值波动往往随之增大,softmax 就可能很快把权重挤得过于极端,导致梯度变小。除以 $\sqrt{d_k}$ 用于控制这个尺度;不是因为 8 是某个固定的经验魔法数。
实际计算 softmax 时,通常先把每项减去这一行的最大值。例如把 14、12 改成 0、−2,结果不变,但更不容易出现指数溢出。
## 分完权重以后,取的是 Value
权重决定比例,被拿来混合的内容来自 Value。对于第一个查询,分别给 $v_1$、$v_2$ 乘上刚算出来的比例,再相加。
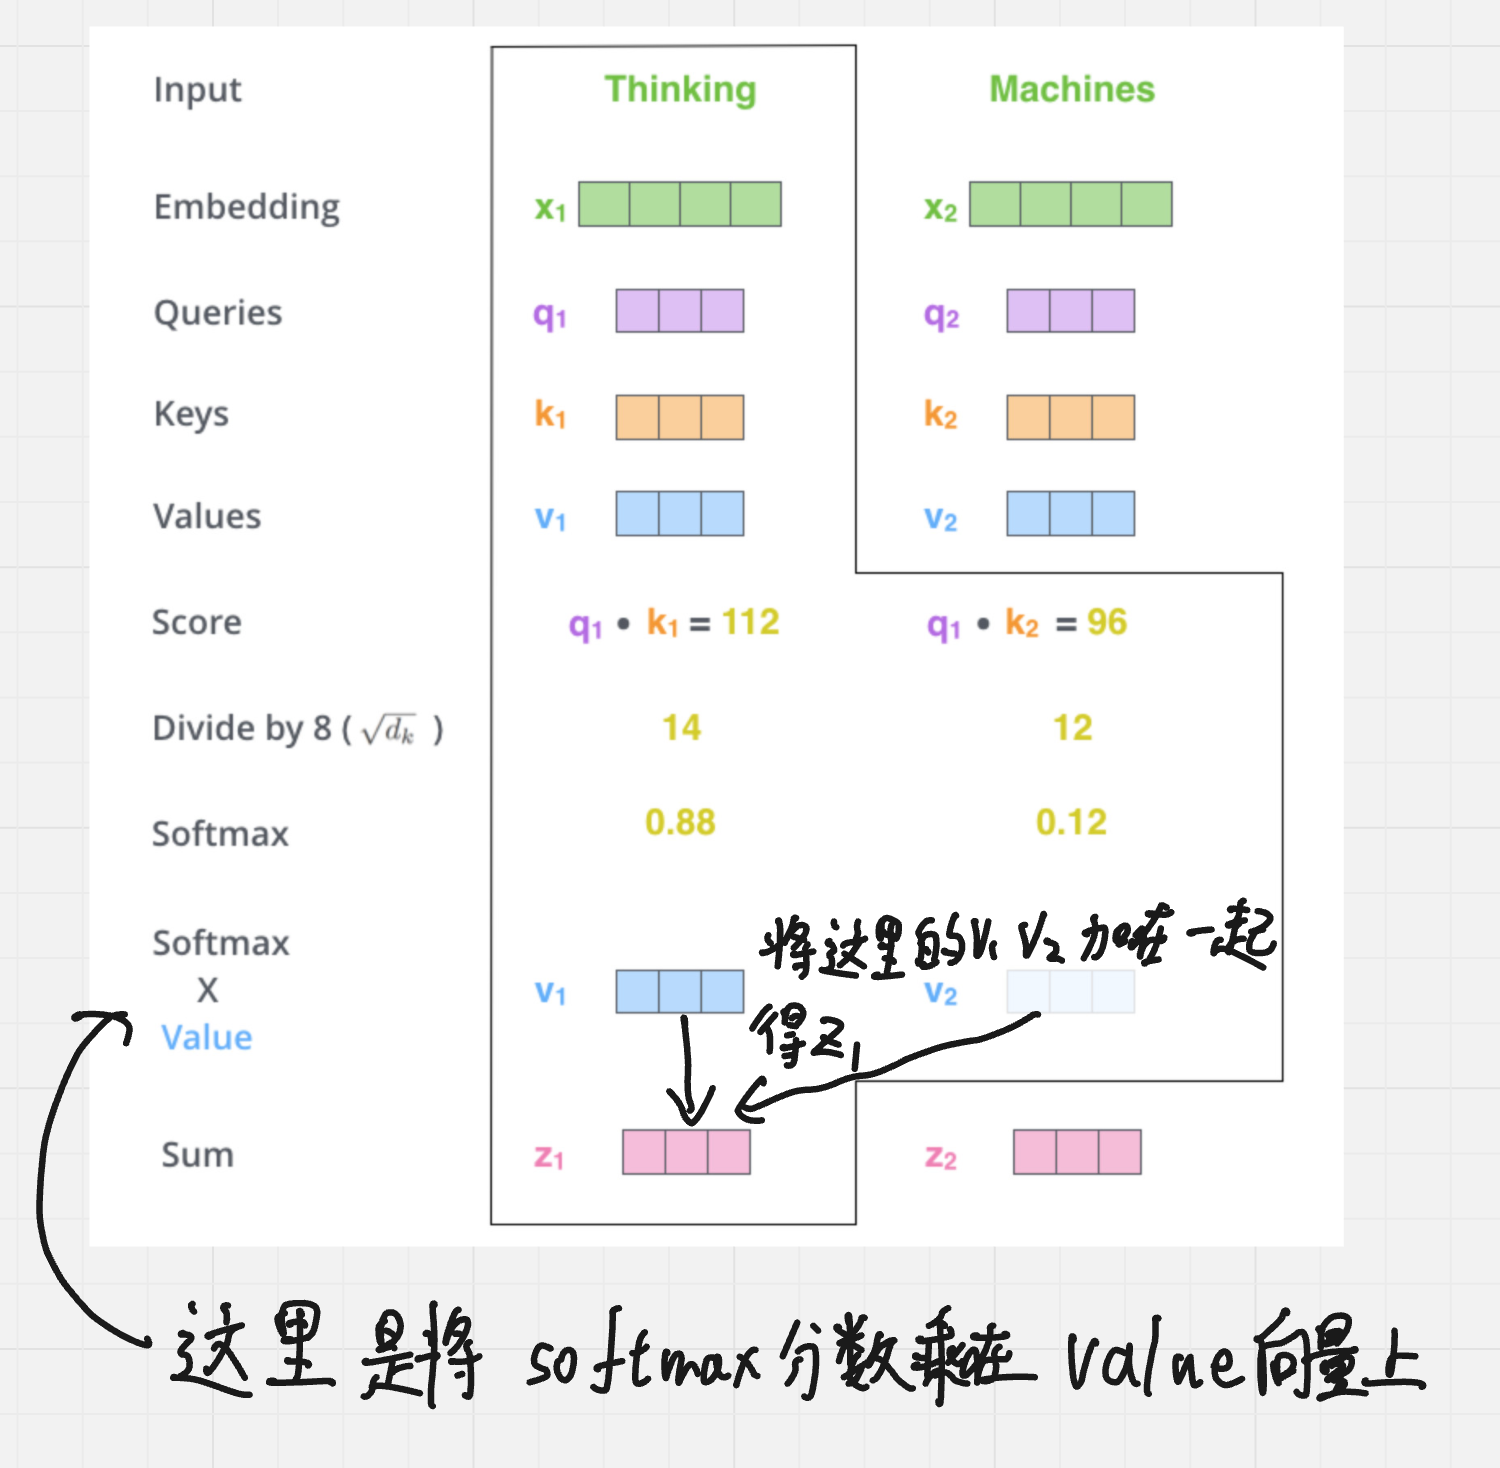
*图 22:将约 0.88 倍的 v1 与 0.12 倍的 v2 相加得到 z1。原始截图与手写批注。*
因此第一个输出向量可近似写成:
$$
z_1=0.8808v_1+0.1192v_2
$$
这里是同一维度逐项加权求和,不是把 $v_1$ 和 $v_2$ 接成长向量。更新第二个位置时,换成 $q_2$ 再算一行权重,得到 $z_2$。两个位置看到的是同一批 K/V,但它们提出的查询不同,所以取得的信息比例也可以不同。
## 把每个位置一起装进矩阵
逐个位置算清楚以后,就能把同样的事情批量做。令输入矩阵 $X$ 每行对应一个位置;分别乘三组权重,得到 Q、K、V。
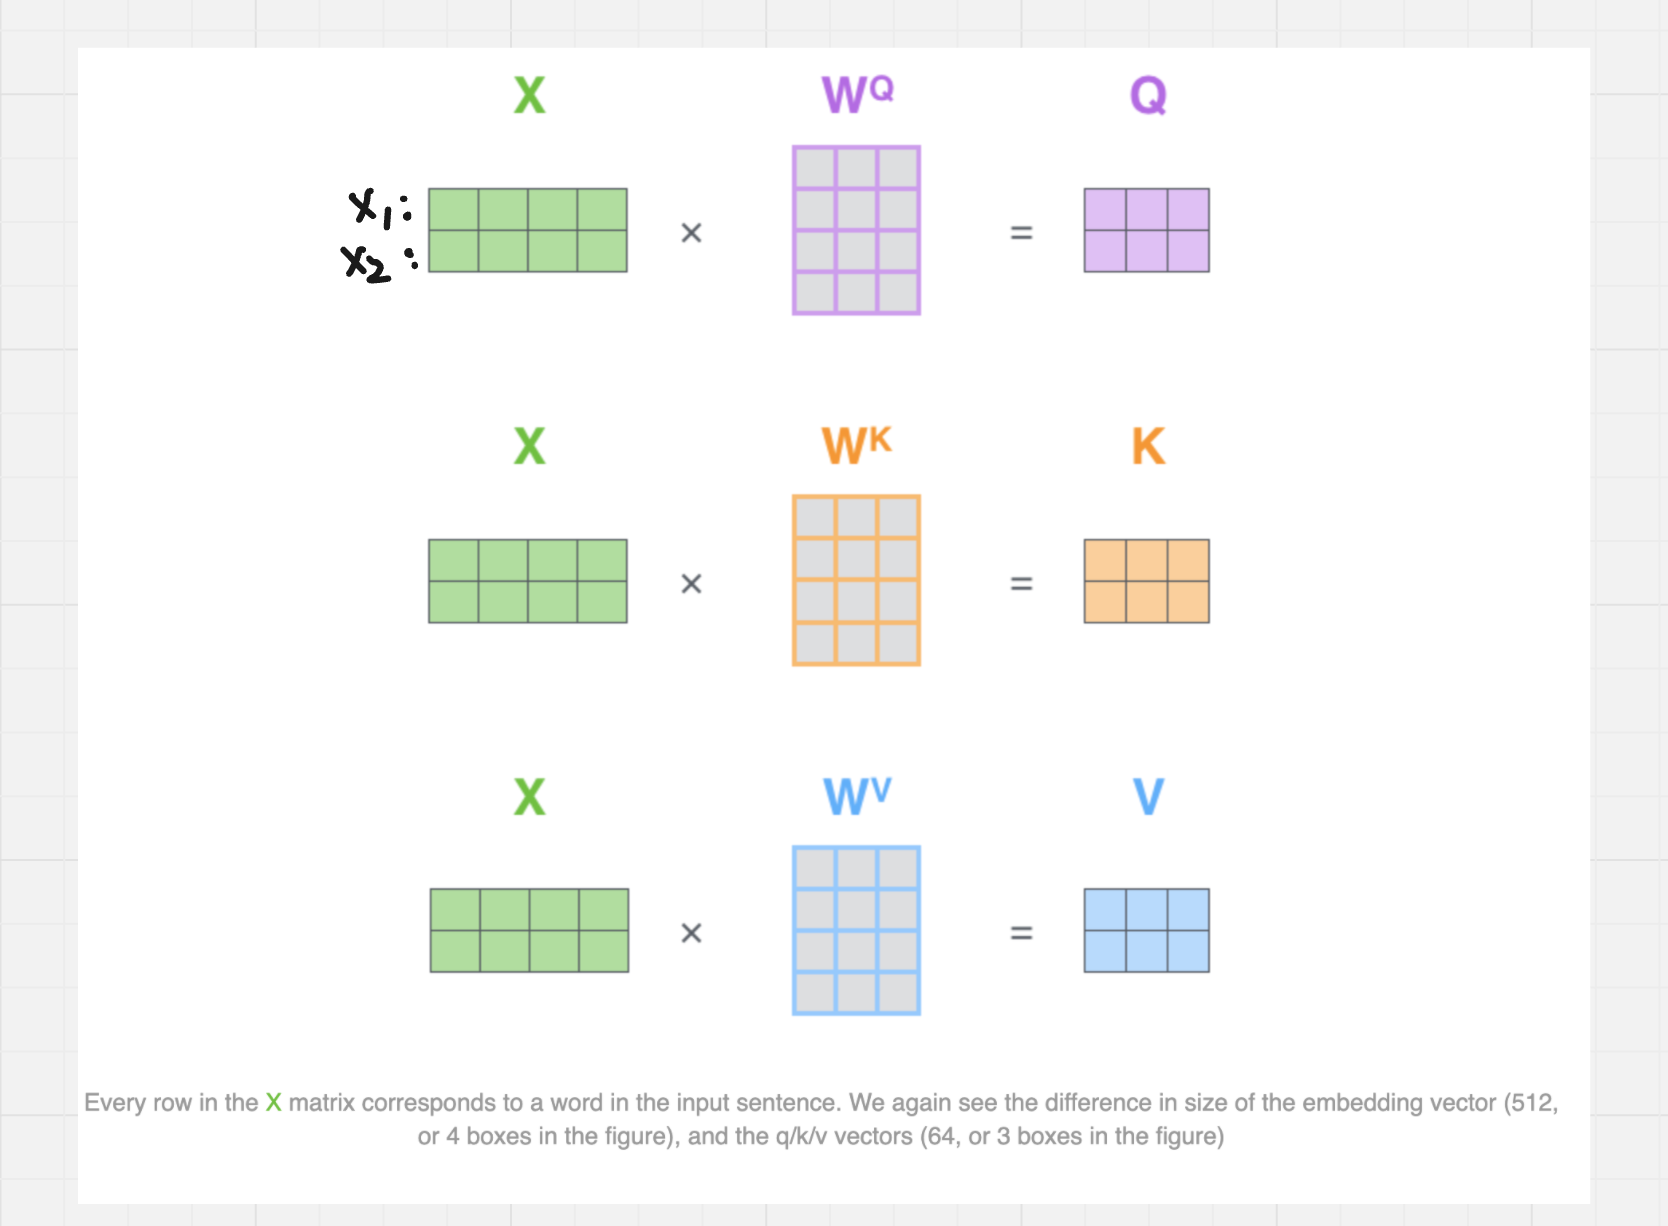
*图 23:用三次矩阵乘法同时生成所有位置的 Q、K、V。原始截图与手写批注。*
以 $n$ 个位置为例,$X$ 是 $n\times d_{model}$,投影后的 Q 和 K 都是 $n\times d_k$,V 是 $n\times d_v$。转置 K 后,$QK^T$ 就是 $n\times n$:第 $i$ 行第 $j$ 列,表示查询位置 $i$ 与参考位置 $j$ 的分数。
对每一行分别缩放、做 softmax,得到权重矩阵,再右乘 V。这样一行的全部加权求和会被一次矩阵乘法完成。用公式把这个过程记下来:
$$
\operatorname{Attention}(Q,K,V)
=\operatorname{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V
$$
softmax 沿每行的 Key 方向做归一化。无注意力 dropout 时,每行权重总和为 1;输出形状是 $n\times d_v$。如果把 softmax 对整张矩阵一起算,或者把行列方向弄反,就不是上述机制了。
## 一个头不够,就让多组投影分别看
同一个位置可能同时需要多种上下文关系。一组权重只能提供一种加权混合;多头注意力让不同投影各自得到一组 Q/K/V,分别计算注意力。
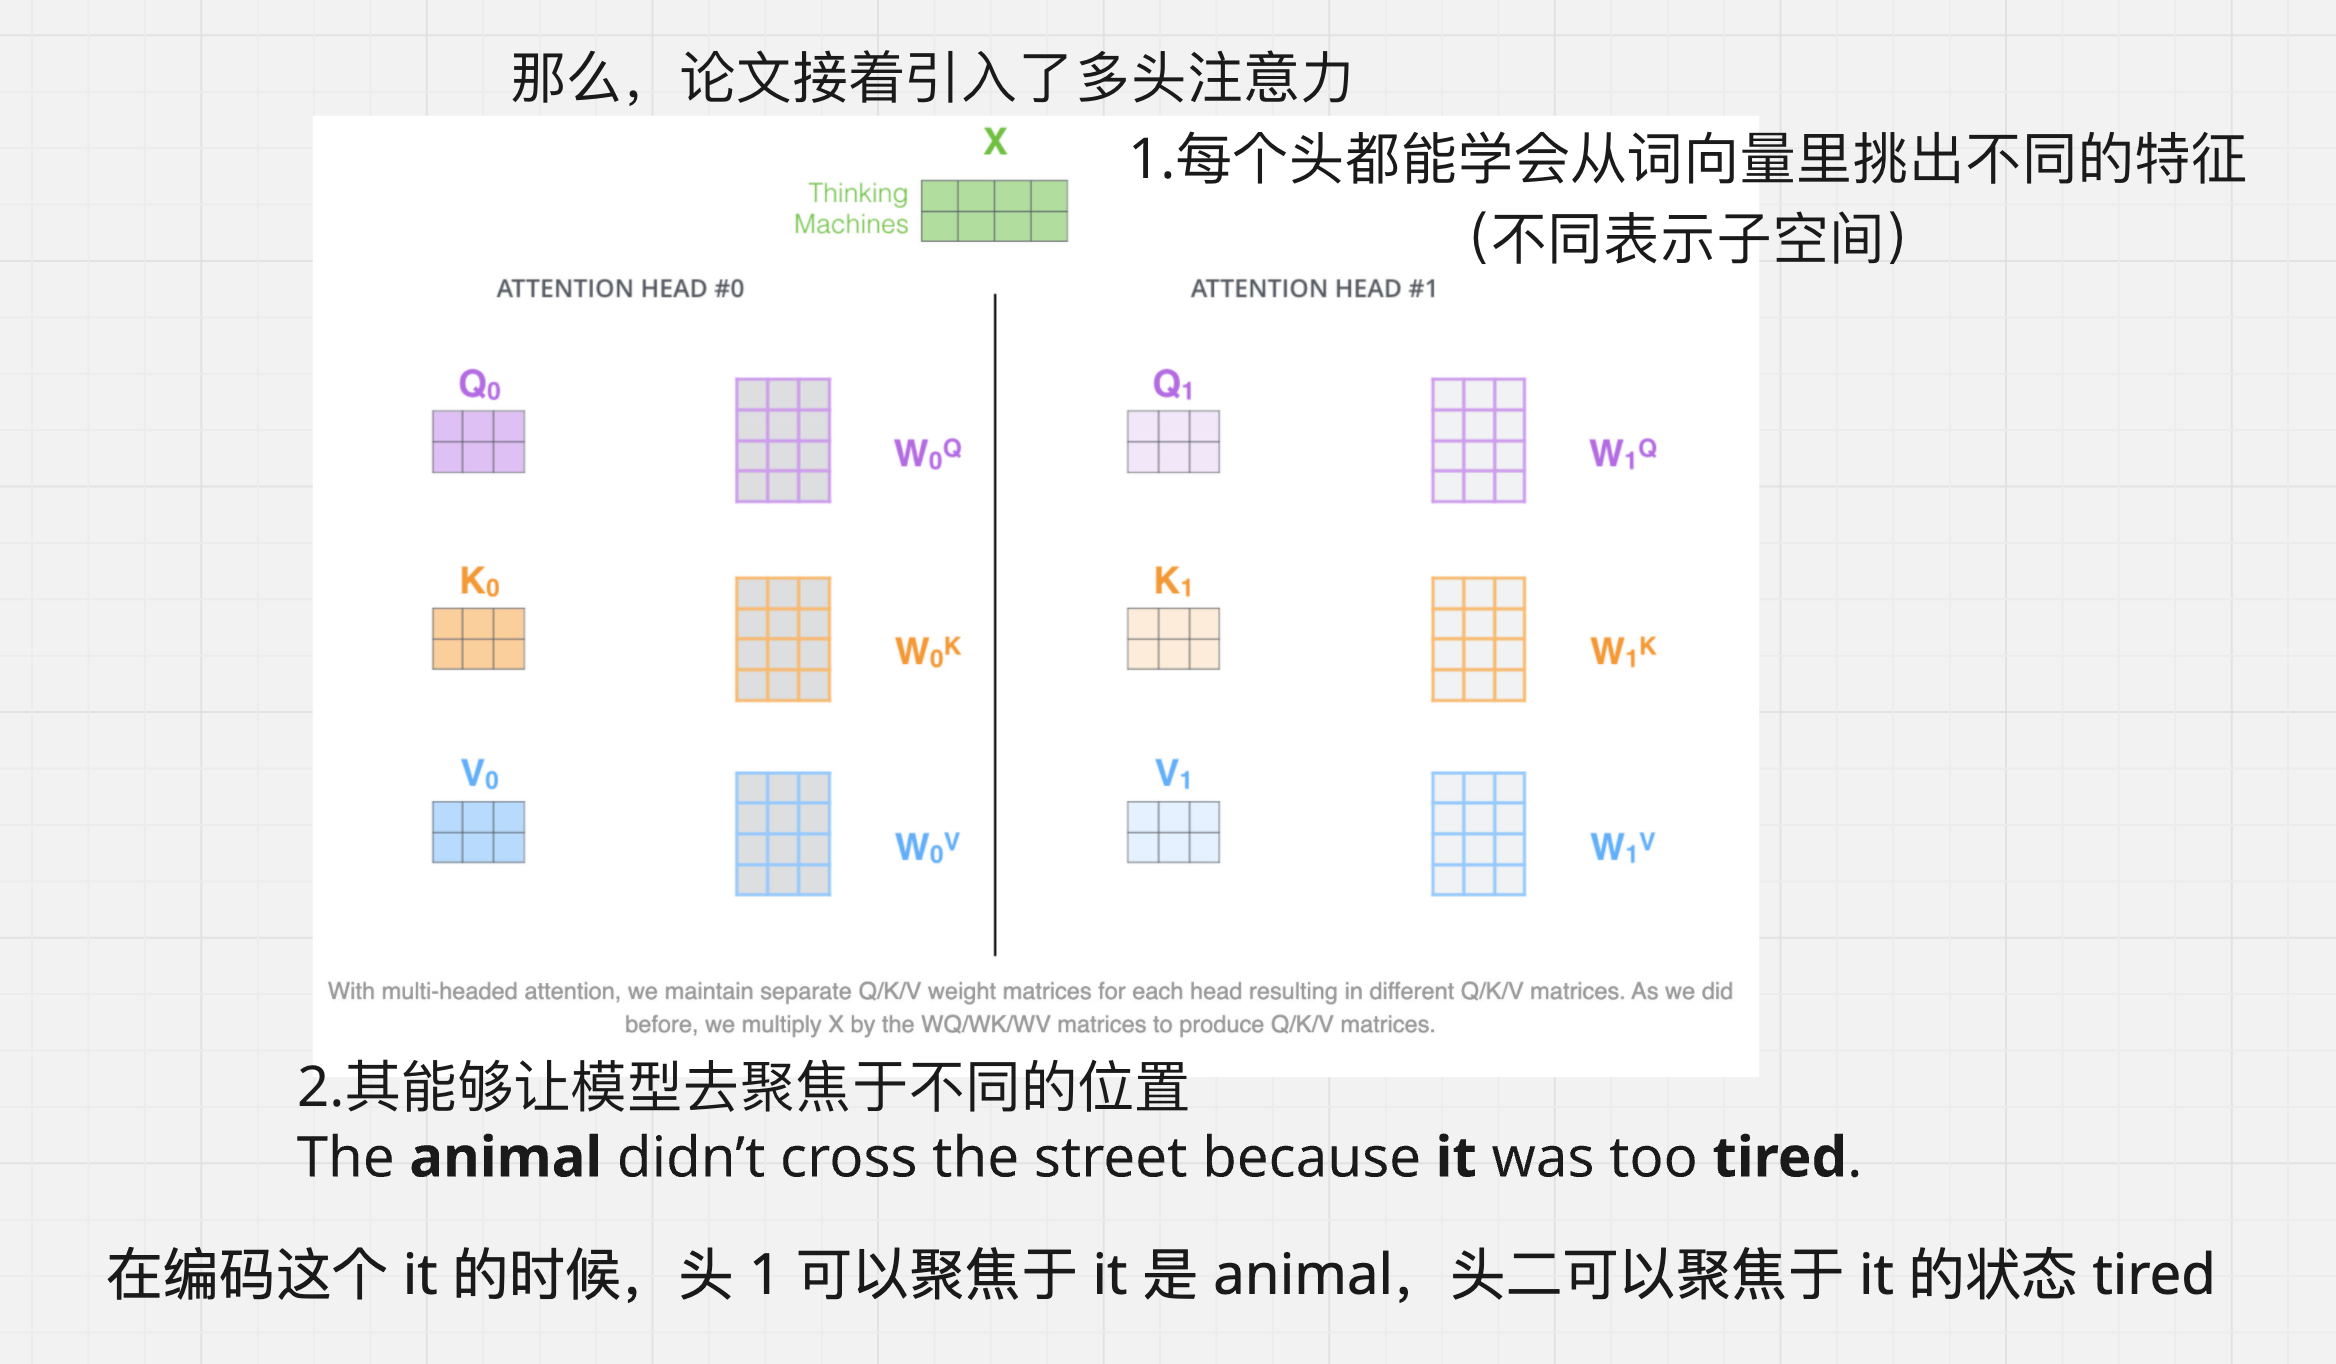
*图 24:不同注意力头拥有不同的 Q、K、V 投影。原始截图与手写批注。*
不是把同一组 Q/K/V 原样复制八遍,而是同一个输入进入八套不同的投影。原始 base 配置中,每头 $d_k=d_v=64$,8 个头各自处理一个低维子空间。
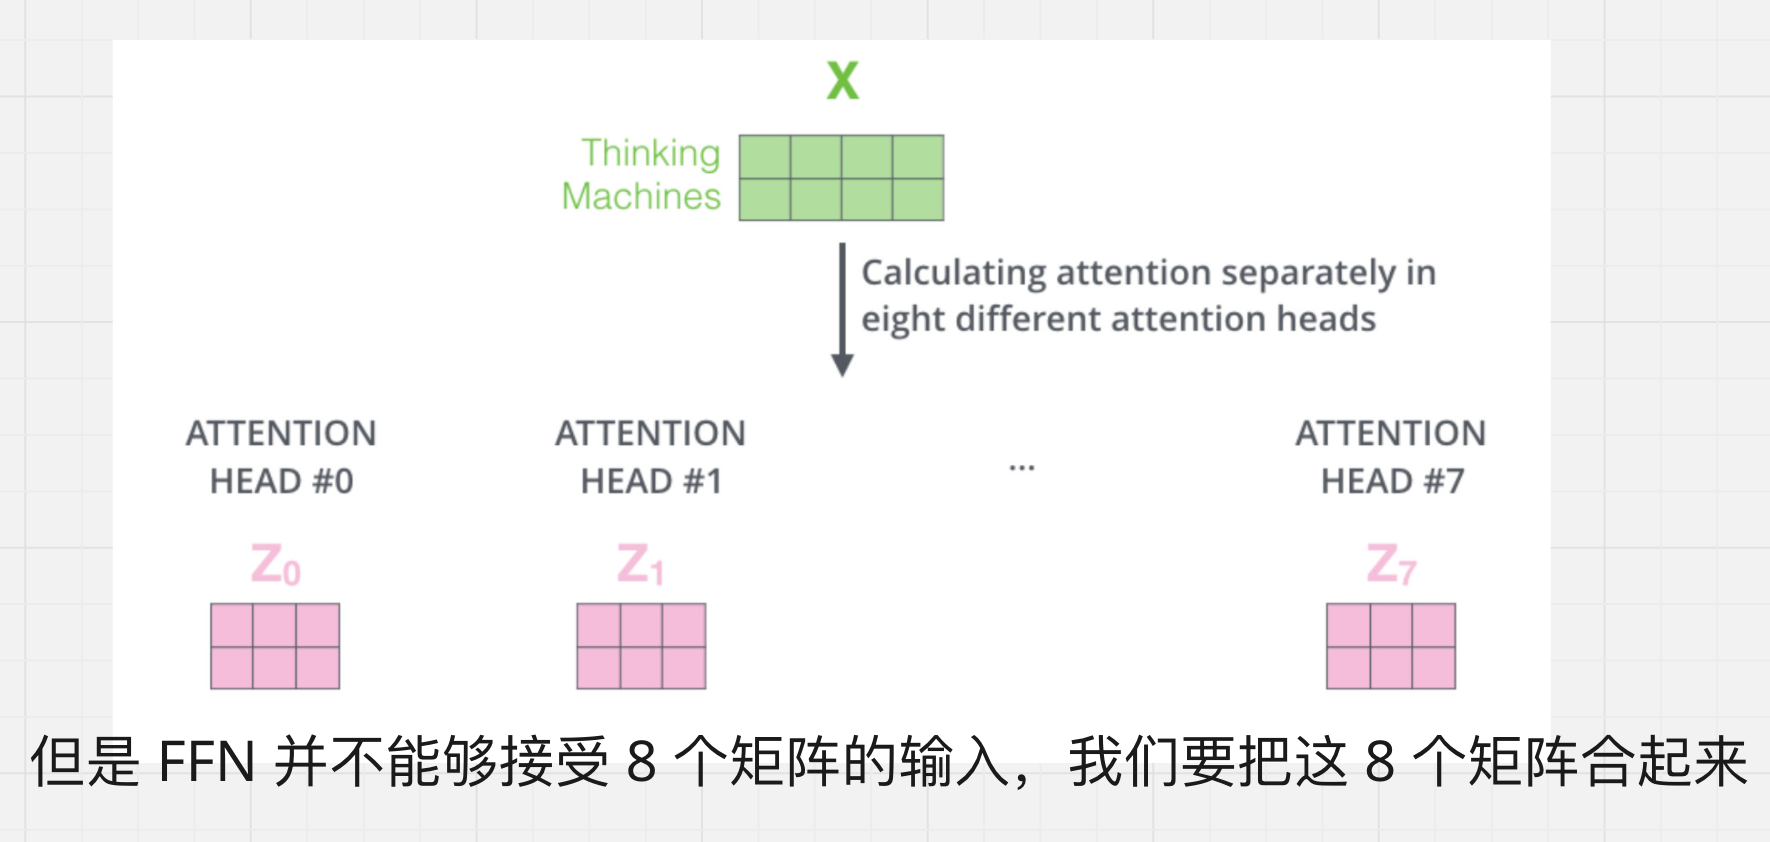
*图 25:多个头各自得到一份输出矩阵。原始截图与手写批注。*
每个头的输出都有一行对应每个 token。各头可能学习到不同的匹配方式,但“一个头专管指代、一个头专管形容词”只是解释图时的直觉,不是模型结构强制的分工。
## 多头怎样重新合成一个输出
把各头输出沿特征维拼接,再经过输出投影 $W^O$。这里才用到了拼接:单头内部是把各位置的 V 加权求和,多头之间是把各头结果接起来。
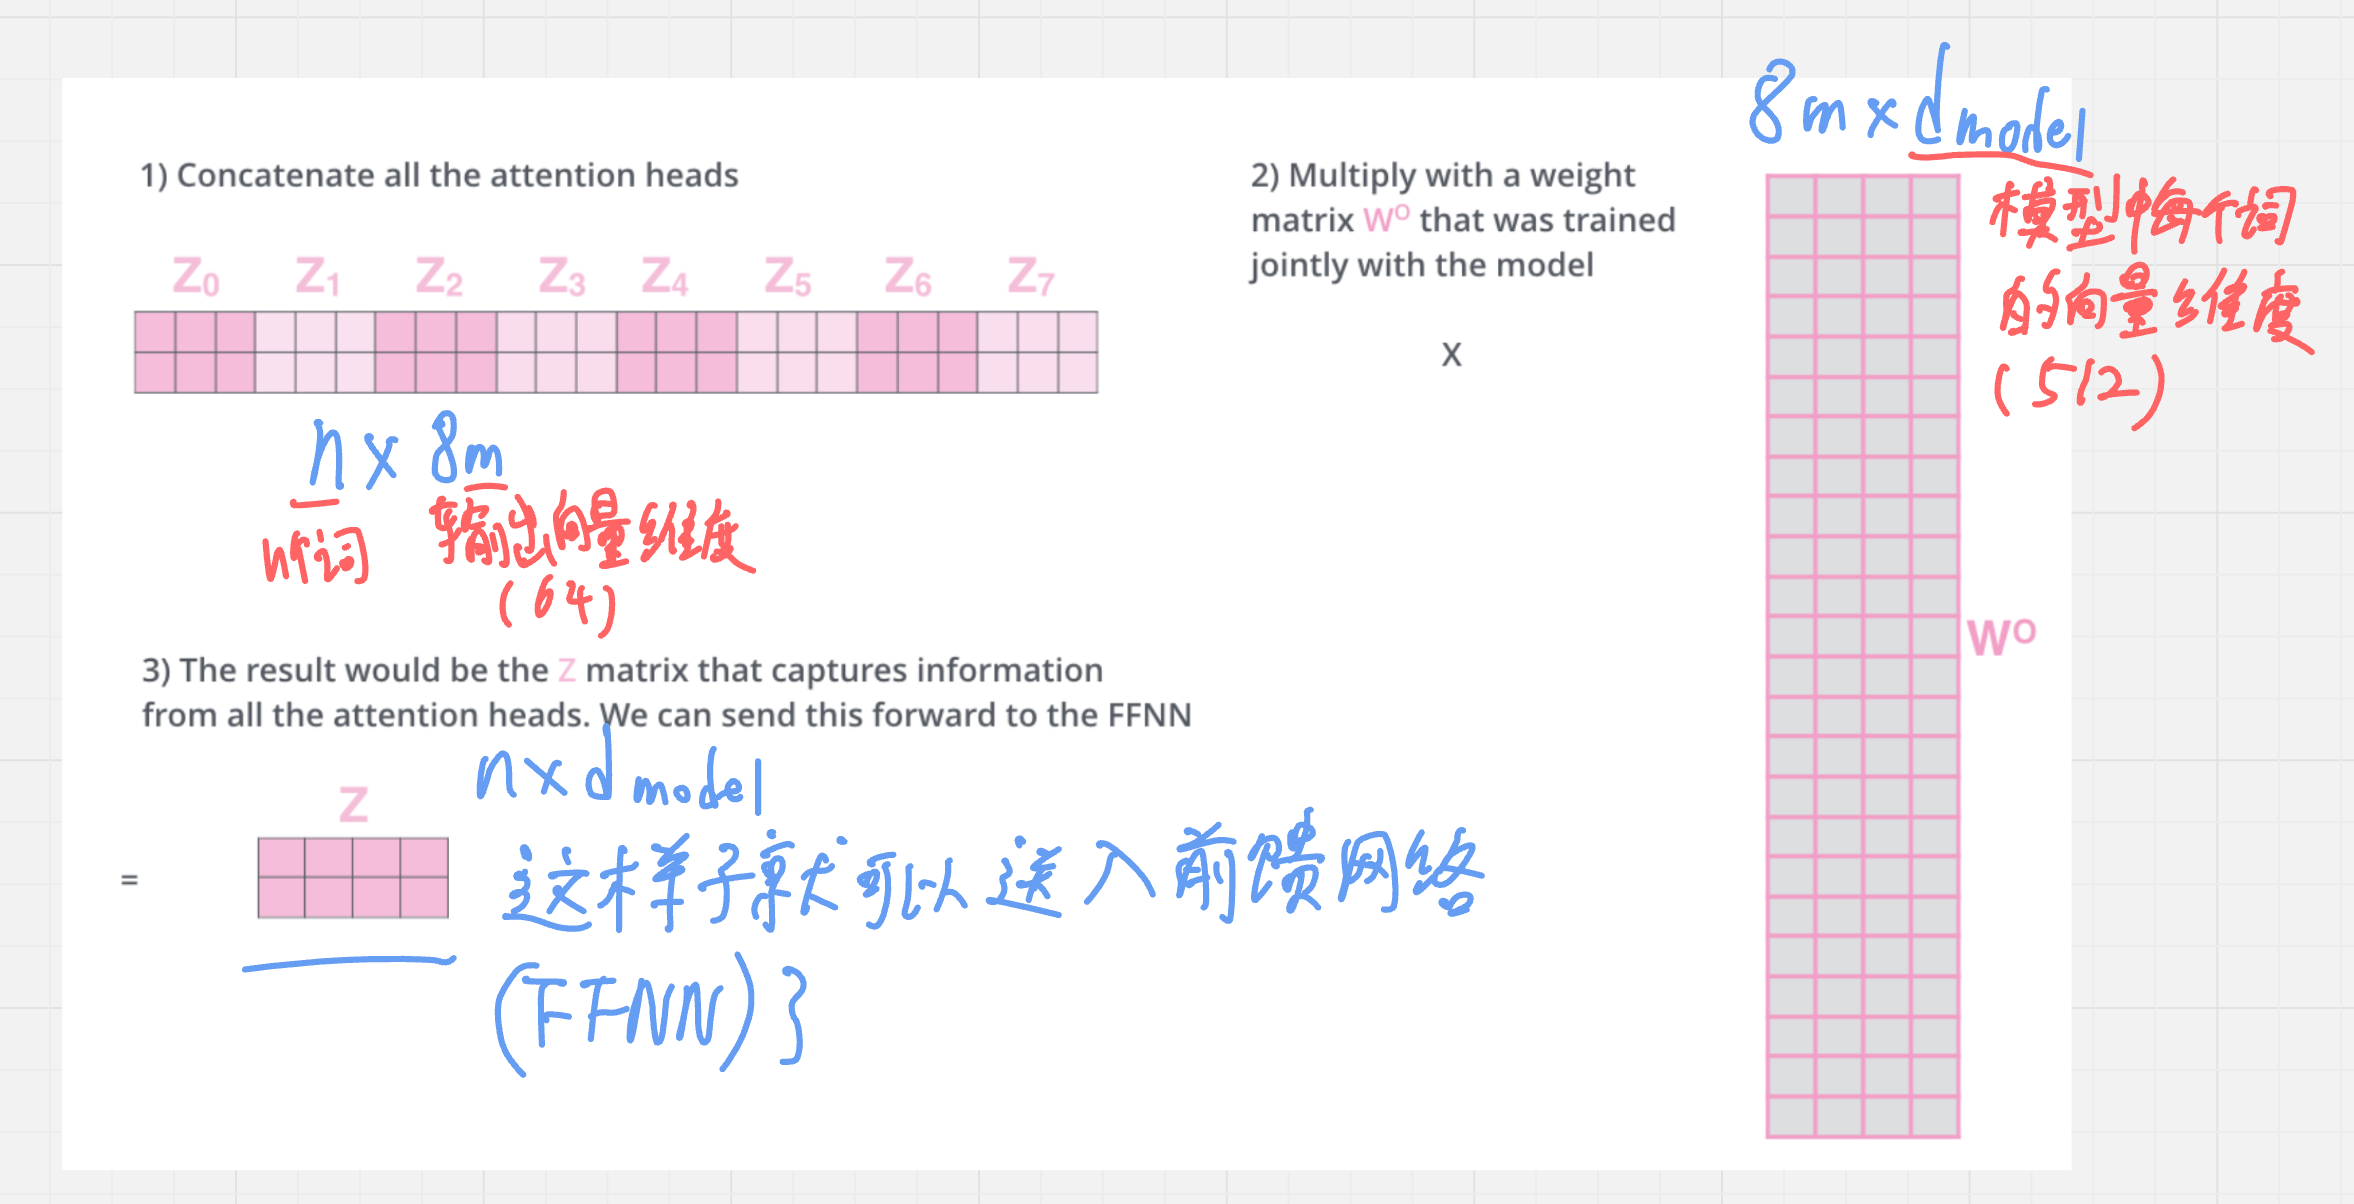
*图 26:多头结果拼接后乘输出投影 WO。原始截图与手写批注。*
以 8 个 64 维的头为例,同一 token 的 8 个结果接成 512 维,再做输出投影。这样可以混合不同头的信息,并回到模型主干使用的维度,继续做残差相加和 FFN。
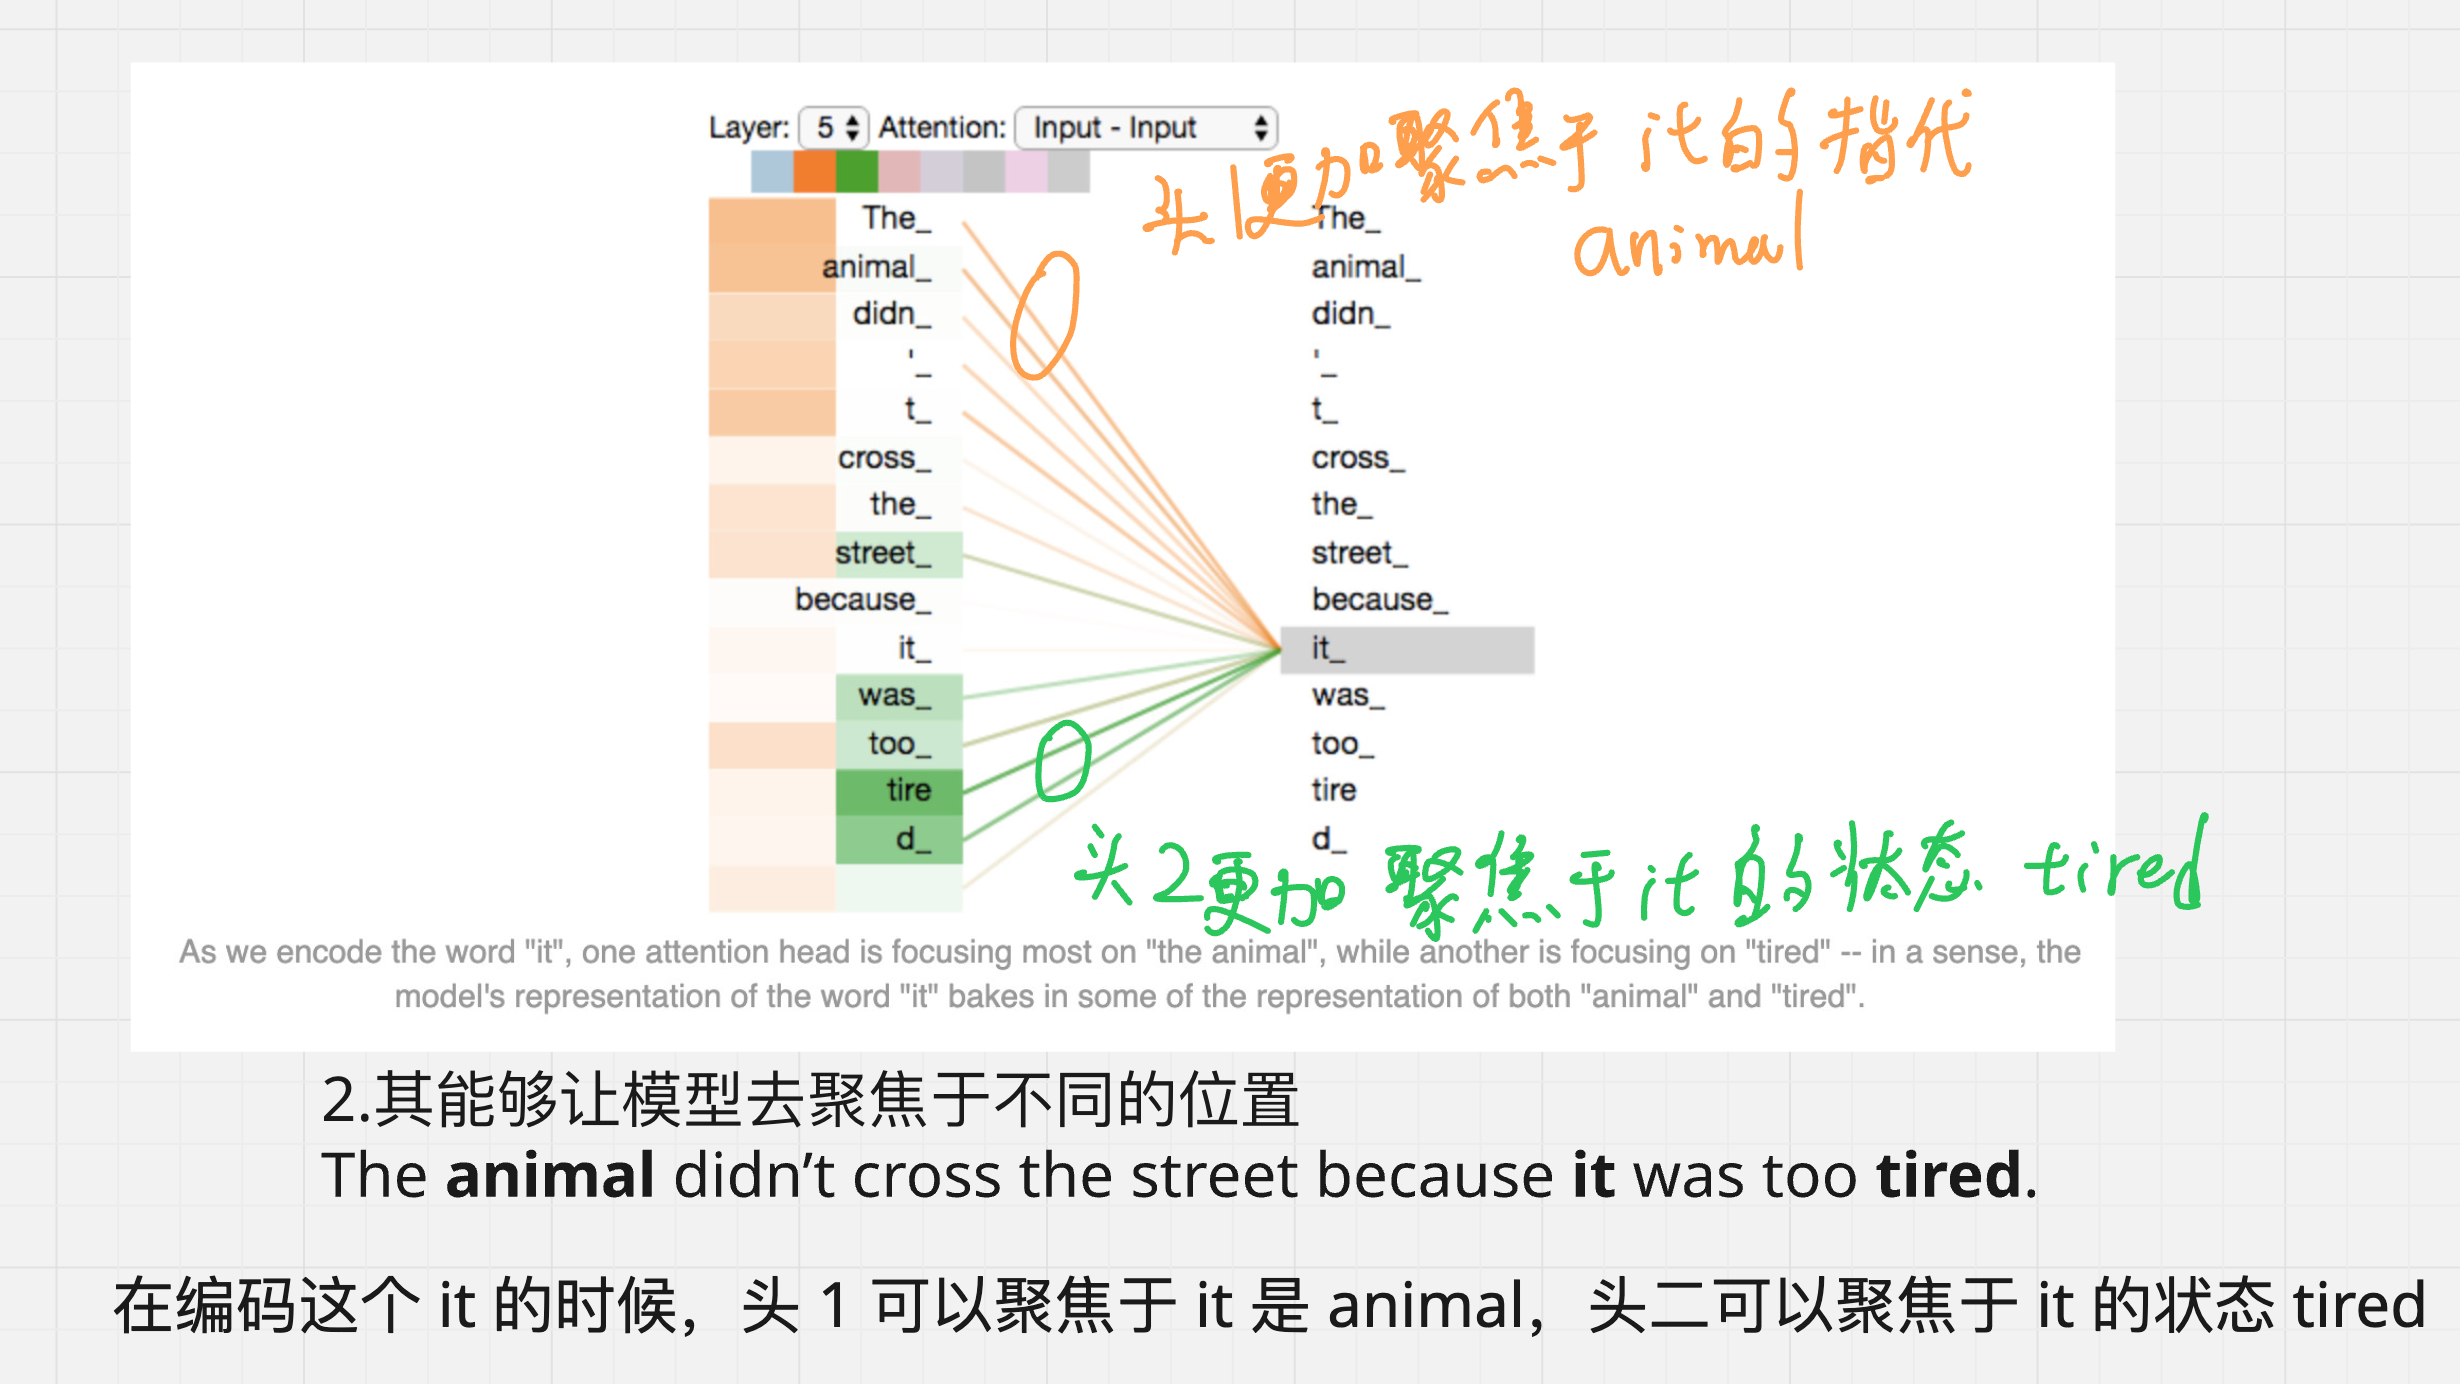
*图 27:两个头对同一 it 的不同关注分布。原始截图与手写批注。*
这张图帮我们观察不同头可能参考不同位置。权重是这一层、这一头、这一次输入下的结果,换一句话或者换一个层,分布都可能变。它也不是对模型最终判断原因的完整解释。
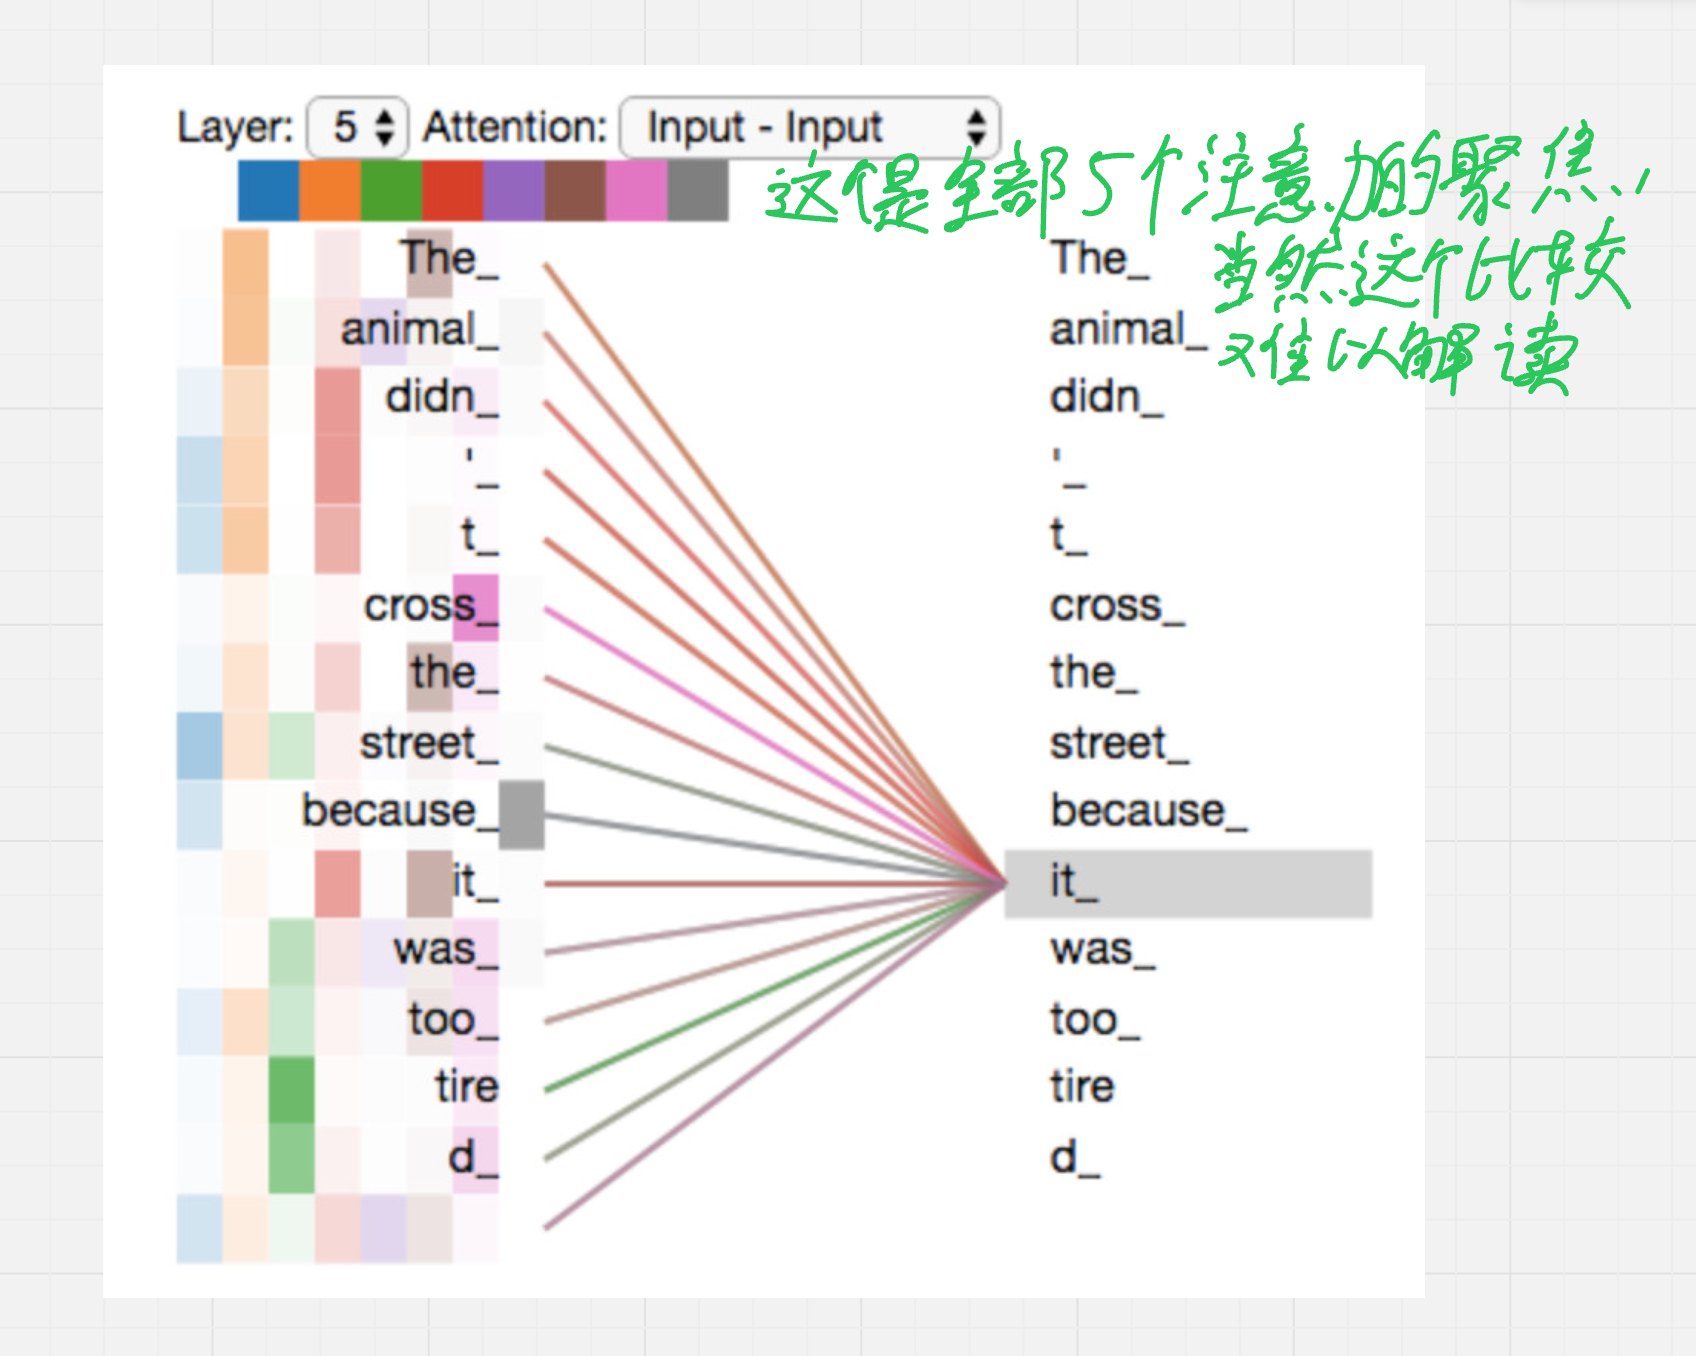
*图 28:同时展开更多头以后,注意力连线变得密集。原始截图与手写批注。*
最后回到总图检查自己是否真懂:Q/K 决定位置之间的匹配比例,V 提供要汇总的内容;softmax 的一行对应一个查询;多头分别汇总,再拼接投影。只要这四句话能和图上的每条箭头对上,注意力公式就不再是一串需要硬背的符号。
主要参考:[The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/)。缩放点积与多头投影的精确定义见 [Attention Is All You Need,第 3.2 节](https://arxiv.org/abs/1706.03762)。