2026牛客暑期多校 8——E-Prefix Codes · znzryb
# 题目大意
### 前缀码
**时间限制:** C/C++/Rust/Pascal 2秒,其他语言4秒
**空间限制:** C/C++/Rust/Pascal 1024 M,其他语言2048 M
<!-- Notion block type: heading_4 -->
在这道题目中,**码字**(codeword)指一个非空字符串,**码本**(codebook)指一个由若干互不相同的码字组成的非空集合。
如果一个码本中任意两个不同的码字 $x$ 和 $y$,都满足 $x$ 不是 $y$ 的前缀,且 $y$ 也不是 $x$ 的前缀,则该码本被称为**前缀码**(prefix code)。
Soy 得到了两个非空字符串 $s$ 和 $p$。他想使用 $s$ 的子串作为码字来构造一个前缀码。但是,他不希望 $p$ 在任何码字中出现。
更正式地说,如果一个字符串 $x$ 满足以下所有条件,则它是一个**合法的码字**:
- $x$ 是非空字符串;
- $x$ 是 $s$ 的一个子串;
- $p$ 不是 $x$ 的子串。
子串仅通过其字符串内容进行区分。如果同一个字符串在 $s$ 的多个不同位置出现,它仍然只被视为一个合法的码字。
一个**有效的码本**指完全由合法码字组成的前缀码。换句话说,它是一个由合法码字组成的非空集合 $C$,使得对于集合中的任意两个不同字符串 $x, y \in C$,互不为对方的前缀。
如果两个有效码本中,存在一个码本包含某个码字而另一个码本不包含,则认为这两个码本是不同的。
请计算 Soy 能构造出多少种不同的有效码本。由于答案可能非常大,请将结果对 $998244353$ 取模后输出。
<!-- Notion block type: heading_4 -->
第一行包含一个字符串 $s$($1 \le \vert{}s\vert{} \le 5 \cdot 10^5$)。
第二行包含一个字符串 $p$($1 \le \vert{}p\vert{} \le 5 \cdot 10^5$)。
保证两个字符串均仅由小写英文字母组成。
<!-- Notion block type: heading_4 -->
输出一个整数,表示不同的有效码本数量对 $998244353$ 取模后的结果。
<!-- Notion block type: heading_4 -->
<!-- Notion block type: heading_4 -->
<!-- Notion block type: heading_4 -->
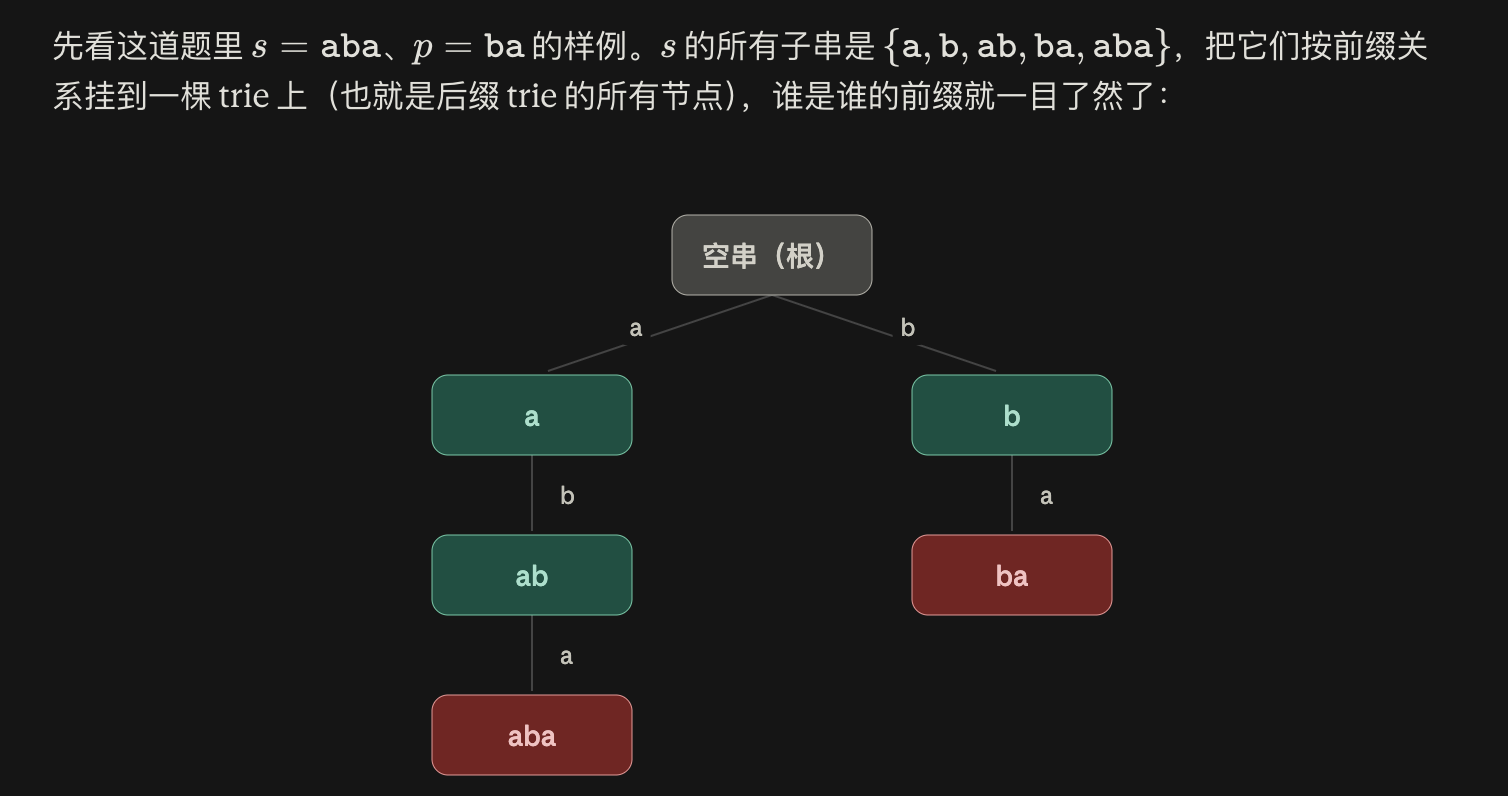
在样例中,$s = \text{"aba"}$ 的子串包含 `a`, `b`, `ab`, `ba`, `aba`。其中包含 $p = \text{"ba"}$ 的子串有 `ba` 和 `aba`。
剔除掉包含 $p$ 的子串后,**合法码字**的集合为:`{"a", "b", "ab"}`。
利用这些合法码字构成的**有效码本**(即集合内的码字互不为前缀)如下:
1. `{"a"}`
1. `{"b"}`
1. `{"ab"}`
1. `{"a", "b"}`
1. `{"b", "ab"}`
注意:`{"a", "ab"}` 不是有效码本,因为 `"a"` 是 `"ab"` 的前缀。
因此总共有 $5$ 种不同的有效码本。
# 思路讲解
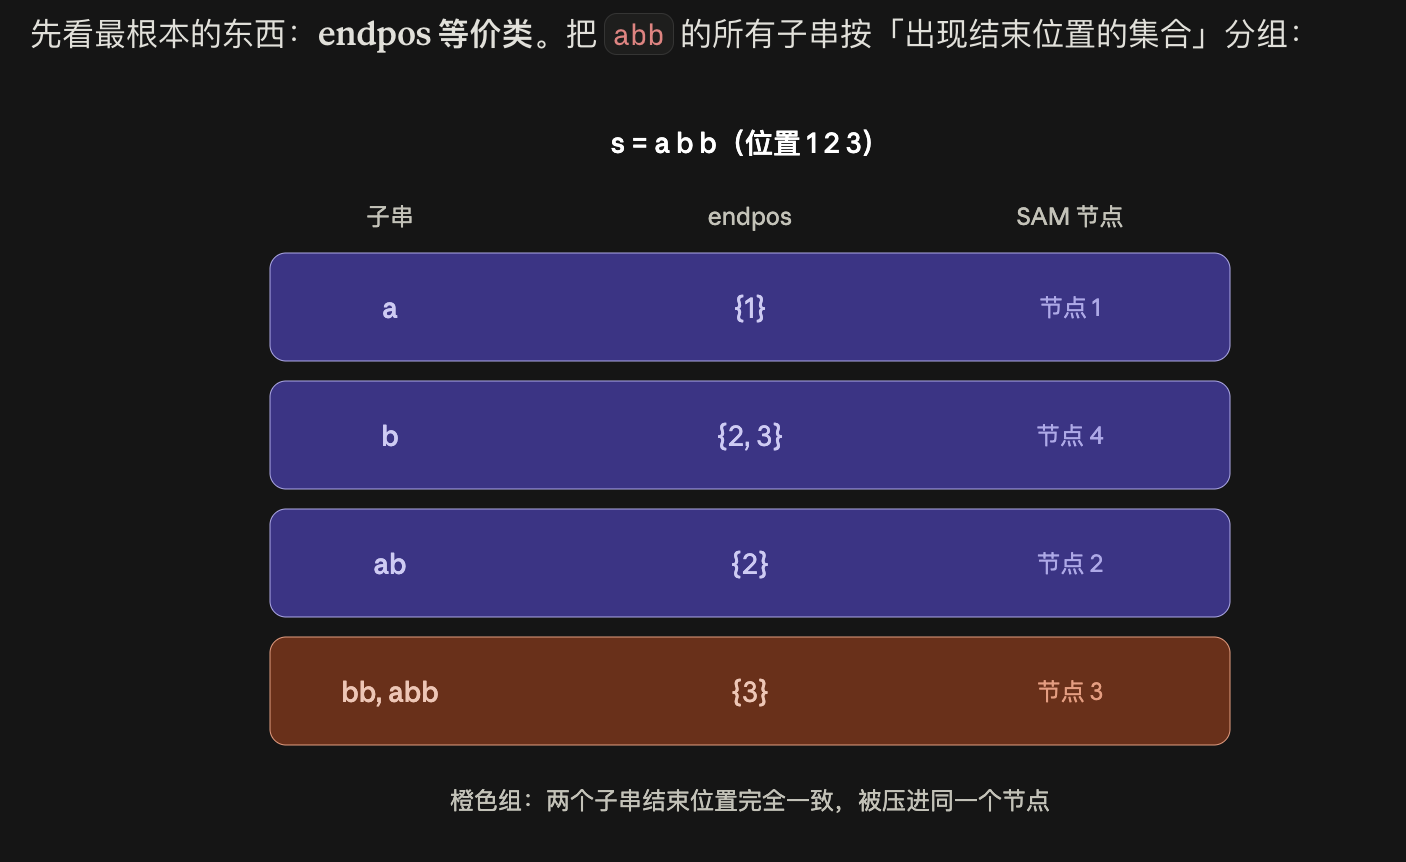
注意,**使用 endpos 集合**对这个**字符串的子串进行分组**啊,而不是反过来。
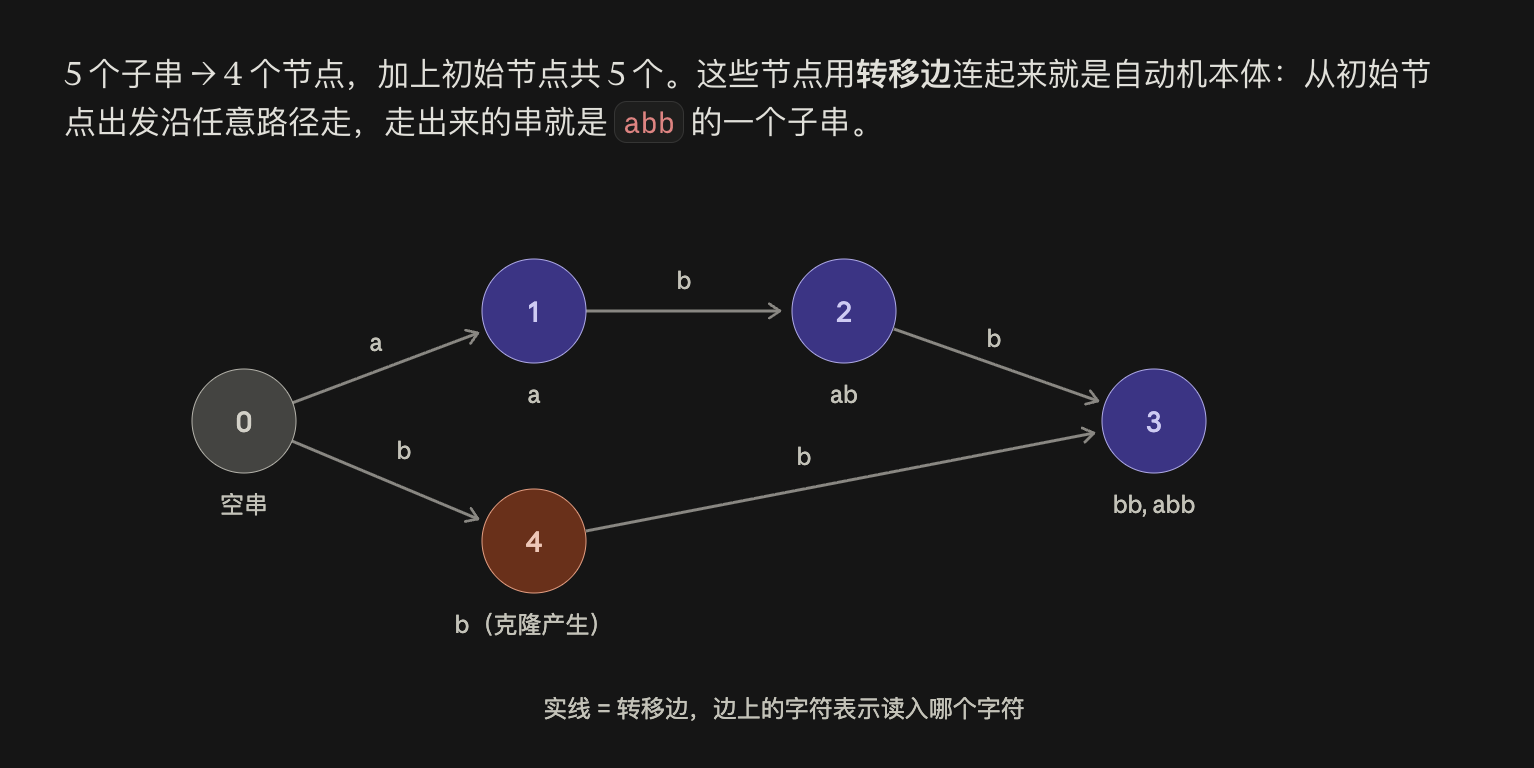
这个是自动机:
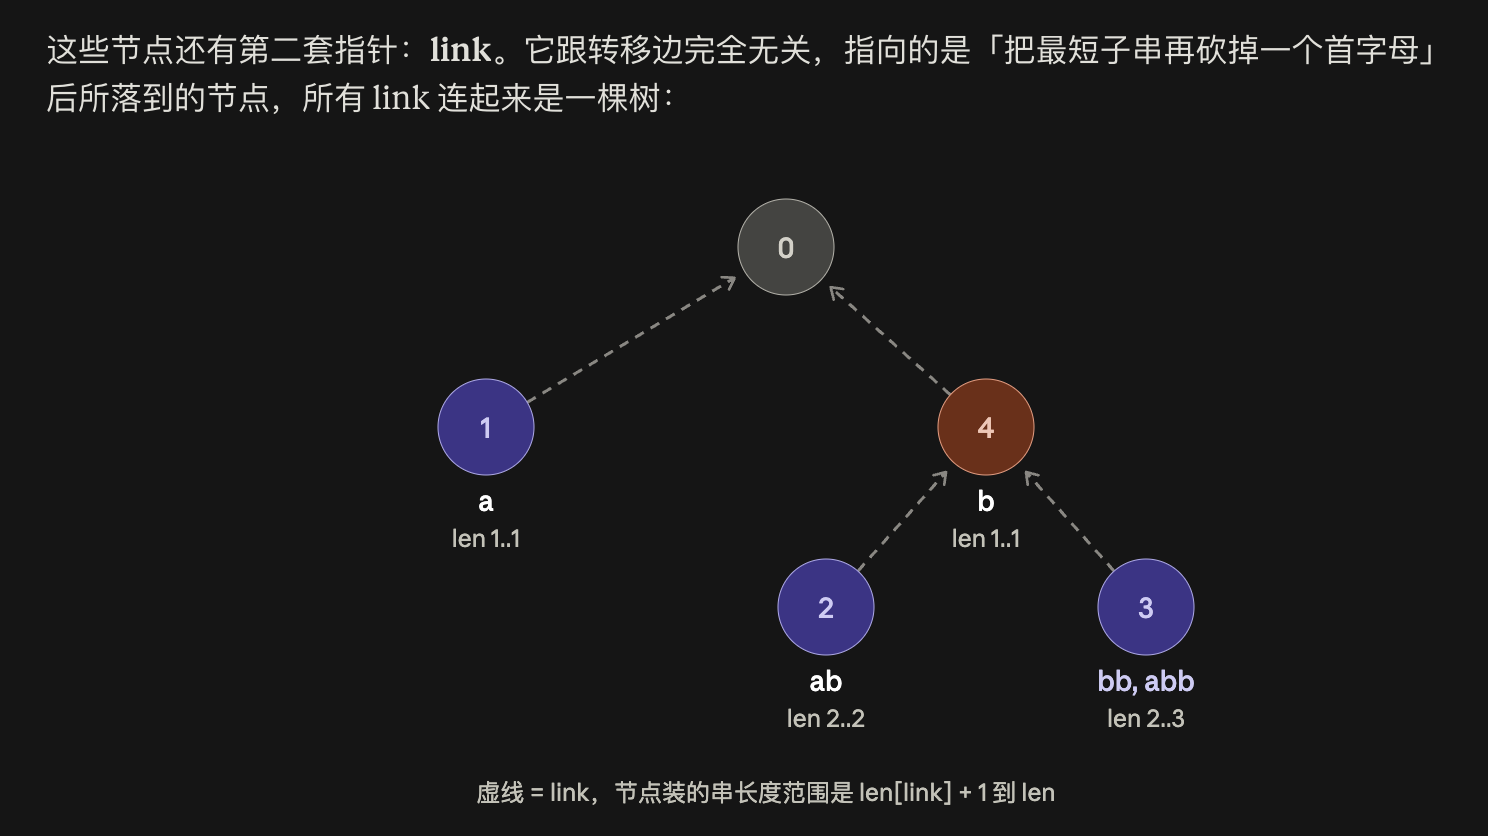
这个是 link 树:
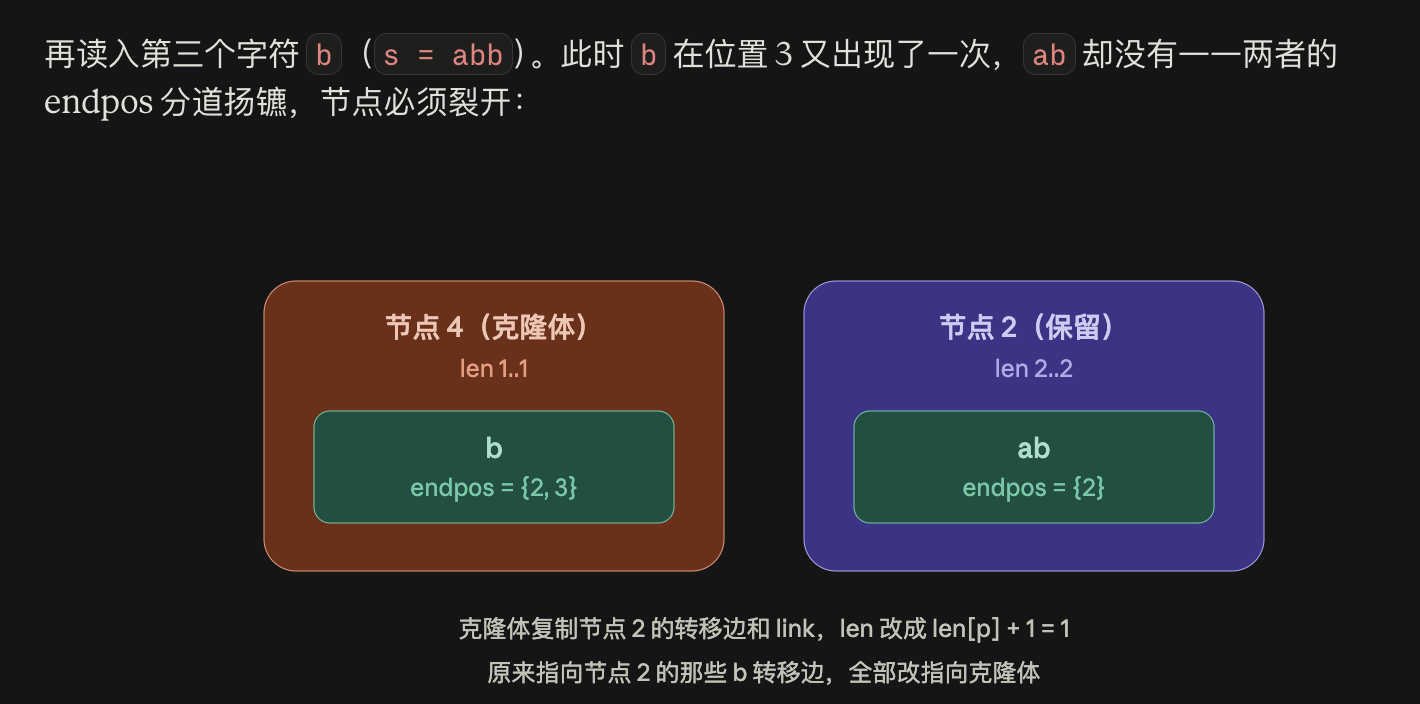
一开始的时候(即刚遍历完 ab 的时候) b 和 ab 显然是处于同一个节点中。
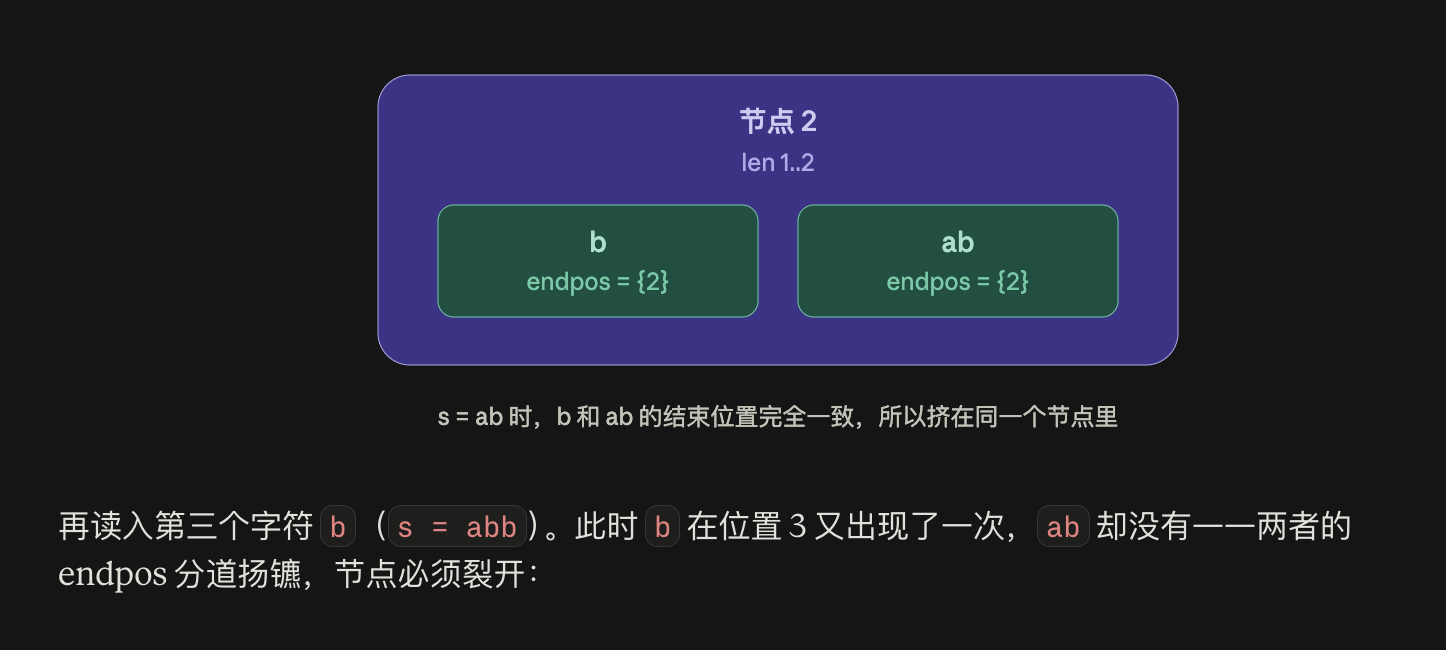
然后读入到第三个字符 ‘b’ 的时候,b 和 ab 就要分道扬镳了。
```cpp
// 定义后缀自动机的最大状态数,通常是字符串长度的两倍
const int MAXLEN = 200005;
// 后缀自动机节点结构
struct State {
int len; // 该状态包含的最长子串的长度
int link; // 后缀链接,指向包含当前状态最短子串的最长真后缀的状态
// (把最短子串的第一个字母去掉,也就是所谓的最长真后缀)
int next[26]; // 字符转移边,假设字符集为小写字母 a-z
};
State st[MAXLEN * 2];
int sz; // 当前自动机中的状态总数
int last; // 指向当前整个字符串完整前缀所在的状态
// 初始化后缀自动机
void sam_init() {
// 状态 0 是初始状态,代表空串
st[0].len = 0;
st[0].link = -1;
for (int i = 0; i < 26; ++i) {
st[0].next[i] = -1;
}
sz = 1;
last = 0;
}
```
### 后缀自动机的重要性质
这些性质乍看之下非常简单啊,但是务必事先清楚,否则之后可能会看不懂一些东西啊。
<!-- Notion block type: heading_4 -->
**核心定理:同一个状态里的字符串,长度必定是绝对连续的**
在 SAM 中,如果状态 $V$ 里**包含了一个短字符串** $S$ **和一个长字符串** $L$,那么**介于它们长度之间的所有后缀,必须全部都在状态** $V$ **里****,绝对不可能有断层。为什么?(反证法)**
假设状态里有长度为 3 的串和长度为 5 的串(它们在原串中出现的集合 $endpos$ 是一模一样的,比如都出现了 4 次)。
那么长度为 4 的那个后缀,它的出现次数绝不可能超过 4 次(因为它包含长度为 5 的串),也绝不可能少于 4 次(因为它被长度为 3 的串包含)。
所以长度为 4 的串,出现集合也必定完全一样!它必须乖乖待在同一个状态里。
<!-- Notion block type: heading_4 -->
**前提**:同一个状态里的所有字符串,它们的结束位置集合($endpos$)是完全一模一样的。
**推导**:假设我们在原字符串中随便挑一个它们的共同结束位置,比如位置 `P`。
**结论**:既然结束位置固定在了 `P`,如果你要在这个位置截取一个长度为 `L` 的字符串,你只能往前数 `L` 个字符。**位置一旦固定,长度一旦固定,切出来的字符串必然是唯一确定的****!**
<!-- Notion block type: heading_4 -->
在 SAM 中,任何一条转移边 `u --(c)--> v` 的构建,都必须且只能遵循唯一一条规则:
**字符串** $maxstr(u) + c$ **的** $endpos$ **集合,必须等于状态** $v$ **代表的** $endpos$ **集合。**
::: 以前的讲解啊,主要是可能复制了一些 AI 的话语,我们重新整理一下啊
### 1. 创建新状态 (`cur`)
```cpp
int cur = sz++;
st[cur].len = st[last].len + 1;
// ... 初始化 next 数组为 -1
for (int i = 0; i < 26; ++i) {
st[cur].next[i] = -1;
}
int p = last;
```
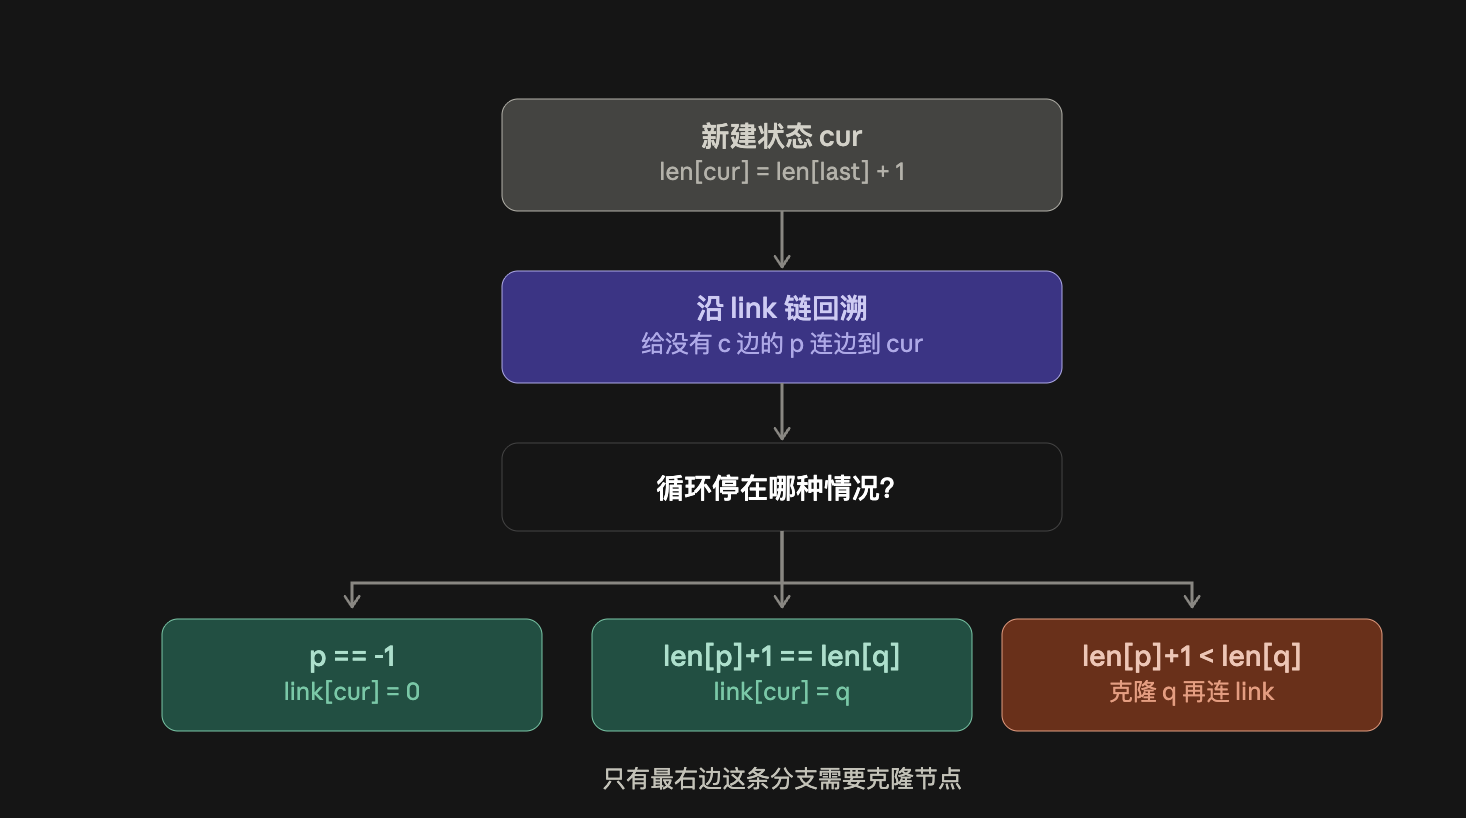
每插入一个新字符,必然会产生一个新的最长前缀(也就是整个新字符串)。我们创建一个新状态 $cur$ 来代表它,它的最长子串长度显然是上一个最长前缀 $last$ 的长度加 1。
### 2. 更新旧后缀的转移边
```cpp
while (p != -1 && st[p].next[c - 'a'] == -1) {
st[p].next[c - 'a'] = cur;
p = st[p].link;
}
```
此时我们要把之前字符串的所有后缀都加上字符 $c$,让它们变成新字符串的后缀。
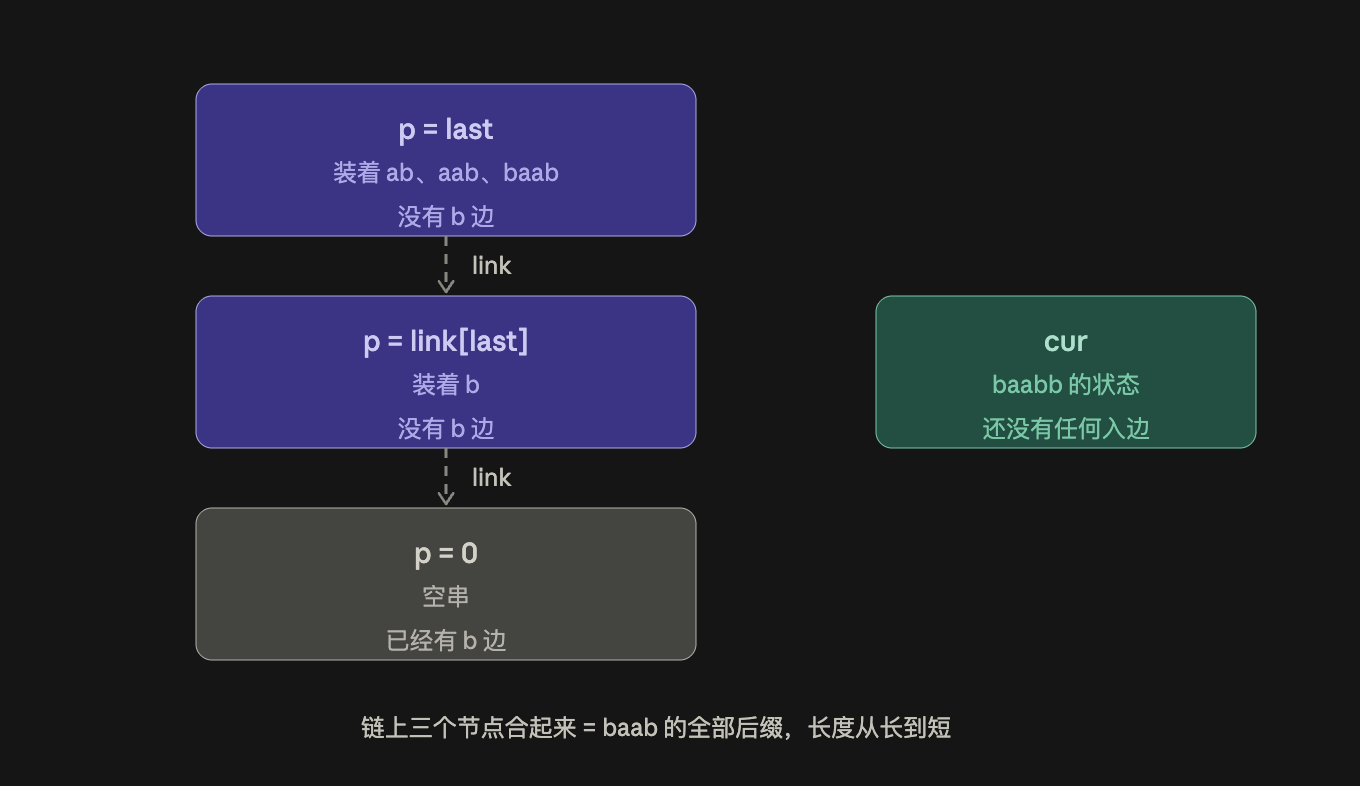
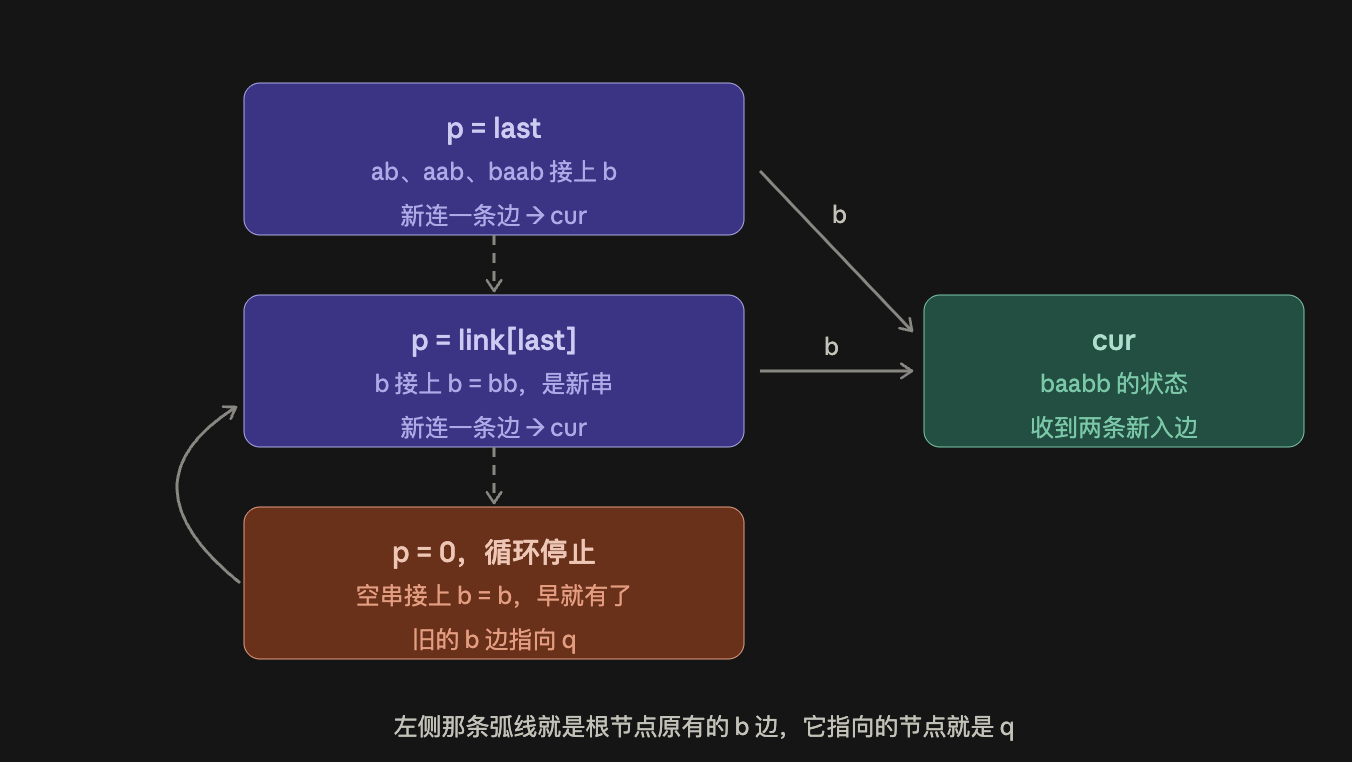
我们通过 `link` 链不断回溯 $last$ 的各个后缀状态 $p$:
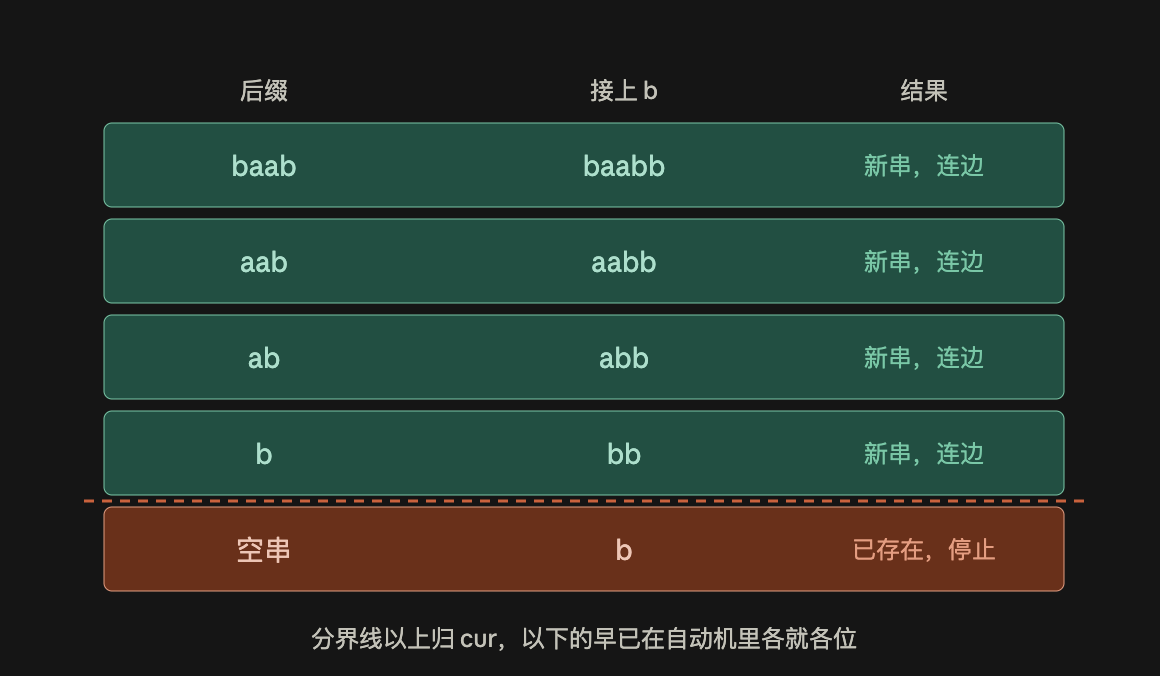
- **如果** $p$ **没有字符** $c$ **的转移边**,说明**这个后缀加上** $c$ **后形成的新子串以前从未出现过**,我们直接给它**连一条边指向** $cur$。
- 如果回溯过程中遇到了**一个状态** $p$ **已经有了** $c$ **的转移边**,说明**从这个长度开始的后缀加上** $c$ **形成的子串,在之前的字符串里已经出现过了**,循环终止。
### 3. 处理后缀链接 (核心难点,分三种情况)
<!-- Notion block type: heading_4 -->
```cpp
if (p == -1) {
st[cur].link = 0;
}
```
如果一直回溯到了虚拟边界($p = -1$),说明字符 $c$ 以前压根就没出现过。新状态 $cur$ 没有其它真后缀曾在图中出现,**它的后缀链接直接指向根节点(状态** $0$**,代表空串)**。
<!-- Notion block type: heading_4 -->
```cpp
int q = st[p].next[c - 'a'];
if (st[p].len + 1 == st[q].len) {
st[cur].link = q;
}
```
状态 $p$ 是我们找到的第一个拥有 $c$ 转移边的状态,它转移到了 $q$。
如果 $st[p].len + 1 == st[q].len$,说明 $q$ 状态**恰好只包含**我们需要的那部分后缀(没有比它更长的了)。这是一种完美的平滑过渡,$q$ 理所当然地成为了 $cur$ 的后缀链接。
<!-- Notion block type: heading_4 -->
```cpp
} else {
sz++;
int clone = sz;
st[clone].link = st[to].link;
st[clone].len = st[p].len + 1;
for (int i = 0; i < 26; ++i) {
st[clone].next[i] = st[to].next[i];
}
while (p != -1 && st[p].next[c - BASE] == to) {
st[p].next[c - BASE] = clone;
p = st[p].link;
}
st[cur].link = clone;
st[to].link = clone;
}
```
这是 SAM 构造中最精妙的部分。如果 $st[p].len + 1 < st[to].len$,说明出现了**断层**。
- **为什么会这样?** $to$ 状态原本代表了多个不同长度的子串。由于当前追加了新字符 $c$,$to$ 中较短的那部分子串成为了新字符串的后缀(它们的出现位置集合 `Endpos` 增加了当前字符串的末尾),而 $to$ 中较长的那部分子串由于前面字符对不上,**没有**成为新字符串的后缀。
- **怎么解决?** 同一个状态里的子串 `Endpos` 集合必须完全一致,现在它们分道扬镳了,所以必须**把** $to$ **拆开**。
- **克隆操作:**
1. 新建一个 $clone$ 状态,专门用来存放原本 $to$ 中较短的、成为了当前后缀的子串。所以它的长度严丝合缝地设为 $st[p].len + 1$。
1. $clone$ 继承 $to$ 的所有出边和后缀链接(因为它本质上是 $to$ 的一部分,后续可以接的字符是一样的)。
1. 我们把 $to$ 和新状态 $cur$ 的后缀链接都指向这个更“纯粹”的 $clone$ 状态。
1. 最后,把 $p$ 的后缀链上,所有原本指向 $to$ 的转移边,全部重定向到 $clone$(纠正历史遗留的指针)。
**1. 核心前提:什么会打破原有的** $endpos$ **等价类?**
在一个已经建好的 SAM 中,如果两个子串在同一个状态(节点)里,意味着它们在原串中出现的**结束位置集合 (**$endpos$**) 是完全相同的**。
现在,我们在原字符串末尾追加了一个新字符 $c$。产生了一个新的末尾位置,我们叫它 $L$。
**请问:哪些子串的** $endpos$ **集合会多出一个** $L$**?**
答案是:**只有新字符串的“后缀”们,它们的** $endpos$ **才会新增** $L$**。** 其他任何子串的 $endpos$ 都不变。
这就会导致一个致命问题:原本同属于一个状态的两个子串,**可能一个是新字符串的后缀,另一个不是**。它们的 $endpos$ 集合**分道扬镳**了,不能再待在同一个状态里了!
**2. 代码是如何精准识别并处理“分道扬镳”的?i**
当我们顺着 $last$ 的 `link` 链往上回溯时,其实是在**按长度从大到小遍历旧字符串的所有后缀**。
代码将新产生的后缀分为了三类,对应了代码里的三种情况:
**情况一:从未出现过的全新后缀****(对应** **`cur`** **状态)**
旧字符串的这些后缀加上 $c$ 后,形成的新子串以前从来没在串里出现过。
• $endpos$ **变化:** 这些子串是**全新的**,**它们的** $endpos$ **集合只有唯一的一个值:**$\{L\}$。
• **代码操作:** 因为它们 $endpos$ 完全一样(都是 $\{L\}$),所以把它们全塞进新创建的 `cur` 状态中。
```cpp
// 沿着 link 链回溯,将所有没有字符 c 转移边的状态连向 cur
while (p != -1 && st[p].next[c - 'a'] == -1) {
st[p].next[c - 'a'] = cur;
p = st[p].link;
}
```
**情况二:和平共处,没有分化(对应** **`len(p) + 1 == len(q)`****)**
如果 $len(p) + 1 == len(q)$,**说明状态** $q$ **里面最长的子串就是** $X$。
因为 $X$ 是状态 $q$ 里最长的,那么 $q$ 里面所有比 $X$ 短的子串,必然是 $X$ 的后缀。既然 $X$ 是新字符串的后缀,那它的后缀当然也全是新字符串的后缀。
• $endpos$ **变化:** 状态 $q$ 里的**所有子串**,统统都是新字符串的后缀。**它们的** $endpos$ **集合全部都齐刷刷地增加了** $L$。
• **结论:** 它们的 $endpos$ 集合依然保持完全一致!不需要拆分。直接让 `cur.link = q` 即可。
**情况三:发生阶级分化,必须拆分(对应** **`len(p) + 1 < len(q)`****,克隆的本质)**
这是最精妙的地方。如果 $len(p) + 1 < len(q)$,说明状态 $q$ 里面**还有比** $X$ **更长的子串(我们叫它** $Y$**)**。
• $X$ 的长度是 $len(p) + 1$,它是新字符串的后缀,它的 $endpos$ 需要加入 $L$。
• $Y$ 呢?$Y$ 也是 $q$ 里的子串,它原本和 $X$ 的出现位置一模一样。**但是,**$Y$ **不是新字符串的后缀!** (如果 $Y$ 也是新后缀,那么我们在回溯 $link$ 链时,应该在一个比 $p$ 更长的后缀处就遇到 $c$ 的转移边,而不是等到 $p$ 才遇到)。
• $endpos$ **变化:** $X$ 的 $endpos$ 变成了 $old\_endpos \cup \{L\}$,而 $Y$ 的 $endpos$ 依然是 $old\_endpos$。
• **结论:** 状态 $q$ 内部“分裂”了!代表短子串的 $X$ 和代表长子串的 $Y$ 不能再共用一个状态了。
```cpp
// 增量法向自动机中插入一个字符
void sam_extend(char c) {
int cur = sz++;
// 新状态的最长子串长度是之前最长长度加 1
st[cur].len = st[last].len + 1;
for (int i = 0; i < 26; ++i) {
st[cur].next[i] = -1;
}
int p = last;
// 沿着 link 链回溯,将所有没有字符 c 转移边的状态连向 cur
while (p != -1 && st[p].next[c - 'a'] == -1) {
st[p].next[c - 'a'] = cur;
p = st[p].link;
}
// 如果一直回溯到了虚拟边界(-1),说明没有任何后缀有 c 的转移
if (p == -1) {
st[cur].link = 0;
} else {
// 找到了第一个存在字符 c 转移边的状态 p,它转移到了状态 q
int q = st[p].next[c - 'a'];
// 情况一:连续转移,没有长度断层
if (st[p].len + 1 == st[q].len) {
st[cur].link = q;
} else {
// 情况二:存在长度断层,必须拆分状态 q
int clone = sz++;
// 克隆状态继承 q 的转移边和 link,但修正其最长长度
st[clone].len = st[p].len + 1;
for (int i = 0; i < 26; ++i) {
st[clone].next[i] = st[q].next[i];
}
st[clone].link = st[q].link;
// 将 q 和 cur 的后缀链接都指向这个更“纯粹”的克隆状态
while (p != -1 && st[p].next[c - 'a'] == q) {
st[p].next[c - 'a'] = clone;
p = st[p].link;
}
st[q].link = clone;
st[cur].link = clone;
}
}
// 更新最后插入的状态
last = cur;
}
```
:::
## 插入字符,构造后缀自动机:函数 sma_insert()
### 插入一个后缀字符 $c$,我们到底要修改什么,其影响范围是什么?
**只有新字符串的“后缀”们,它们的** $endpos$ **才会新增** $L$**。** 其他任何子串的 $endpos$ 都不变。
所以我们要**对所有的新字符串的后缀**进行修改。
**新字符串**即:比如说,$abaab$,遍历到了 $abaa$, 最后的 $b$ 还没遍历到,$abaa$ **就是我们的新字符串**。
### 建立新字符串对应的 State 节点
这个就是平平无奇的这个初始化啊。相当于 new 一个下标为 cur 的这个节点啊,代表目前整个后缀字符串啊。(比如说,$abaab$,遍历到了 $abaa$, 最后的 $b$ 还没遍历到,$abaa$ 的这个长度为 4 啊)
```cpp
sz++;
int cur = sz;
st[cur].len = st[last].len + 1;
for (int i = 0; i < 26; ++i) {
st[cur].next[i] = -1;
}
```
### 2. 更新旧后缀的转移边
```cpp
while (p != -1 && st[p].next[c - 'a'] == -1) {
st[p].next[c - 'a'] = cur;
p = st[p].link;
}
```
此时我们要把之前字符串的所有后缀都加上字符 $c$,让它们变成新字符串的后缀。
我们通过 `link` 链不断回溯 $last$ 的各个后缀状态 $p$:
- 如果 $p$ 没有字符 $c$ 的转移边,说明**这个后缀加上** $c$ **后形成的新子串以前从未出现过**(即 $maxstr(p) + ‘c’$ **对应的字符串后缀之前没有出现过**啊($maxstr(p)$,就是状态 p 所包含的最长子串,$+$ 是指的字符串与字符拼接)),我们直接给它连一条边指向 $cur$。
- 如果回溯过程中遇到了一个状态 $p$ 已经有了 $c$ 的转移边,说明**从这个长度开始的后缀加上** $c$ **形成的子串,在之前的字符串里已经出现过了**,循环终止。
- 如果我们强行继续更新下面的,由于不是新子串,我们不能够保证这个任何一条转移边 `u --(c)--> v` 必须满足:字符串 $maxstr(u) + c$ 的 $endpos$ 集合,必须等于状态 $v$ 代表的 $endpos$ 集合。
### 3. 处理后缀链接 (核心难点,分三种情况)
<!-- Notion block type: heading_4 -->
```cpp
if (p == -1) {
st[cur].link = 0;
}
```
如果一直回溯到了虚拟边界($p = -1$),说明字符 $c$ 以前压根就没出现过。新状态 $cur$ 没有其它真后缀曾在图中出现,它的后缀链接直接指向根节点(状态 $0$,代表空串)。
<!-- Notion block type: heading_4 -->
```cpp
int to = st[cur].next[c - BASE];
// to 可以作为我们的 link 啊
// 但是我们需要其为最小串的这个去掉首字母以后的串啊
if (st[p].len + 1 == st[to].len) {
// (p 是字符串)p + ‘c’ 就是 to 中的最长子串,因此不需要对这个 to 进行这个分裂
// 根据 end pos 性质,to 中更短的,也是这个 cur 的这个后缀啊
st[cur].link = to;
}
```
状态 $p$ 是我们找到的第一个拥有 $c$ 转移边的状态,它转移到了 $to$。
如果 $st[p].len + 1 == st[to].len$,**说明** $to$ **状态恰好只包含我们需要的那部分后缀**(没有比它更长的了,如果有比这个 $maxstr(p) + c$ 更长的啊,就麻烦了,因为我们保证 $maxstr(p) + c$ 这个是 $cur$ 的后缀,但是更长的,就一定不是 $cur$ 的后缀了)。这是一种完美的平滑过渡,$to$ 理所当然地成为了 $cur$ 的后缀链接。
<!-- Notion block type: heading_4 -->
::: 比这个 \$maxstr\(p\) \+ c\$ 更长的啊,就麻烦了,因为我们保证 \$maxstr\(p\) \+ c\$ 这个是 \$cur\$ 的后缀,但是\*\*更长的\*\*,就一定不是 \$cur\$ 的后缀了,那\*\*为什么一定不是 cur 的后缀\*\*?
其实也很简单,更长的字符串 $L’$ 如果比这个 $maxstr(p) + ‘c’$ 长,那么在之前 link 的时候,必然会遇到一个 $p’$,使得 $L'=maxstr(p’) + ‘c’$,但是,显然没有,**p 是第一个有 ‘c’ 转移能力的**。
:::
```cpp
} else {
sz++;
int clone = sz;
st[clone].link = st[to].link;
st[clone].len = st[p].len + 1;
for (int i = 0; i < 26; ++i) {
st[clone].next[i] = st[to].next[i];
}
while (p != -1 && st[p].next[c - BASE] == to) {
// 原先的,转移到 to 已经不合适了
// maxstr(p) + c 的这个 endpos 包含 cur
// 但是原来的 to 是不包含 cur 的,因此需要更新
// 更新为这个这个 clone,因为 clone endpos 包含这个 cur
st[p].next[c - BASE] = clone;
p = st[p].link;
}
st[cur].link = clone;
// 使用连续性定理(后缀自动机的性质里面提到的),我们知道 to 中包含 len(maxstr(p))+2 的这个字符串啊
// 因此也接到这个 clone 上面啊
st[to].link = clone;
}
```
这是 SAM 构造中最精妙的部分。如果 $st[p].len + 1 < st[to].len$,说明出现了**断层**。
- **为什么会这样?** $to$ 状态原本代表了多个不同长度的子串。由于当前追加了新字符 $c$,$to$ 中较短的那部分子串成为了新字符串的后缀(它们的出现位置集合 `Endpos` 增加了当前字符串的末尾),而 $q$ 中较长的那部分子串由于前面字符对不上,**没有**成为新字符串的后缀。
- **怎么解决?** 同一个状态里的子串 `Endpos` 集合必须完全一致,现在它们分道扬镳了,所以必须**把** $to$ **拆开**。
- **克隆操作:**
1. 新建一个 $clone$ 状态,专门用来存放原本 $to$ 中较短的、成为了当前后缀的子串。所以它的长度严丝合缝地设为 $st[p].len + 1$。
1. $clone$ 继承 $to$ 的所有出边和后缀链接(因为它本质上是 $to$ 的一部分,后续可以接的字符是一样的)。
1. 我们把 $to$ 和新状态 $cur$ 的后缀链接都指向这个更“纯粹”的 $clone$ 状态。
1. 最后,把 $p$ 的后缀链上,所有原本指向 $to$ 的转移边,全部重定向到 $clone$(纠正历史遗留的指针)。
::: 完整的 SAM 代码
```cpp
template<int MAXLEN>
struct SufAutomaton {
struct State {
int len; // 该状态包含的最长子串的长度
int link; // 后缀链接,指向包含当前状态最短子串的最长真后缀的状态
// (把最短子串的第一个字母去掉,也就是所谓的最长真后缀)
int next[26]; // 字符转移边,假设字符集为小写字母 a-z
};
State st[MAXLEN * 2];
int sz; // 当前自动机中的状态总数
int last; // 指向当前整个字符串完整前缀所在的状态
static constexpr char BASE = 'a';
void sam_init() {
st[0].len = 0;
st[0].link = -1;
for (int i = 0; i < 26; ++i) {
st[0].next[i] = -1;
}
sz = 1;
last = 0;
}
void sam_extend(char c) {
sz++;
int cur = sz;
st[cur].len = st[last].len + 1;
for (int i = 0; i < 26; ++i) {
st[cur].next[i] = -1;
}
int p = last;
while (p != -1 && st[p].next[c - BASE] == -1) {
st[p].next[c - BASE] = cur;
p = st[p].link;
}
if (p == -1) {
st[cur].link = 0;
} else {
int to = st[cur].next[c - BASE];
// to 可以作为我们的 link 啊
// 但是我们需要其为最小串的这个去掉首字母以后的串啊
if (st[p].len + 1 == st[to].len) {
// (p 是字符串)p + ‘c’ 就是 to 中的最长子串,因此不需要对这个 to 进行这个分裂
// 根据 end pos 性质,to 中更短的,也是这个 cur 的这个后缀啊
st[cur].link = to;
} else {
sz++;
int clone = sz;
st[clone].link = st[to].link;
st[clone].len = st[p].len + 1;
for (int i = 0; i < 26; ++i) {
st[clone].next[i] = st[to].next[i];
}
while (p != -1 && st[p].next[c - BASE] == to) {
// 原先的,转移到 to 已经不合适了
// maxstr(p) + c 的这个 endpos 包含 cur
// 但是原来的 to 是不包含 cur 的,因此需要更新
// 更新为这个这个 clone,因为 clone endpos 包含这个 cur
st[p].next[c - BASE] = clone;
p = st[p].link;
}
st[cur].link = clone;
// 使用连续性定理(后缀自动机的性质里面提到的),我们知道 to 中包含 len(maxstr(p))+2 的这个字符串啊
// 因此也接到这个 clone 上面啊
st[to].link = clone;
}
}
}
};
```
:::
## 回到这道题目啊
### **1. 问题转化**
题目要求我们找出 $s$ 的若干个子串,满足以下条件:
1. 这些子串都**不能包含** $p$ 作为子串。
2. 任意两个选出的子串,**互不为前缀**(Prefix Code)。
3. 选出的集合非空。
如果不考虑包含 $p$ 的限制,所有子串的前缀关系天然构成了一棵**前缀字典树(Prefix Trie)**。题目中的“互不为前缀”,在树上等价于:**选出的节点中,没有任何一个节点是另一个节点的祖先**(即这组成了一个非空的反链 Anti-chain)。
限制“不能包含 $p$” 具有向下传递的性质:如果在字典树上某个节点对应的子串包含了 $p$,那么它在字典树上的所有子孙节点(即所有以它为前缀的字符串)也必定包含 $p$。因此,我们相当于在整棵前缀字典树上**剪掉了一些子树**,然后在剩余的有效树中选反链。
### **2. 树形 DP 计算反链数**
在一棵普通的树上求反链的数量,可以通过树形 DP 解决。
设 $dp[u]$ **表示在以** $u$ **为根的子树中,选择反链的方案数加上1**(加1代表在 $u$ 的子树中什么都不选的空集方案)。
• 如果我们不选 $u$:可以在其各个子树中自由选择反链,根据乘法原理,方案数为 $\prod_{v \in child(u)} dp[v]$。
• 如果我们选了 $u$:那么 $u$ 的所有子孙都不能被选,方案数为 $1$。
两者相加,即:$dp[u] = 1 + \prod_{v \in child(u)} dp[v]$。
若在树中存在一条没有分叉的长为 $L$ 的链(即连续 $L$ 个节点都只有一个子节点),且链底部的子树 DP 值乘积为 $D$,那么经过这 $L$ 个节点后,链顶部的 DP 值将恰好是 $L + D$。
### **3. 利用后缀自动机 (SAM) 压缩字典树**
由于 $s$ 的长度可达 $5 \times 10^5$,前缀字典树的节点数可能是 $O(\vert{}s\vert{}^2)$ 的,直接建树会超时超空间。
这里有一个经典结论:**字符串** $s$ **的前缀字典树,可以通过构建其反串** $s^R$ **的后缀自动机 (SAM) 的 Link Tree (Parent Tree) 来完美压缩**。
• 将 $s$ 反转得到 $s^R$,对 $s^R$ 建立后缀自动机。
• $s^R$ 的 SAM 的 Link Tree,其边代表在 $s^R$ 串前添加字符,也就等价于在原串 $s$ 后面添加字符。
• 因此,Link Tree 中的每一个节点 $u$,实际上代表了前缀字典树上的一条**没有分叉的链**。链上每个节点对应的子串,它们在原串 $s$ 中都有相同的起始位置 $B_u$。链上包含的字符串长度范围是 $[len(link(u)) + 1, len(u)]$。
### **4. KMP 结合 SAM 进行剪枝**
我们需要知道 SAM 中每一个节点 $u$ 所代表的那条链,有多少个节点是“有效”的(即不包含 $p$)。
1. 在建立 SAM 时,记录每个节点在 $s^R$ 中第一次出现的结束位置,以此可以推算出它在原串 $s$ 中的起始位置 $B_u$。
2. 使用 **KMP算法** 找出 $p$ 在原串 $s$ 中的所有出现位置。然后预处理出数组 `nxt[i]`,表示在原串 $s$ 中,**起点大于等于** $i$ **的最靠左的** $p$ **出现位置的终点索引**。
3. 对于 SAM 上的节点 $u$,它的字符串起点为 $B_u$。
◦ 如果 $p$ 在 $B_u$ 及其之后最早完整出现的地方,终点索引为 $E$(即 $E = nxt[B_u]$),那么任何起点为 $B_u$ 且长度 $\ge E - B_u + 1$ 的字符串都会包含 $p$。
◦ 意味着该链允许的最大有效长度为 $M_u = E - B_u$。如果 $B_u$ 后面根本没有出现过 $p$,则 $M_u = \infty$。
4. 节点 $u$ 原本代表长度从 $len(link(u)) + 1$ 到 $len(u)$ 的链,剪去非法部分后,链上剩下的**有效节点数量**即为:$\displaystyle C_u = \max(0, \min(len(u), M_u) - len(link(u)))$
# AC代码
::: 源代码
```cpp
```
:::
# 心路历程(WA,TLE,MLE……)